No capítulo anterior, filtrações passaram a registrar a informação disponível ao longo do tempo. A propriedade de Markov aparece quando o estado presente resume, para a previsão do futuro, toda a informação relevante do passado. Núcleos de transição dão a forma mensurável dessa ideia.
16.1 O presente como resumo do passado
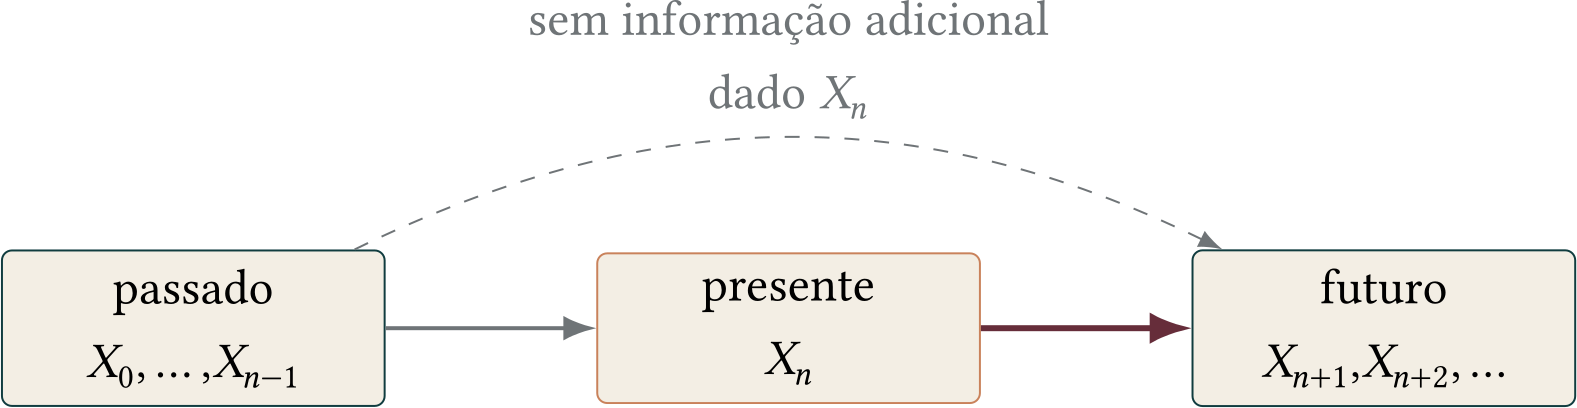
Se \(X=(X_n)_{n\geq 0}\) é adaptado a \((\mathcal{F}_n)\), toda a informação observada até o instante \(n\) está contida em \(\mathcal{F}_n\). A propriedade de Markov exige que, para prever o passo seguinte, essa informação possa ser substituída pelo estado \(X_n\).
Definição 16.1 (Núcleo de transição)
Um núcleo de transição em \((S,\mathcal S)\) é uma aplicação
\[ P:S\times \mathcal S\longrightarrow [0,1] \]
tal que:
para cada \(x\in S\), \(A\mapsto P(x,A)\) é uma medida de probabilidade em \((S,\mathcal S)\);
para cada \(A\in \mathcal S\), \(x\mapsto P(x,A)\) é mensurável.
O número \(P(x,A)\) é a probabilidade de o próximo estado pertencer a \(A\) quando o estado atual é \(x\). O núcleo atua tanto em funções quanto em medidas:
Se \(f\) é limitada e mensurável, então \(Pf\) também é limitada e mensurável. Além disso, \(P1=1\), \(P\) preserva positividade e \(\| Pf\| _\infty \leq \| f\| _\infty \).
Definição 16.2 (Processo de Markov homogêneo)
Um processo \(X=(X_n)_{n\geq 0}\), adaptado a \((\mathcal{F}_n)\) e com valores em \((S,\mathcal S)\), é um processo de Markov homogêneo com núcleo \(P\) se, para toda função mensurável limitada \(f:S\to \mathbb {R}\),
A igualdade não diz que o futuro é independente do passado. Ela afirma que a dependência relevante para a previsão é mediada pelo estado presente.
Figura16.1Na propriedade de Markov, o estado presente contém a informação do passado necessária para prever o futuro.
Exemplo 16.3 (Quando o estado guarda informação suficiente)
Se \(\xi _1,\xi _2,\ldots \) são i.i.d. com lei \(\nu \) e \(S_{n+1}=S_n+\xi _{n+1}\), então
\[ P(x,A)=\nu (A-x) \]
é o núcleo do passeio aleatório. Conhecido \(S_n\), a distribuição do próximo passo não depende de como o processo chegou a \(S_n\).
Em contraste, a sequência \(Y_n=\xi _n+\xi _{n-1}\) não precisa ser markoviana quando o estado observado é apenas \(Y_n\): o valor de \(\xi _n\), que influencia \(Y_{n+1}\), não é em geral recuperado de \(Y_n\). Ampliar o estado para \((\xi _{n-1},\xi _n)\) restaura a propriedade de Markov.
Esse exemplo contém uma regra de modelagem importante: a propriedade de Markov não é apenas uma característica do fenômeno, mas também da escolha do estado.
16.2 Cadeias e modelos com estado contínuo
Se \(S\) é finito ou enumerável, usa-se a notação
\[ p(x,y)=P(x,\{ y\} ). \]
A matriz \(P=(p(x,y))_{x,y\in S}\) é estocástica: seus elementos são não negativos e cada linha soma um. Nesse caso, processos de Markov são chamados cadeias de Markov.
Exemplo 16.4 (Um sistema com dois estados)
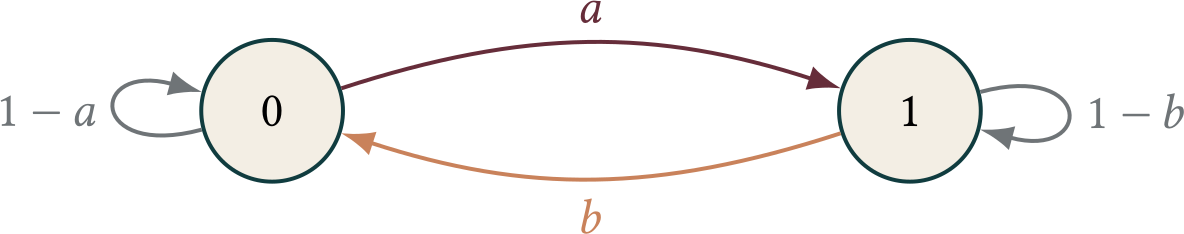
No espaço \(S=\{ 0,1\} \), a matriz de transição
\[ P=\begin{pmatrix} 1-a
& a
\\ b
& 1-b
\end{pmatrix}, \qquad 0\leq a,b\leq 1, \]
descreve uma cadeia em que, do estado \(0\), o sistema muda para \(1\) com probabilidade \(a\); do estado \(1\), retorna a \(0\) com probabilidade \(b\).
Figura16.2Grafo de transição de uma cadeia com dois estados.
Em espaços não enumeráveis, uma matriz não é adequada: a probabilidade de atingir um ponto específico pode ser zero. O núcleo substitui as linhas da matriz por medidas de probabilidade.
Exemplo 16.5 (Processo autorregressivo)
Se
\[ X_{n+1}=\varphi X_n+\varepsilon _{n+1}, \]
onde as inovações são i.i.d., independentes do passado e têm lei \(\nu \), o núcleo é
A fórmula resulta do condicionamento sucessivo em \(\mathcal{F}_{n-1},\ldots ,\mathcal{F}_0\) e de aplicações repetidas de (16.1) às funções indicadoras.
Nas condições do Teorema de Extensão de Kolmogorov da Seção 8.9, a recíproca também vale: uma lei inicial e um núcleo produzem, pela fórmula anterior, uma família consistente de leis finito-dimensionais, e a extensão constrói uma probabilidade no espaço de trajetórias \(S^{\mathbb N_0}\).
16.3 Composição de núcleos e Chapman–Kolmogorov
Se \(P\) e \(Q\) são núcleos em \((S,\mathcal S)\), sua composição é o núcleo
\[ PQ(x,A)=\int _S Q(y,A)P(x,\d y). \]
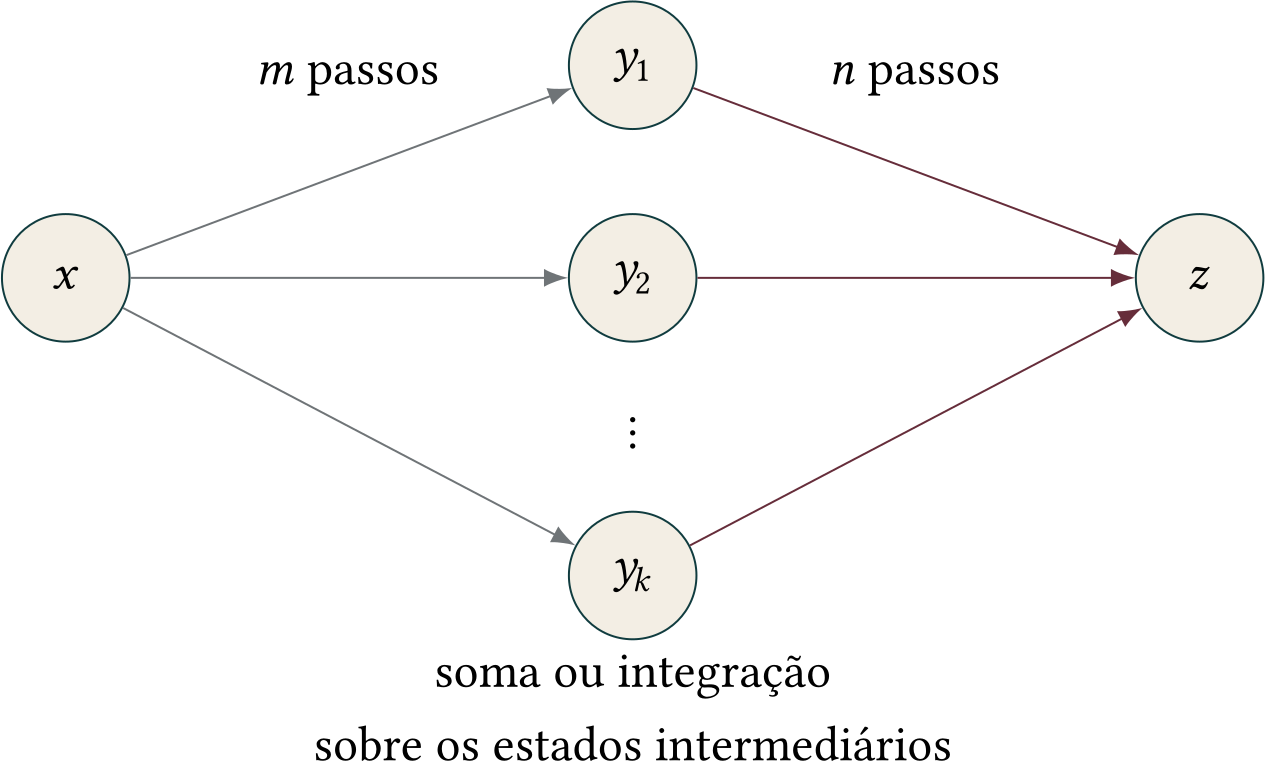
O núcleo \(P\) realiza o primeiro passo e \(Q\), o segundo. A composição é associativa. Com \(P^0=I\), onde \(I(x,A)=\mathbb {1}_A(x)\), as potências são dadas recursivamente por \(P^{n+1}=P^nP\).
Proposição 16.7 (Transições em vários passos)
Se \(X\) é markoviano com núcleo \(P\), então, para \(m,n\geq 0\) e \(f\) mensurável limitada,
\[ P_tf(x)=\int _{\mathbb {R}} f(y)p_t(x,y)\, \d y. \]
A convolução de uma normal de variância \(s\) com uma normal de variância \(t\) é normal de variância \(s+t\). Portanto,
\[ P_sP_t=P_{s+t}. \]
Esse é o semigrupo do movimento browniano: partindo de \(x\), a posição após tempo \(t\) tem distribuição \(\mathcal N(x,t)\). Além disso, para a filtração natural do movimento browniano e toda função mensurável limitada \(f\),
pois o incremento \(B_{s+t}-B_s\) é independente de \(\mathcal{F}_s^B\) e tem lei \(\mathcal N(0,t)\). A Proposição 14.20, aplicada a \(Y=B_s\) e \(Z=B_{s+t}-B_s\), fornece essa identidade.
Exemplo 16.11 (O semigrupo de Poisson)
Se \(N\) é um processo de Poisson de taxa \(\lambda \), então, para \(j\geq i\),
e a probabilidade é zero para \(j\lt i\). A identidade de semigrupo é a identidade de convolução para distribuições de Poisson independentes. Para a filtração natural,
porque o incremento \(N_{s+t}-N_s\) é independente de \(\mathcal{F}_s^N\) e tem distribuição \(\operatorname {Poisson}(\lambda t)\). Novamente, a Proposição 14.20 fornece a identidade.
Esses exemplos introduzem o tempo contínuo sem desenvolver ainda geradores, cadeias de salto ou equações diferenciais para semigrupos. O ponto aqui é a estrutura comum: evoluir por \(s\) unidades e depois por \(t\) equivale a evoluir por \(s+t\).
16.5 Distribuições invariantes
Uma lei inicial \(\pi \) é preservada pela dinâmica quando aplicar uma transição não a altera.
Definição 16.12 (Distribuição invariante)
Uma probabilidade \(\pi \) em \((S,\mathcal S)\) é invariante para o núcleo \(P\) se
\[ \pi P=\pi , \]
isto é,
\[ \pi (A)=\int _S P(x,A)\pi (\d x) \qquad \text{para todo }A\in \mathcal S. \]
No caso finito, tratando \(\pi \) como vetor-linha, a condição é \(\pi P=\pi \).
Proposição 16.13
Se \(X_0\sim \pi \) e \(\pi \) é invariante para \(P\), então \(X_n\sim \pi \) para todo \(n\). Mais ainda, as leis finito-dimensionais são invariantes por deslocamentos no tempo: o processo iniciado em \(\pi \) é estritamente estacionário, no sentido do capítulo anterior.
Demonstração▼
Por indução, a lei de \(X_n\) é \(\pi P^n=\pi \). Para as leis conjuntas, a fórmula das leis finito-dimensionais, combinada com a identidade \(\pi P^m=\pi \), permite deslocar todos os tempos por \(m\).
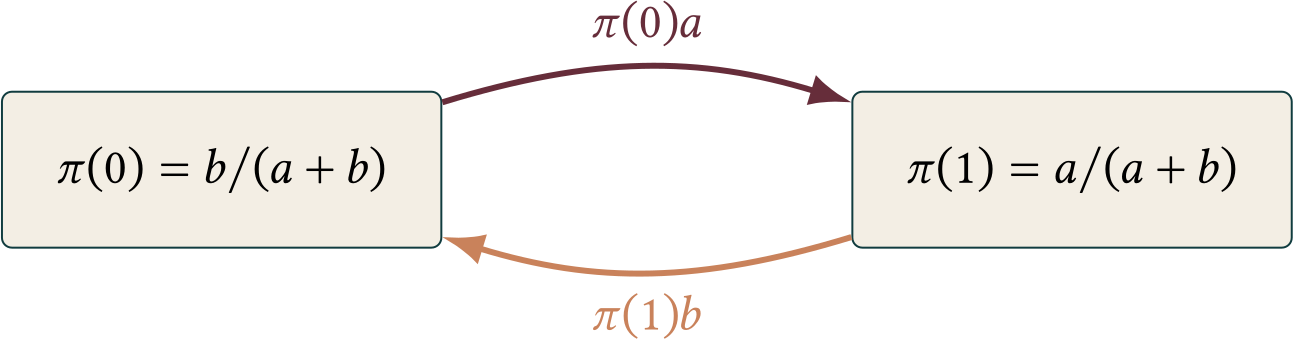
Exemplo 16.14 (Equilíbrio em dois estados)
Para \(a+b\gt 0\), a cadeia de dois estados possui distribuição invariante
A média continua sendo zero, e a normalidade é preservada por combinações lineares de gaussianas independentes.
Exemplo 16.16 (Modelo de Ehrenfest)
Há \(N\) partículas distribuídas entre duas urnas. A cada passo, uma partícula é escolhida uniformemente e transferida para a outra urna. Se \(X_n\) é o número de partículas na primeira urna, então
Mostre que a composição de dois núcleos de Markov é um núcleo de Markov.
Ver solução
Para cada \(x\), a integração de \(Q(y,\cdot )\) contra a probabilidade \(P(x,\d y)\) produz uma probabilidade. Para cada \(A\), a mensurabilidade de \(x\mapsto \int Q(y,A)P(x,\d y)\) segue primeiro para funções simples e depois por aproximação monótona.
Exercício 16.3
Considere a cadeia com matriz
\[ P=\begin{pmatrix} 1-a
& a
\\ b
& 1-b
\end{pmatrix}, \qquad 0\lt a,b\lt 1. \]
Calcule \(\P (X_n=1)\) em função de \(\P (X_0=1)\).
Ver solução
Se \(q_n=\P (X_n=1)\), então \(q_{n+1}=a+(1-a-b)q_n\). O ponto fixo é \(q_*=a/(a+b)\), portanto
\[ q_n=q_*+(1-a-b)^n(q_0-q_*). \]
Exercício 16.4
Se \(X_{n+1}=\varphi X_n+\varepsilon _{n+1}\), com inovações i.i.d. de lei \(\nu \), prove diretamente a propriedade de Markov em relação à filtração \(\mathcal{F}_n=\sigma \langle X_0,\varepsilon _1,\ldots ,\varepsilon _n\rangle \).
pois \(\varepsilon _{n+1}\) é independente de \(\mathcal{F}_n\). O último membro depende do passado apenas por \(X_n\).
Exercício 16.5
Para o passeio aleatório simples em \(\mathbb {Z}\), determine \(P^2(x,\{ y\} )\) e \(P^3(x,\{ y\} )\).
Ver solução
Em dois passos, as probabilidades são \(1/4,1/2,1/4\) para \(y=x-2,x,x+2\). Em três passos, são \(1/8,3/8,3/8,1/8\) para \(y=x-3,x-1,x+1,x+3\), respectivamente, e zero nos demais estados.
Exercício 16.6
Prove Chapman–Kolmogorov diretamente para o núcleo browniano usando a soma de duas variáveis normais independentes.
Ver solução
Se \(Y-x\sim \mathcal N(0,s)\) e, condicionalmente a \(Y\), \(Z-Y\sim \mathcal N(0,t)\) de forma independente, então \(Z-x=(Y-x)+(Z-Y)\sim \mathcal N(0,s+t)\). Logo
Se \(\pi \) é invariante para \(P\), prove que é invariante para \(P^n\) para todo \(n\geq 0\). Mostre também que qualquer combinação convexa de distribuições invariantes é invariante.
Ver solução
Por indução, \(\pi P^n=(\pi P^{n-1})P=\pi P=\pi \). Se \(\pi =\alpha \pi _1+(1-\alpha )\pi _2\), a linearidade dá \(\pi P=\alpha \pi _1P+(1-\alpha )\pi _2P=\pi \).
Exercício 16.8
Verifique detalhadamente que a distribuição binomial de parâmetro \(1/2\) é invariante para a cadeia de Ehrenfest. Interprete a distribuição diretamente no modelo das partículas.
Os fluxos entre estados vizinhos se equilibram, logo \(\pi P=\pi \). Se cada partícula escolhe independentemente uma das duas urnas com probabilidade \(1/2\), o número de partículas na primeira urna tem precisamente essa lei.
Exercício 16.9
Dê um exemplo de uma cadeia finita com mais de uma distribuição invariante e outro de uma cadeia com distribuição invariante única que não converge para ela a partir de todo estado inicial.
Ver solução
A matriz identidade tem toda distribuição como invariante. Para o segundo caso, tome a cadeia determinística que alterna entre \(0\) e \(1\): \(P(0,1)=P(1,0)=1\). A única invariante é \((1/2,1/2)\), mas, partindo de um estado fixo, as distribuições alternam e não convergem.
Exercício 16.10 (title=Passado e futuro condicionalmente independentes,difficulty=4)
Seja \((X_n)\) um processo de Markov homogêneo e fixe \(n\). Mostre que, dado \(X_n\), o passado \(\sigma \langle X_0,\ldots ,X_{n-1}\rangle \) e qualquer bloco futuro \(\sigma \langle X_{n+1},\ldots ,X_{n+r}\rangle \) são condicionalmente independentes. Prove a fatoração correspondente para funções limitadas do passado e do bloco futuro. Ver solução
Iterando a propriedade de Markov, existe função mensurável \(G_r\) tal que
Condicionando em \(\mathcal F_n\), o primeiro termo desaparece e o segundo tem esperança \(v(X_n)\), provando a segunda afirmação.
Exercício 16.12 (title=Grafos aleatórios: reamostragem local e reversibilidade,difficulty=3)
Considere a seguinte cadeia no conjunto dos grafos em \([n]\). Em cada passo, escolha uniformemente uma das \(N=\binom n2\) arestas potenciais e reamostre seu estado como Bernoulli\((p)\), independentemente do passado.
Mostre que essa dinâmica define uma cadeia de Markov.
Denote por \(\pi \) a lei \(G(n,p)\). Prove a identidade de balanço detalhado
\[ \pi (g)P(g,h)=\pi (h)P(h,g) \]
para todos os grafos \(g,h\).
Conclua que \(\pi \) é invariante.
Ver solução
O próximo estado depende do grafo atual apenas pela aresta escolhida e pelo novo Bernoulli, portanto a dinâmica é markoviana. Se \(g\) e \(h\) diferem em mais de uma aresta, ambos os lados do balanço são zero. Se diferem apenas em \(e\), com \(g_e=0\) e \(h_e=1\), então