Valor Esperado
O capítulo anterior descreveu a lei de uma variável aleatória. Agora queremos extrair dela algumas quantidades numéricas. A mais básica é a esperança, que associa à variável uma média de seus valores.
7.1 Esperança como integral
Considere, para motivar a definição, uma variável simples
com \(A_1,A_2,\ldots ,A_n\) disjuntos. Então a média ponderada \(m(\xi )\) dos valores que \(\xi \) assume é
Isso conduz à definição geral.
Usaremos aqui a mesma nomenclatura das integrais de Lebesgue. Diremos que \(\xi \) é integrável se \(\mathbf{E}|\xi |\lt \infty \), o que equivale a \(\mathbf{E}[\xi ^+]\lt \infty \) e \(\mathbf{E}[\xi ^-]\lt \infty \). Mais geralmente, a esperança de \(\xi \) está bem definida, possivelmente como \(+\infty \) ou \(-\infty \), se ao menos uma das quantidades \(\mathbf{E}[\xi ^+]\) e \(\mathbf{E}[\xi ^-]\) for finita; nesse caso, dizemos que \(\xi \) é quase integrável.
A definição recupera imediatamente o cálculo para variáveis simples.
Para uma variável aleatória simples \(\xi =\sum _{k=1}^n a_k\mathbb {1}_{A_k}\), com os \(A_k\) disjuntos,
O caso particular das indicadoras estabelece uma ligação direta entre esperança e probabilidade.
Em particular, para todo evento \(A\in \mathcal{F}\),
Definida pela integral de Lebesgue, a esperança herda as propriedades seguintes.
(Linearidade) \(\mathbf{E}[a\xi + b\eta ] = a\mathbf{E}[ \xi ] + b\mathbf{E}[ \eta ]\) para quaisquer números reais \(a, b\).
Se \(\xi \equiv b\in \mathbb {R}\), constante, então \(\mathbf{E}[\xi ] = b\) (escrevemos também que \(\mathbf{E}[b]=b\)).
Se \(\xi \geq 0\) então \(\mathbf{E}[ \xi ] \geq 0\).
(Monotonicidade) Se \(\xi \geq \eta \) então \(\mathbf{E}[ \xi ] \geq \mathbf{E}[ \eta ]\).
(Desigualdade triangular) \(\left\lvert \mathbf{E}[\xi ]\right\rvert \leq \mathbf{E}[\left\lvert \xi \right\rvert ]\)
Se \(0\leq \xi _n\uparrow \xi \), então \(\mathbf{E}[\xi ]=\lim _{n\to \infty }\mathbf{E}[\xi _n]\), admitindo-se o valor \(+\infty \).
Como \(\mathbf{E}[\xi ]=\int _\Omega \xi \, \d\P \), a linearidade para funções integráveis, a positividade, a monotonicidade, a desigualdade triangular e a convergência monótona são exatamente as propriedades da integral de Lebesgue demonstradas no capítulo anterior. Para explicitar o único ponto específico de uma probabilidade, se \(\xi \equiv b\), então \(\xi =b\mathbb {1}_\Omega \) e
Suponha que uma esfera seja colorida de modo que \(90\% \) de sua área seja vermelha e \(10\% \) seja azul, com a região vermelha mensurável. Fixe um cubo inscrito e escolha ao acaso uma rotação do cubo segundo a probabilidade uniforme — a medida de Haar normalizada — em \(SO(3)\). Para cada vértice \(v_i\) do cubo, sua imagem pela rotação é então uniformemente distribuída na esfera.
Seja \(\xi _i\) a indicadora de que o \(i\)-ésimo vértice cai na região vermelha. Então \(\mathbf{E}[\xi _i]=0{,}9\) para todo \(i\) e \(N=\xi _1+\cdots +\xi _8\) é o número de vértices vermelhos. Por linearidade da esperança,
Se toda rotação tivesse no máximo sete vértices vermelhos, teríamos \(N\leq 7\) quase certamente e, portanto, \(\mathbf{E}[N]\leq 7\), uma contradição. Logo existe uma rotação para a qual os oito vértices estão em pontos vermelhos da esfera.
Esse é um exemplo da utilização de técnicas probabilísticas para provar fatos determinísticos. Observe que não exigimos que as variáveis \(\xi _i\) sejam independentes.
Temos também a seguinte caracterização do operador esperança.
continuidade na norma de \(\L ^1\): se \(\| \xi _n-\xi \| _1\to 0\), então \(T(\xi _n)\to T(\xi )\);
relação com a probabilidade: \(T(\mathbb {1}_A)=\P (A)\) para todo \(A\in \mathcal{F}\).
O operador \(\xi \mapsto \int _\Omega \xi \, \d\P \) é linear, \(|\mathbf{E}[\xi ]|\leq \| \xi \| _1\) e \(\mathbf{E}[\mathbb {1}_A]=\P (A)\); portanto, possui as propriedades anunciadas.
Reciprocamente, seja \(T\) um operador com essas propriedades. Se \(s=\sum _{j=1}^m a_j\mathbb {1}_{A_j}\) é simples, a linearidade e a condição sobre indicadoras dão
As funções simples são densas em \(\L ^1\): para \(\xi \in \L ^1\), escolha simples \(s_n\) com \(\| s_n-\xi \| _1\to 0\). Pela continuidade de \(T\) e pela estimativa \(|\mathbf{E}[s_n-\xi ]|\leq \| s_n-\xi \| _1\),
Isso prova a unicidade.
Como já vimos, uma propriedade que falha apenas num evento de probabilidade zero vale quase certamente, abreviado por q.c. A integral de Lebesgue ignora conjuntos nulos; a esperança, portanto, respeita naturalmente essa identificação.
Se \(\xi =0\ q.c\) então \(\mathbf{E}[\xi ]=0\);
Se \(\xi =\eta \ q.c\) e \(\xi \) é integrável ou \(\mathbf{E}[\xi ]=\pm \infty \), então \(\mathbf{E}[\eta ]=\mathbf{E}[\xi ]\);
Se \(\xi \leq \eta \ q.c.\) e \(\eta \) é integrável, então \(\mathbf{E}[\xi ]\leq \mathbf{E}[\eta ]\) (\(\mathbf{E}[\xi ]\) pode ser \(-\infty \)) .
Se \(\xi \geq 0\) e \(\mathbf{E}[\xi ]=0\), então \(\xi =0\ q.c.\).
Como \(\xi ^+=\xi ^-=0\) quase certamente, ambas as integrais são nulas e, portanto, \(\mathbf{E}[\xi ]=0\).
Da igualdade quase certa seguem \(\xi ^+=\eta ^+\) e \(\xi ^-=\eta ^-\) quase certamente. As integrais das partes positiva e negativa coincidem; logo a existência e o valor da esperança de \(\eta \) são os mesmos que os de \(\xi \).
Defina
\[ \xi ^*=\xi \mathbb {1}_{\{ \xi \leq \eta \} }+\eta \mathbb {1}_{\{ \xi \gt \eta \} }. \]Então \(\xi ^*=\xi \) quase certamente e \(\xi ^*\leq \eta \) em todo ponto. Além disso, \((\xi ^*)^+\leq \eta ^+\), de modo que a parte positiva de \(\xi ^*\) é integrável. Por monotonicidade, \(\mathbf{E}[\xi ]=\mathbf{E}[\xi ^*]\leq \mathbf{E}[\eta ]\), admitindo-se o valor \(-\infty \).
Dado \(\epsilon \gt 0\), defina \(\eta _\epsilon =\epsilon \mathbb {1}_{\{ \xi \gt \epsilon \} }\) e observe que \(\eta _\epsilon \leq \xi \) para todo \(\epsilon \gt 0\). Segue que
\[ \epsilon \P (\xi \gt \epsilon )=\mathbf{E}[\eta _\epsilon ]\leq \mathbf{E}[\xi ]=0, \]e portanto \(\P (\xi \gt \epsilon )=0\) para todo \(\epsilon \gt 0\).
Como \(\{ \xi \gt 0\} =\bigcup _{n\geq 1}\{ \xi \gt 1/n\} \), concluímos que \(\P (\xi \gt 0)=0\). Como \(\xi \geq 0\), segue que \(\xi =0\) quase certamente.
7.2 Esperança e distribuição
A definição \(\mathbf{E}[\xi ]=\int _\Omega \xi \, \d\P \) parece depender do espaço amostral. Para calcular a esperança, porém, a informação relevante é apenas a distribuição de \(\xi \). Esse fato é uma manifestação geral da integração por uma medida imagem.
Para uma função simples não negativa
a definição da distribuição induzida dá
Se \(\varphi \geq 0\) é mensurável, escolha funções simples \(\varphi _n\uparrow \varphi \) e aplique o Teorema da Convergência Monótona aos dois lados. Para uma função mensurável arbitrária, aplique o caso não negativo a \(\varphi ^+\) e \(\varphi ^-\). A escolha \(\varphi (x)=x\) fornece a última identidade.
As distribuições de \(\xi \) e \(\eta \) coincidem. Basta aplicar o Teorema 7.6 a \(\varphi \) e, para a integrabilidade, a \(x\mapsto |x|\).
7.2.1 Variáveis aleatórias discretas
Se \(\xi \) assume valores num conjunto enumerável \(S=\{ x_1,x_2,\ldots \} \), sua distribuição é determinada pelas massas \(p_k=\P (\xi =x_k)\). Integrar em relação a essa distribuição significa somar com esses pesos.
A distribuição de \(\xi \) é
A fórmula segue do Teorema 7.6; para funções não negativas, a soma é entendida como limite das somas parciais. No caso integrável, a série é absolutamente convergente porque
7.2.2 Variáveis aleatórias absolutamente contínuas
Se a distribuição de \(\xi \) possui densidade \(f\), a medida \(\P _\xi \) é dada por \(f\, \d\lambda \). O teorema anterior assume então sua forma mais familiar.
Pelo Teorema 7.6,
Como \(\P _\xi (A)=\int _A f\, \d\lambda \), a integral em relação a \(\P _\xi \) é exatamente a integral de \(\varphi f\) em relação à medida de Lebesgue.
7.2.3 Vetores aleatórios
Nada no argumento anterior é peculiar à reta. Se \(X=(X_1,\ldots ,X_n)\) é um vetor aleatório, sua distribuição conjunta \(\P _X\) é uma probabilidade em \(\mathbb {R}^n\). As distribuições marginais são obtidas por projeção; por exemplo,
As marginais, em geral, não determinam a distribuição conjunta.
É o mesmo argumento do Teorema 7.6, agora para a medida imagem \(\P _X\) em \(\mathbb {R}^n\).
Se \(X_1,\ldots ,X_n\) são discretas, com valores em \(S_1,\ldots ,S_n\), então
Se, por outro lado, o vetor \(X\) possui densidade conjunta \(f:\mathbb {R}^n\to [0,\infty )\), então
Ter densidade para cada coordenada separadamente não garante a existência de uma densidade conjunta.
7.2.4 Integração em relação à função de distribuição
Uma função de distribuição \(F\) determina uma única probabilidade \(\P _F\) em \((\mathbb {R},\mathcal B(\mathbb {R}))\) tal que
De fato, a existência segue da construção de uma variável com função de distribuição prescrita, e a unicidade segue porque os intervalos \((-\infty ,x]\) geram \(\mathcal B(\mathbb {R})\).
A medida \(\P _F\) é a medida atômica \(\sum _i p_i\delta _{t_i}\).
Nesse caso, \(\P _F=f\, \d\lambda \).
Com essa notação, o Teorema 7.6 pode ser escrito de forma compacta como
7.3 Momentos, variância e covariância
A esperança fornece um centro, mas não descreve sozinha a forma da distribuição. Os momentos registram outras escalas; a variância mede a dispersão quadrática em torno da média; a covariância compara as flutuações de duas variáveis.
Dado \(n\in \mathbb {N}\) e \(\xi \in \L ^n(\P )\),
\[ m_k:=\mathbf{E}[\xi ^k], \qquad M_k:=\mathbf{E}[|\xi |^k], \qquad k=1,\dots ,n, \]são denominados, respectivamente, o \(k\)-ésimo momento e o \(k\)-ésimo momento absoluto de \(\xi \).
Se \(\xi \in \L ^2(\P )\), então
\[ \operatorname {Var}[\xi ]:=\mathbf{E}[(\xi -\mathbf{E}[\xi ])^2] \]é a variância de \(\xi \). O número \(\sigma :=\sqrt{\operatorname {Var}[\xi ]}\) é denominado desvio padrão de \(\xi \).
Se \(\xi ,\eta \in \L ^2(\P )\), definimos a covariância por
\[ \operatorname {Cov}[\xi ,\eta ]:=\mathbf{E}\left[(\xi -\mathbf{E}[\xi ])(\eta -\mathbf{E}[\eta ])\right] \]As variáveis \(\xi \) e \(\eta \) são ditas não correlacionadas se \(\operatorname {Cov}[\xi ,\eta ]=0\).
Se \(\xi \) e \(\eta \) não são quase certamente constantes, seu coeficiente de correlação é
\[ \rho (\xi ,\eta )= \frac{\operatorname {Cov}(\xi ,\eta )}{\sigma _\xi \sigma _\eta }. \]
A expressão da variância deve ser lida como uma distância quadrática média à esperança. Para cada resultado \(\omega \), o desvio \(\xi (\omega )-\mathbf{E}[\xi ]\) indica quanto o valor observado ficou acima ou abaixo do centro. Se simplesmente fizéssemos a média desses desvios, os positivos e negativos se cancelariam. Ao elevá-los ao quadrado, todos passam a contribuir positivamente e os afastamentos maiores recebem peso maior.
Assim, variância pequena significa que a distribuição está fortemente concentrada em torno da média, enquanto variância grande indica maior dispersão. Como o quadrado também eleva ao quadrado a unidade de medida, o desvio padrão \(\sqrt{\operatorname {Var}[\xi ]}\) costuma ser mais fácil de interpretar: ele mede a dispersão na mesma unidade de \(\xi \).
\(\operatorname {Var}[\xi ]\geq 0\)
\(\operatorname {Var}[\xi ] = \mathbf{E}[\xi ^2] - \mathbf{E}[\xi ]^2\).
\(\operatorname {Var}[\xi ] = 0 \Longleftrightarrow \xi = \mathbf{E}[\xi ]\) quase certamente.
A aplicação \(f : \mathbb {R}\to \mathbb {R}\), \(x \longmapsto \mathbf{E}[(\xi - x)^2 ]\) tem um mínimo em \(\mathbf{E}[\xi ]\) com \(f(\mathbf{E}[\xi ]) = \operatorname {Var}[\xi ]\).
\(\operatorname {Var}[a\xi +b]=a^2\operatorname {Var}[\xi ]\) para \(a,b\in \mathbb {R}\).
\(\operatorname {Cov}[\xi ,\eta ]=\mathbf{E}[\xi \eta ]-\mathbf{E}[\xi ]\mathbf{E}[\eta ]\).
\(\operatorname {Var}[\xi +\eta ]=\operatorname {Var}[\xi ]+\operatorname {Var}[\eta ]+2\operatorname {Cov}[\xi ,\eta ]\).
\(\operatorname {Cov}[\xi ,\xi ]=\operatorname {Var}[\xi ]\).
Segue da definição, pois \((\xi -\mathbf{E}[\xi ])^2\geq 0\).
Segue da linearidade da esperança. De fato
\begin{align*} \operatorname {Var}[\xi ]& =\mathbf{E}[(\xi -\mathbf{E}[\xi ])^2]\\ & =\mathbf{E}[\xi ^2]-2\mathbf{E}[\xi ]^2+\mathbf{E}[\xi ]^2\\ & =\mathbf{E}[\xi ^2]-\mathbf{E}[\xi ]^2. \end{align*}Se \(\operatorname {Var}[\xi ]=0\), a variável não negativa \((\xi -\mathbf{E}[\xi ])^2\) tem esperança nula; logo é nula quase certamente. A recíproca é imediata.
A identidade
\[ \mathbf{E}[(\xi -x)^2] =\operatorname {Var}[\xi ]+(x-\mathbf{E}[\xi ])^2 \]mostra que o mínimo é atingido em \(x=\mathbf{E}[\xi ]\) e vale \(\operatorname {Var}[\xi ]\).
Como \(a\xi +b-\mathbf{E}[a\xi +b]=a(\xi -\mathbf{E}[\xi ])\), temos \(\operatorname {Var}[a\xi +b]=a^2\operatorname {Var}[\xi ]\).
Segue da linearidade da esperança que
\begin{align*} \operatorname {Cov}[\xi ,\eta ]& =\mathbf{E}[(\xi -\mathbf{E}[\xi ])(\eta -\mathbf{E}[\eta ])]\\ & =\mathbf{E}[\xi \eta ]-\mathbf{E}[\xi ]\mathbf{E}[\eta ]. \end{align*}Segue da linearidade da esperança e dos itens anteriores que
\begin{align*} \operatorname {Var}(\xi +\eta ) & =\mathbf{E}[\xi ^2]+\mathbf{E}[\eta ^2]+2\mathbf{E}[\xi \eta ] -\mathbf{E}[\xi ]^2-\mathbf{E}[\eta ]^2-2\mathbf{E}[\xi ]\mathbf{E}[\eta ]\\ & =\operatorname {Var}[\xi ]+\operatorname {Var}[\eta ]+2\operatorname {Cov}[\xi ,\eta ]. \end{align*}Segue direto da definição.
O item 4 dá uma interpretação geométrica simples. Entre todas as constantes \(x\), a esperança é aquela que minimiza o erro quadrático médio \(\mathbf{E}[(\xi -x)^2]\); a variância é precisamente o valor mínimo desse erro.
Seja \(\xi \in \L ^2(\P )\) com \(\operatorname {Var}[\xi ]\gt 0\) e seja \(\eta =aX+b\), com \(a\neq 0\). Temos então \(\mathbf{E}[\eta ]=a\mathbf{E}[\xi ]+b\) e \(\operatorname {Var}[\eta ]=a^2\operatorname {Var}[\xi ]\).
Da mesma forma temos que \(\operatorname {Cov}[\xi ,\eta ]=\mathbf{E}[(\xi -\mathbf{E}[\xi ])(aX+b-(a\mathbf{E}[\xi ]+b))]=a\operatorname {Var}[\xi ].\)
Segue que
A covariância e a correlação registram a associação linear entre as variáveis. Nesse exemplo, vemos que, se \(\eta =aX+b\), então \(\operatorname {Cov}[\xi ,\eta ]\) tem o mesmo sinal de \(a\) e \(\rho (\xi ,\eta )\) é \(1\) ou \(-1\), de acordo com o sinal de \(a\).
Suponha primeiro que \(\xi \) e \(\eta \) sejam simples, com valores \(x_1,\ldots ,x_n\) e \(y_1,\ldots ,y_m\). Então
Se \(\xi ,\eta \geq 0\), escolha funções simples \(\xi _n\uparrow \xi \) e \(\eta _n\uparrow \eta \), obtidas por transformações mensuráveis separadas. A independência é preservada e \(\xi _n\eta _n\uparrow \xi \eta \). Pela Convergência Monótona,
Aplicando esse caso a \(|\xi |\) e \(|\eta |\), obtemos \(\mathbf{E}|\xi \eta |=\mathbf{E}|\xi |\, \mathbf{E}|\eta |\lt \infty \). Por fim, decomponha \(\xi \) e \(\eta \) em partes positiva e negativa e use a linearidade. Se ambas pertencem a \(\L ^2\), a fórmula da covariância dá \(\operatorname {Cov}[\xi ,\eta ]=0\).
Vimos assim que variáveis aleatórias independentes têm covariância nula, quando possuem segundo momento finito. A recíproca não é verdadeira, como mostra o Exercício 7.20, ao final do capítulo.
Para somas de variáveis independentes, a covariância desaparece e as variâncias se somam.
Para \(n=2\) temos
Os demais casos seguem por indução, pois \(\xi _1+\cdots +\xi _{n-1}\) é independente de \(\xi _n\).
Se \(\widetilde\xi =\xi -\mathbf{E}[\xi ]\) e \(\widetilde\eta =\eta -\mathbf{E}[\eta ]\), então \(\operatorname {Cov}[\xi ,\eta ]=\mathbf{E}[\widetilde\xi \widetilde\eta ]\). A linearidade em cada entrada e a simetria seguem da linearidade da esperança e do produto. Além disso,
de modo que a forma é positiva semidefinida. Se \(\eta =c\) quase certamente, então \(\widetilde\eta =0\) quase certamente e \(\operatorname {Cov}[\xi ,\eta ]=0\).
Aplicando Hölder, Teorema 5.18, com \(p=q=2\) às variáveis centradas
obtemos
Para o caso de igualdade, se \(\operatorname {Var}[\eta ]=0\), então \(\eta \) é constante quase certamente e a dependência afim é imediata. Se \(\operatorname {Var}[\eta ]\gt 0\), ponha
Então
Logo há igualdade se, e somente se, \(\operatorname {Var}[\xi +\theta \eta ]=0\), isto é, se \(\xi +\theta \eta \) é constante quase certamente. Isso equivale à existência de \(a,b,c\in \mathbb {R}\), não todos nulos, com \(a\xi +b\eta +c=0\) quase certamente; a recíproca é imediata.
Divida a desigualdade de Cauchy–Schwarz por \(\operatorname {Var}[\xi ]\operatorname {Var}[\eta ]\gt 0\) e use sua caracterização do caso de igualdade.
Comecemos com \(\xi \) simples. Liste seus valores positivos distintos como
e ponha \(a_0=0\). Então
Logo
Por outro lado, para \(a_{j-1}\leq t\lt a_j\),
e portanto a integral das caudas é exatamente a mesma soma.
Para \(\xi \) mensurável não negativa, escolha funções simples \(0\leq \xi _n\uparrow \xi \), como na Proposição 5.2. Pela convergência monótona,
Para cada \(t\geq 0\), os eventos \(\{ \xi _n\gt t\} \) crescem para \(\{ \xi \gt t\} \), de modo que
Aplicando novamente a convergência monótona, agora à medida de Lebesgue em \([0,\infty )\),
Como a identidade vale para cada \(\xi _n\), vale também para \(\xi \).
A fórmula também admite, depois de Tonelli, uma demonstração estrutural de uma linha; ela reaparecerá como exercício no capítulo de medida produto.
7.4 Desigualdades de cauda
Momentos fornecem informação sobre a distribuição mesmo quando não conhecemos sua forma explícita. As desigualdades desta seção convertem essa informação em cotas para probabilidades de cauda.
Como
a monotonicidade da esperança fornece
A mesma ideia pode ser aplicada depois de transformar a variável.
No evento \(\{ |\xi |\geq t\} \),
Logo
e basta tomar esperanças.
Aplique a desigualdade de Markov generalizada a \(\varphi (x)=x^p\).
Essa estimativa também mostra que, se \(\xi \in L^q\) e \(q\gt p\gt 0\), então
De fato, o controle com o momento de ordem \(q\) fornece uma potência extra de \(t\) no denominador.
Aplique o corolário anterior, com \(p=2\), à variável \(\xi -\mu \). Como
a primeira desigualdade segue imediatamente; a segunda é apenas uma reescrita na escala do desvio padrão.
Considere o experimento de lançar uma moeda de maneira sequencial e independente. Para cada \(n\geq 1\), defina \(\xi _n\) como a indicadora de que observamos cara no \(n\)-ésimo lançamento. Suponha que em um lançamento da moeda, a probabilidade de observar cara é \(p\in (0,1)\).
Com isso temos que as variáveis \(\xi _1, \xi _2,\ldots \) são independentes com \(\mathbf{E}[\xi _n]=p\) e \(\operatorname {Var}[\xi _n]=p(1-p)\).
Queremos medir a proporção de caras observadas em \(n\) lançamentos, e para isso definiremos \(S_n=\xi _1+\cdots +\xi _n\). Isto é, \(S_n\) é o total de caras observadas em \(n\) lançamentos.
Segue assim que
e, como \(\xi _1,\ldots ,\xi _n\) são independentes,
Tome agora \(\epsilon \gt 0\) pequeno e note que
Concluímos assim que
quando \(n\to \infty \), para todo \(\epsilon \gt 0\).
7.5 ↯Funções Geradoras de Probabilidade
Considere uma variável aleatória \( \xi \), tomando valores nos naturais. Seja \( p_r = \P (\xi = r) \).
Observamos que função geradora de probabilidade é uma série de potência e converge absolutamente para \( | z | \leq 1 \), pois
A função geradora reúne as probabilidades nos coeficientes de uma série. Sua utilidade aparece quando operações sobre variáveis se traduzem em operações algébricas sobre essas funções.
Para \(\xi \sim \operatorname {Poisson}(\lambda )\), a soma da série dá
Retornaremos a essa expressão depois de relacionar as derivadas de \(p\) aos momentos fatoriais.
No interior do intervalo de convergência, podemos diferenciar a série termo a termo. Assim,
Logo \(p_n=p^{(n)}(0)/n!\) para todo \(n\geq 0\), e recuperamos toda a distribuição.
Para \(0\lt z\lt 1\), a diferenciação termo a termo dá
Quando \(z\uparrow 1\), cada parcela cresce para \(rp_r\). Pelo Teorema da Convergência Monótona aplicado à medida de contagem em \(\mathbb {N}\),
A última afirmação é imediata da continuidade em \(1\).
Para \(0\lt z\lt 1\),
As parcelas são não negativas e crescem quando \(z\uparrow 1\). A Convergência Monótona fornece
Se \( \xi \) e \( \eta \) forem variáveis aleatórias de Poisson independentes com parâmetros \( \lambda , \mu \) respectivamente, então
Portanto, \( \xi + \eta \sim \operatorname {Poisson}(\lambda + \mu ) \).
Também podemos fazê-lo diretamente:
mas é muito mais complicado.
Somas de um número aleatório de termos
As funções geradoras também permitem estudar somas cujo número de parcelas é aleatório. Numa seguradora, por exemplo, tanto o número de pedidos de indenização quanto o valor de cada pedido podem variar. A soma reúne as duas fontes de aleatoriedade.
Sejam \(\xi _1,\xi _2,\ldots \) variáveis aleatórias i.i.d. com valores em \(\mathbb {N}\) e função geradora
Seja \(N\), também com valores em \(\mathbb {N}\), independente de todas as \(\xi _i\), e denote por \(h\) sua função geradora. Para
com \(S=0\) quando \(N=0\), decompomos segundo os eventos \(\{ N=n\} \):
A independência de \(N\) e das parcelas é exatamente o que permite separar o segundo membro.
Quando os momentos necessários são finitos, derivar em \(z=1\) fornece
e
7.6 ↯Processos de Ramificação
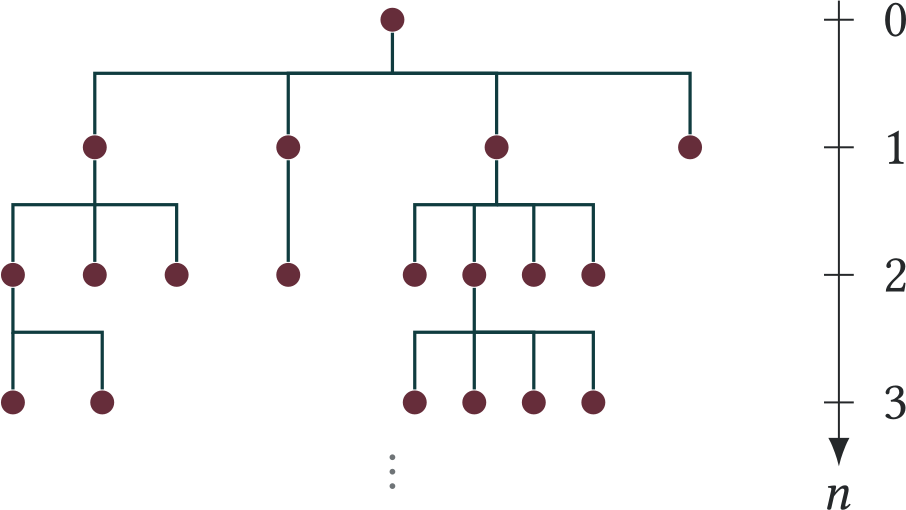
Processos de ramificação são uma das aplicações mais naturais das funções geradoras. O modelo clássico de Galton–Watson descreve uma população em que cada indivíduo produz um número aleatório de descendentes segundo a mesma lei, independentemente dos demais. Historicamente, o problema foi motivado pelo desaparecimento de sobrenomes; matematicamente, a mesma estrutura aparece em populações, epidemias e árvores aleatórias.
Se \(\xi _n\) denota o tamanho da \(n\)-ésima geração, partimos de um único indivíduo e supomos:
\( \xi _0 = 1 \)
Cada indivíduo vive por uma unidade de tempo e produz \( k \) descendentes com probabilidade \( p_k \).
Os números de descendentes de indivíduos distintos e de gerações distintas são independentes. Assim,
\[ \xi _{n + 1} = \eta _1 ^n + \eta _2 ^n + \cdots + \eta _{\xi _n} ^n, \]onde as variáveis \(\eta _i^n\) são independentes, identicamente distribuídas como \(\xi _1\) e independentes da história até a geração \(n\).
A função geradora transforma a recorrência do processo de ramificação numa relação de composição. Seja \( F (z) \) a função geradora de probabilidade de \( \eta _i ^n \). Então
Definimos
O principal teorema dos processos de ramificação que provaremos nesta seção é
Decompondo segundo os eventos \(\{ \xi _n=k\} \),
A segunda igualdade usa que as descendências da geração seguinte são independentes do evento \(\{ \xi _n=k\} \); a terceira usa a independência entre os \(k\) indivíduos.
Como \(F_0\) é a identidade, a recorrência mostra por indução que \(F_n=F^{\circ n}\). Assim,
Ponha
No evento \(A_k\),
Como as variáveis de descendência são independentes de \(A_k\) e têm média \(\mu \),
Com \(\xi _0=1\), obtemos
Para o segundo momento, a soma de \(k\) cópias independentes de \(\xi _1\) possui variância \(k\sigma ^2\) e média \(k\mu \); portanto
Decompondo novamente segundo os eventos \(A_k\),
Escrevendo \(V_n=\operatorname {Var}(\xi _n)\) e usando \(\mathbf{E}[\xi _{n-1}]=\mu ^{n-1}\),
Uma indução fornece
Probabilidade de Extinção
Considere \(A_n=\{ \xi _n=0\} \), o evento de que a população já esteja extinta na \(n\)-ésima geração. Seja \(q\) a probabilidade de extinção eventual e
Como \( A_1 \subseteq A_2 \subseteq A_3 \subseteq \cdots \), sabemos que
Como
e \(F\) é contínua em \([0,1]\), temos
assim
A mesma equação pode ser obtida decompondo o evento de extinção segundo o número de indivíduos da primeira geração. Se \(A\) é o evento de extinção eventual, então
pois as \(k\) linhagens descendentes evoluem independentemente e cada uma se extingue com probabilidade \(q\). Somando em \(k\),
Isso significa que para encontrar a probabilidade de extinção, precisamos encontrar um ponto fixo de \( F \).
Se \(\mu \leq 1\) e \(\P (\xi _1=1)\lt 1\), então \(q=1\).
Se \(\mu \gt 1\), então \(q\lt 1\).
No caso degenerado \(\P (\xi _1=1)=1\), temos \(q=0\).
Já vimos que \(F(q)=q\). Se \(\alpha \in [0,1]\) é qualquer outro ponto fixo, então \(F_0(0)=0\leq \alpha \) e, pela monotonicidade de \(F\), \(F_{n+1}(0)=F(F_n(0))\leq F(\alpha )=\alpha \). Portanto,
e \(q\) é o menor ponto fixo.
A função \(G(s)=F(s)-s\) é convexa, \(G(1)=0\) e \(F'(1-)=\mu \). Se \(\mu \leq 1\), a convexidade dá, para \(s\lt 1\),
de modo que \(F(s)\geq s\). Se houvesse igualdade para algum \(s\lt 1\), a convexidade e a igualdade das inclinações forçariam \(F(t)=t\) em \([s,1]\); pela identidade de séries de potências, isso significaria \(F(t)=t\) em todo \((-1,1)\), isto é, \(\P (\xi _1=1)=1\). Fora desse caso degenerado, não há ponto fixo abaixo de \(1\), e portanto \(q=1\).
Se \(\mu \gt 1\), então \(G'(1-)\gt 0\) e, consequentemente, \(G(s)\lt 0\) para \(s\lt 1\) suficientemente próximo de \(1\). Como \(G(0)=F(0)\geq 0\), a continuidade fornece um ponto fixo em \([0,1)\); logo o menor deles satisfaz \(q\lt 1\). Finalmente, no caso degenerado \(\P (\xi _1=1)=1\), temos \(F(s)=s\) para todo \(s\); cada indivíduo tem exatamente um descendente e a população nunca se extingue, de modo que \(q=0\).
7.7 ↯Funções Geradoras de Momento
A função geradora de momentos de \(\xi \) é
desde que essa esperança seja finita para todo \(t\) em algum intervalo \((-h,h)\), com \(h\gt 0\).
Para variáveis discretas ou absolutamente contínuas temos que
Fixe \(t\) com \(|t|\lt h\) e escolha \(\delta \gt 0\) tal que \(|t|+2\delta \lt h\). Existe \(C_{n,\delta }\) tal que \(|x|^n\leq C_{n,\delta }\mathrm e^{\delta |x|}\). Para \(s\) numa vizinhança suficientemente pequena de \(t\),
O lado direito é integrável pela hipótese sobre \(M_\xi \). O teorema de diferenciação sob o sinal de integral, obtido da Convergência Dominada, pode então ser aplicado sucessivamente e fornece a fórmula.
A demonstração usa continuação analítica e a unicidade da transformada de Fourier, ferramentas que serão desenvolvidas no Capítulo 12. Voltaremos então a este resultado e o provaremos após o Teorema da Unicidade de Fourier.
Completando o quadrado:
Então voltando ao cálculo da função geradora de momento
Calculamos a função geradora de momento da soma usando o teorema sobre somas de variáveis aleatórias independentes.
Essa é a função geradora de momentos de \(\mathcal N(\mu _1+\mu _2,\sigma _1^2+\sigma _2^2)\). Pelo Teorema 7.44, as distribuições coincidem.
7.8 ↯Entropia
A esperança também pode resumir quantidades que não são observações físicas da variável. Em teoria da informação, associa-se a um evento de probabilidade \(p\) uma quantidade \(I(p)\) que mede quão informativa é sua ocorrência. Eventos raros devem carregar mais informação; eventos certos, nenhuma. A forma dessa função é praticamente forçada por quatro propriedades.
Uma medida de informação é uma função \(I:(0,1]\to [0,\infty )\) com as seguintes propriedades:
A informação é uma quantidade não negativa: \( I (p) \ge 0 \).
Se um evento tiver probabilidade 1, não obtemos informações da ocorrência do evento: \( I (1) = 0 \).
Se ocorrerem dois eventos independentes (cuja probabilidade conjunta é o produto de suas probabilidades individuais), então a informação que obtemos ao observar os eventos é a soma das duas informações: \( I (p_1 \cdot p_2) = I (p_1) + I (p_2). \) (Esta é a propriedade fundamental)
A medida de informação depende continuamente da probabilidade.
Essas propriedades determinam a forma de \(I\). De fato, defina \(J(x)=I(\mathrm e^{-x})\) para \(x\geq 0\). Então \(J\) é contínua, não negativa e
A equação aditiva contínua em \([0,\infty )\) implica \(J(x)=cx\) para alguma constante \(c\geq 0\). Logo
Se a informação não for identicamente nula, então \(c\gt 0\) e podemos escolher uma base \(b\gt 1\) de modo que
A escolha da base determina apenas a unidade de informação.
Normalmente, pensamos em termos de \( \log _2 (p) \).
Com logaritmos na base \(2\), um lançamento de uma moeda justa fornece \(-\log _2(1/2)=1\) bit; \(n\) lançamentos independentes fornecem \(n\) bits.
Entropia
Se uma variável aleatória discreta \(X\) assume os valores \(a_1,\ldots ,a_n\) com probabilidades \(p_1,\ldots ,p_n\), a informação observada quando \(X=a_i\) é
Sua média é, portanto,
Essa média é a entropia.
Se \(X\) tem função de massa \(p\), escrevemos
Assim, a entropia é literalmente o valor esperado da informação contida na observação.
Há uma expressão formalmente análoga para distribuições absolutamente contínuas com densidade \(f\),
quando a integral está bem definida. Essa entropia diferencial pode ser negativa e muda sob transformações de escala; por isso não deve ser confundida com a entropia discreta.
Considere as distribuições de probabilidade, \( P = \{ p_1, p_2, \ldots , p_n \} \) e \( Q = \{ q_1, q_2, \ldots , q_n \} \), onde \( p_i, q_i \ge 0 \) e \( \sum _i p_i = \sum _i q_i = 1 \). Então
com as convenções \(0\log 0=0\) e \(-p_i\log q_i=+\infty \) se \(p_i\gt 0=q_i\). A igualdade ocorre se, e somente se, \(p_i=q_i\) para todo \(i\).
Se existe \(i\) com \(p_i\gt 0=q_i\), o lado esquerdo é infinito e a desigualdade é imediata. Caso contrário, omitimos os índices com \(p_i=0\) e usamos \(\log x\leq x-1\):
Isso equivale à desigualdade anunciada. A igualdade em \(\log x\leq x-1\) ocorre apenas quando \(x=1\); portanto, ela exige \(q_i=p_i\) para todo índice com \(p_i\gt 0\). Como ambas as famílias somam \(1\), também não pode haver massa de \(Q\) fora desse suporte, e \(p_i=q_i\) para todo \(i\).
A desigualdade de Gibbs permite identificar a distribuição de maior entropia entre \(n\) resultados possíveis. Para uma distribuição \( P = \{ p_1, p_2, \ldots , p_n \} \), temos
com igualdade somente quando \( p_i = \frac{1}{n} \) para todos \( i \). A distribuição uniforme maximiza, portanto, a informação média por observação: sem resultados favorecidos, a surpresa fica mais bem distribuída.
Seja \(X\) uma variável aleatória discreta com valores distintos \(x_1,x_2,\ldots \). Suponha que Prove, a partir da definição da integral de Lebesgue, que
Construa variáveis aleatórias \(X,Y:[0,1]\to \mathbb {R}\), no espaço com medida de Lebesgue, tais que Calcule explicitamente as duas probabilidades e as duas esperanças. Prove que, para toda função boreliana \(g:\mathbb {R}\to \mathbb {R}\), Compare com os casos concretos \(g(x)=x^+\) e \(g(x)=x^-\) estudados no Capítulo 6. Seja \(X_1,X_2,\ldots \) uma sequência de variáveis aleatórias mutuamente independentes. Prove que as \(\sigma \)-álgebras são independentes. Sejam \(X_1,X_2,\ldots \) variáveis aleatórias i.i.d., com média \(\mu \) e variância \(\sigma ^2\lt \infty \). Seja \(N\) uma variável aleatória com valores em \(\mathbb {N}_0\), independente da sequência, com Defina com a convenção de que a soma vazia vale zero. Calcule \(\mathbf{E}[S]\) e \(\operatorname {Var}(S)\). Prove a desigualdade de Cauchy–Schwarz: se \(X,Y\in L^2(\P )\), então Prove também que há igualdade se, e somente se, \(X\) e \(Y\) são linearmente dependentes como elementos de \(L^2(\P )\). Sejam \(X\) e \(Z\) variáveis aleatórias independentes, ambas com distribuição normal padrão. Para \(a,b\in \mathbb {R}\), não ambos nulos, defina Calcule \(\operatorname {Corr}(X,Y)\). Verifique diretamente que \(|\operatorname {Corr}(X,Y)|\leq 1\). Determine as condições necessárias e suficientes sobre \(a\) e \(b\) para que \(\operatorname {Corr}(X,Y)=1\). Faça o mesmo para \(\operatorname {Corr}(X,Y)=-1\). Suponha que \(n\geq 2\) pessoas deixem seus chapéus no vestiário e, ao final, os chapéus sejam devolvidos segundo uma permutação uniforme. Seja \(X\) o número de pessoas que recebem o próprio chapéu. Calcule \(\mathbf{E}[X]\) e \(\operatorname {Var}(X)\). Seja \(X\) uma variável aleatória real. Prove que Mostre, de fato, as desigualdades que relacionam a série acima com \(\mathbf{E}|X|\). Seja \(X\) uma variável aleatória real. Prove que, para todo \(\varepsilon \gt 0\), existe uma variável aleatória limitada \(X_\varepsilon \) tal que Faça a construção por truncamento e indique uma cota determinística para \(|X_\varepsilon |\). Coletor de cupons. Cada pacote contém, de maneira independente, uma figurinha escolhida uniformemente entre \(n\) tipos. Determine o número esperado de pacotes necessários para obter ao menos uma figurinha de cada tipo. Seja \(X\) uma variável aleatória com valores em \(\mathbb {N}_0\) e segundo momento finito. Sua função geradora de probabilidades é Justifique as derivações em \(s=1\) pela esquerda e prove que Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Desigualdades
Uma moeda justa é lançada independentemente \(n\) vezes, e \(S_n\) denota o número de caras. Use a desigualdade de Chebyshev para provar que, para todo \(\varepsilon \gt 0\),
Ver solução
Dígitos binários e função geradora exponencial. Para \(\omega \in [0,1)\), seja \(d_k(\omega )\in \{ 0,1\} \) o \(k\)-ésimo dígito de sua expansão binária; nos racionais diádicos, escolha a expansão que termina em zeros. Defina
Com respeito à medida de Lebesgue, prove que
Diferenciando em \(t=0\), conclua que
Dica. Divida \([0,1)\) nos intervalos diádicos \([k/2^n,(k+1)/2^n)\), \(0\leq k\lt 2^n\).
Ver solução
Cota exponencial para os dígitos binários. Com a notação do exercício anterior, prove que, para todo \(\varepsilon \gt 0\),
Dica. Use (7.2), o argumento exponencial de Markov e
Ver solução
Demonstração probabilística do Teorema de Weierstrass. Se \(f:[0,1]\to \mathbb {R}\) é contínua, use a desigualdade de Chebyshev e a continuidade uniforme de \(f\) para provar que
uniformemente em \(x\in [0,1]\).
Dica. Para cada \(x\), tome \(S_n\sim \operatorname {Binomial}(n,x)\) e escreva o polinômio acima como \(\mathbf{E}[f(S_n/n)]\). Separe os eventos \(\{ |S_n/n-x|\lt \delta \} \) e \(\{ |S_n/n-x|\geq \delta \} \) usando uma escolha de \(\delta \) que não dependa de \(x\).
Ver solução
Otimalidade da desigualdade de Chebyshev. Fixe \(t\geq 1\), \(\mu \in \mathbb {R}\) e \(\sigma \gt 0\). Construa uma variável aleatória \(X\) com média \(\mu \) e variância \(\sigma ^2\) tal que
Ver solução
Seja \(X\) uma variável aleatória não negativa com \(\mathbf{E}[X]\lt \infty \), e defina \(X_n=X\wedge n\).
Dê um exemplo para o qual \(\mathbf{E}[X^2]=\infty \).
Prove que, para todo \(p\gt 2\),
\[ \sum _{n=1}^{\infty }n^{-p}\mathbf{E}[X_n^2]\lt \infty . \]Prove que a conclusão continua válida no caso-limite \(p=2\).
Dica para o último item. Para cada \(x\geq 0\), estime \(\sum _{n\geq 1}n^{-2}(x\wedge n)^2\) separando os índices \(n\leq x\) e \(n\gt x\).
Ver solução
Sejam \(X_1,\ldots ,X_n\) variáveis aleatórias reais independentes e \(S_k=X_1+\cdots +X_k\). Prove a desigualdade de Etemadi: para todo \(t\gt 0\),
Dica. Para \(r\gt 0\), considere os eventos disjuntos de primeira passagem
Use a independência de \(A_j\) e \(S_n-S_j\) e trate separadamente o caso em que \(\max _k\P (|S_k|\geq r)\gt 1/3\).
Ver solução
Dê um exemplo de variáveis aleatórias limitadas e dependentes \(X\) e \(Y\) tais que \(\operatorname {Cov}(X,Y)=0\). Calcule a covariância e mostre diretamente que as variáveis não são independentes.
Dica. Tome uma variável \(X\) centrada e procure \(Y\) que seja nula sempre que \(X\neq 0\).
Ver solução
Ver solução
Se \(\mathbf{E}X_1\lt \infty \), prove que \(X_n/n\to 0\) quase certamente.
Se \(\mathbf{E}X_1=\infty \), prove que
\[ \limsup _{n\to \infty }\frac{X_n}{n}=\infty \qquad \text{quase certamente}. \]
Ver solução
Se \(\mathbf{E}X_1\lt \infty \), para todo \(\varepsilon \gt 0\),
pela Proposição 7.24. Borel–Cantelli e a interseção sobre \(\varepsilon =1/m\) dão \(X_n/n\to 0\).
Se \(\mathbf{E}X_1=\infty \), para cada \(M\gt 0\),
Os eventos são independentes; pelo segundo Borel–Cantelli ocorrem infinitas vezes. Intersectando sobre \(M\in \mathbb N\), o limsup é infinito.
Mostre que, para \(t\gt 0\),
\[ \mathbf{E}e^{tS}\le \exp \{ \mu (e^t-1)\} . \]Use Markov exponencial e \(t=\log (1+\delta )\) para provar
\[ \P (S\ge (1+\delta )\mu ) \le \left(\frac{e^\delta }{(1+\delta )^{1+\delta }}\right)^\mu . \]
Ver solução
Use Hölder, Teorema 5.18, para mostrar que \(D=\{ t:M(t)\lt \infty \} \) é um intervalo.
Se \(t\) está no interior de \(D\), prove que \(\mathbf{E}[|X|^ke^{tX}]\lt \infty \) para todo \(k\ge 1\).
Conclua que \(M\) e \(\Lambda \) são \(C^\infty \) no interior de \(D\) e
\[ \Lambda '(t)=\frac{\mathbf{E}[Xe^{tX}]}{\mathbf{E}[e^{tX}]}. \]
Ver solução
Escreva \(X_H\) como soma de indicadoras indexada por injeções dos vértices de \(H\) em \([n]\).
Corrija a supercontagem produzida pelos automorfismos e prove
\[ \mathbf{E}X_H=\frac{(n)_{v(H)}}{a(H)}p^{e(H)}. \]Especialize a fórmula para arestas, caminhos de comprimento dois, triângulos e cliques \(K_r\).
Ver solução
Prove que
\[ \mathbf{E}I=n(1-p)^{n-1}. \]Tome \(p_n=(\log n+c_n)/n\). Mostre que
\[ \mathbf{E}I\sim e^{-c_n}. \]Conclua que, se \(c_n\to +\infty \), não há vértices isolados com alta probabilidade.
Se \(c_n\to -\infty \), explique por que \(\mathbf{E}I\to \infty \), sozinho, não prova que existe vértice isolado com alta probabilidade.
Ver solução
escreva \(T=\sum _\alpha I_\alpha \) e calcule \(\mathbf{E}T\);
classifique pares de triângulos distintos conforme compartilhem uma aresta ou não;
determine quais covariâncias são nulas e prove
\[ \operatorname {Var}(T) = \binom n3(p^3-p^6) +2\binom n2\binom {n-2}2(p^5-p^6); \]use Markov para mostrar que \(np\to 0\) implica \(\P (T\gt 0)\to 0\);
mostre que, se \(np\to \infty \),
\[ \frac{\operatorname {Var}(T)}{(\mathbf{E}T)^2}\longrightarrow 0 \]e conclua que \(\P (T\gt 0)\to 1\).
Ver solução
Há \(\binom n3\) triângulos e cada um aparece com probabilidade \(p^3\), portanto
Triângulos distintos que não compartilham aresta usam conjuntos disjuntos de coordenadas e são independentes. Se compartilham uma aresta, a união contém cinco arestas, logo
Existem \(\binom n2\binom {n-2}2\) pares não ordenados desse tipo, o que dá a fórmula da variância.
Se \(np\to 0\), então \(\mathbf{E}T\sim (np)^3/6\to 0\) e Markov conclui. Se \(np\to \infty \),
Chebyshev dá \(\P (|T-\mathbf{E}T|\ge \mathbf{E}T)\to 0\); como \(\{ T=0\} \) está contido nesse evento, \(\P (T\gt 0)\to 1\).
Prove que
\[ \mathbf{E}X_r=\binom nr2^{-\binom r2}. \]Para \(\varepsilon \gt 0\), tome \(r_n=\lceil (2+\varepsilon )\log _2 n\rceil \) e mostre que \(\mathbf{E}X_{r_n}\to 0\).
Conclua que
\[ \P \bigl(\omega (G(n,1/2))\ge r_n\bigr)\to 0. \]