Modos de Convergência
Até aqui, limites apareceram em diferentes formas. Em probabilidade, porém, dizer que \(\xi _n\) se aproxima de \(\xi \) ainda exige especificar o sentido da convergência. Este capítulo organiza e compara essas noções.
10.1 Duas convergências determinísticas
Antes de usar a probabilidade, recordemos duas noções de convergência de funções. Elas não dependem de medida alguma e servirão sobretudo como contraste para as convergências probabilísticas.
10.1.1 Convergência pontual
Seja \(\Omega \) um conjunto e \(\xi _n,\xi \colon \Omega \to \mathbb {R}\). Dizemos que \(\xi _n\) converge pontualmente para \(\xi \) se, para todo \(x\in \Omega \),
O índice a partir do qual \(\xi _n(x)\) está próximo de \(\xi (x)\) pode depender do ponto \(x\).
10.1.2 Convergência uniforme
A distância uniforme entre duas funções \(\xi \) e \(\eta \) é
com valor possivelmente infinito. Dizemos que \(\xi _n\) converge uniformemente para \(\xi \) se
Agora um mesmo índice deve controlar simultaneamente todos os pontos do domínio. Em particular, convergência uniforme implica convergência pontual.
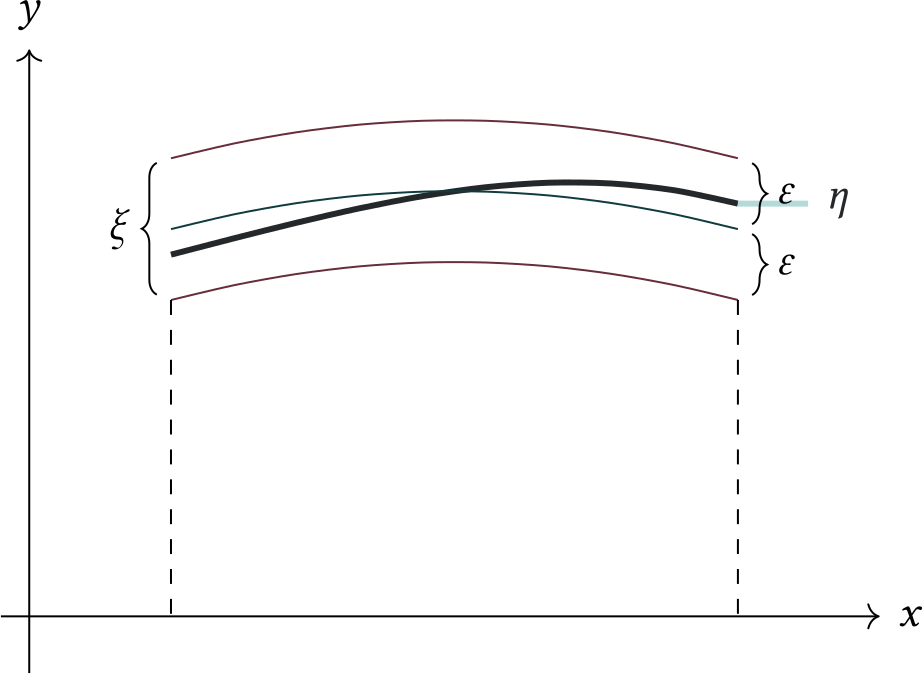
O exemplo seguinte separa as duas noções e reaparecerá, em espírito, nas convergências probabilísticas.
A diferença entre as duas noções está na ordem dos quantificadores. A partir de agora, a medida de probabilidade permitirá uma terceira possibilidade: admitir conjuntos excepcionais e controlar o seu tamanho.
10.2 Convergência em Espaços de Probabilidade
Passamos agora às convergências que usam a estrutura mensurável e a probabilidade. O conjunto excepcional deixa de ser apenas um defeito: seu tamanho passa a fazer parte da definição.
10.2.1 Convergência em Distribuição
A convergência em distribuição é a mais fraca entre as que estudaremos. Ela compara apenas as leis de \(\xi _n\) com a lei de \(\xi \), por meio de suas funções de distribuição. O espaço amostral fica fora de cena: as variáveis nem sequer precisam estar definidas no mesmo espaço de probabilidade.
A restrição aos pontos de continuidade de \(F_X\) é essencial. Considere \(X_n\equiv 1/n\) e \(X\equiv 0\) num mesmo espaço de probabilidade. Então \(X_n\to X\) pontualmente, uniformemente, quase certamente, em probabilidade e em \(L^p\), para todo \(p\geq 1\).
As funções de distribuição são
Para \(x\neq 0\), temos \(F_{X_n}(x)\to F_X(x)\), enquanto \(F_{X_n}(0)=0\not\to 1=F_X(0)\). Como \(0\) é precisamente o ponto de descontinuidade de \(F_X\), ainda assim \(X_n\xrightarrow d0\).
Ao trabalhar com variáveis aleatórias que tomam valores inteiros, o seguinte teorema é frequentemente útil.
Como \(\xi \) toma valores inteiros, sua função de distribuição \(F_\xi \) é contínua em todo \(x\in \mathbb {R}\setminus \{ 0,1,2,\ldots \} \). Se \(\xi _n\xrightarrow d\xi \), então
Assim, para \(k = 0,1,2, \cdots \), temos
Para provar a recíproca, suponha que
Se \(x\lt 0\), então \(F_{\xi _n}(x)=F_\xi (x)=0\). Se \(x\geq 0\), temos
onde \(\lfloor x\rfloor \) denota o maior inteiro menor ou igual a \(x\). Como, para \(x\) fixo, a soma é finita, podemos trocar o limite com a soma e obtemos
Pelo teorema anterior, basta mostrar que, para cada \(k=0,1,2,\ldots \),
Temos
Para \(k\) fixo, temos
Logo
que é a função de probabilidade de \(\operatorname {Poisson}(\lambda )\).
10.2.2 Convergência em Probabilidade
Na convergência em probabilidade, não exigimos proximidade em cada ponto; exigimos que a probabilidade de um afastamento fixo desapareça. No contexto da Teoria da Medida, essa noção é chamada de convergência em medida.
A sequência pode continuar errando, mas a região em que o erro é maior do que \(\epsilon \) deve tornar-se improvável.
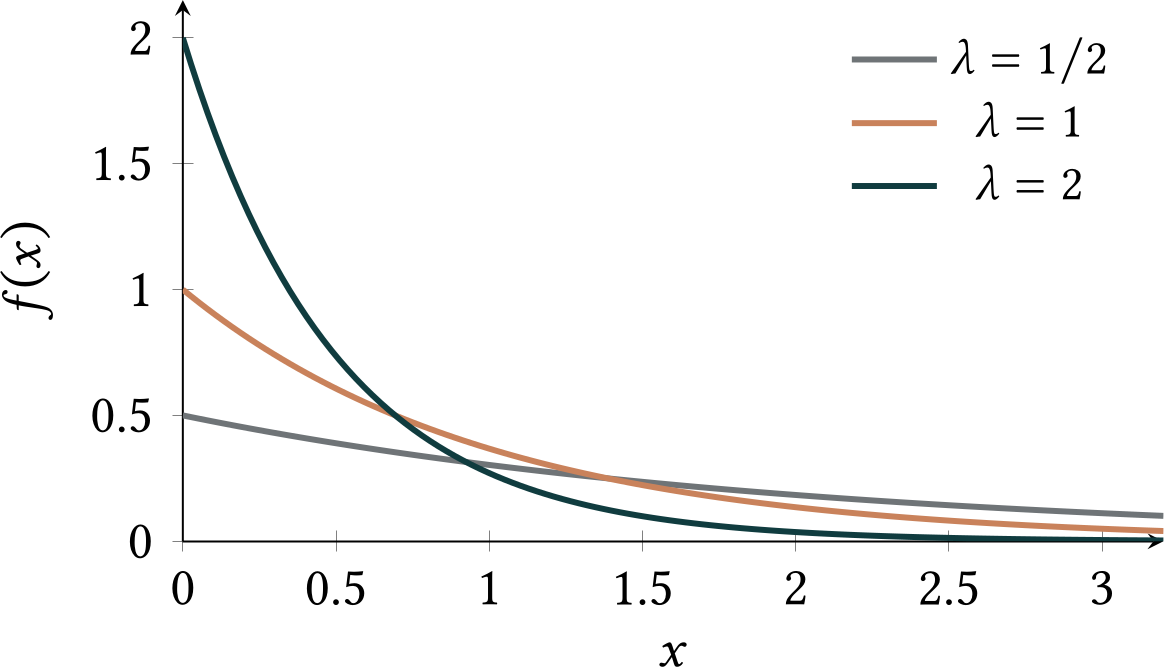
Dado \(\xi _n \sim \operatorname {Exp}(n)\), então \(\xi _n \ \xrightarrow {\P }\ 0\).
Pois
Seja \(\xi \) uma variável aleatória e \(\xi _n=\xi +\eta _n\), com
onde \(\sigma \gt 0\) é uma constante. Então \(\xi _n \ \xrightarrow {\P }\ \xi \).
Pela desigualdade triangular para \(\eta _n-\mathbf{E}[ \eta _n] +\mathbf{E}[ \eta _n]\), temos
Então, para todo \(\epsilon \gt 0\) e todo \(n\gt 1/\epsilon \), temos
Logo \(\xi _n \ \xrightarrow {\P }\ \xi \).
10.2.3 Convergência Quase Certa
Na convergência quase certa, recuperamos a convergência pontual, permitindo apenas que ela falhe em um conjunto de probabilidade nula.
Começaremos com uma leve adaptação do exemplo 10.1, onde tínhamos uma sequência convergindo pontualmente.
Tome \(\Omega =[0,1]\), munido da \(\sigma \)-álgebra de Borel, e seja \(\P \) a medida de Lebesgue em \([0,1]\). Para \(n\geq 1\), defina
Para \(\omega \in (0,1]\), temos \(\xi _n(\omega )=0\) para todo \(n\gt 1/\omega \), de modo que \(\xi _n(\omega )\to 0\).
No entanto, vale também que \(\xi _n(0)=1\) para todo \(n\gt 0\), de modo que
e
Dizemos assim que \(\xi _n\rightarrow 0\) quase certamente, quando \(n\to \infty \).
Sejam \( \xi \) uma variável aleatória e \( \{ \xi _n\} _{n\geq 1} \) uma sequência de variáveis aleatórias definidas no mesmo espaço de probabilidade. Dizemos que \( \xi _n \) converge quase certamente para \( \xi \), isto é, \( \xi _n\xrightarrow {q.c.}\xi \) se
ou, equivalentemente, se
A convergência quase certa é uma convergência pontual em um conjunto de probabilidade \(1\): temos \(\xi _n(\omega )\to \xi (\omega )\) para quase todo \(\omega \), isto é, exceto possivelmente em um conjunto de probabilidade nula.
Em \(\Omega =[0,1]\), com a medida de Lebesgue, para \(n\geq 1\) definimos \(\xi _n(x)=\begin{cases} 1 \quad \text{se} \quad x\in \mathbb {Q} \\ 1/n \quad \text{caso contrário} \end{cases}\)
Essa sequência não converge pontualmente para a função constante zero, pois vale \(1\) em todo racional para todo \(n\), mas converge quase certamente para zero porque \(\mathbb {Q}\cap [0,1]\) tem medida de Lebesgue nula.
Imagine uma sequência de pagamentos diários que termina definitivamente na primeira ocorrência de um certo evento aleatório. Se esse evento tem probabilidade positiva e as tentativas são independentes, quase certamente ele ocorrerá em algum instante finito. Assim, o valor pago por dia converge quase certamente a zero.
Isso não significa que exista uma data determinística a partir da qual os pagamentos cessam. Em qualquer horizonte finito ainda pode haver probabilidade positiva de continuação. A convergência quase certa controla a trajetória inteira, mas não fornece um prazo uniforme.
Para \(k,n\geq 1\), ponha \(A_{k,n}=\{ |\xi _n-\xi |\geq 1/k\} \). Pela definição de convergência de sequências reais,
Se \(\xi _n\to \xi \) quase certamente, o evento à esquerda tem probabilidade zero; logo cada evento \(\{ A_{k,n}\ {\, \, \text{\textrm{ i.v.}} }\} \) tem probabilidade zero. Reciprocamente, se todos esses eventos têm probabilidade zero, sua união enumerável também tem probabilidade zero, e portanto \(\xi _n\to \xi \) quase certamente.
Por fim, a condição para todos os \(\epsilon \gt 0\) implica imediatamente a condição para \(\epsilon =1/k\). Para a recíproca, dado \(\epsilon \gt 0\), escolha \(k\) com \(1/k\leq \epsilon \) e use \(\{ |\xi _n-\xi |\geq \epsilon \} \subseteq A_{k,n}\).
Para cada \(k\geq 1\), aplique o primeiro lema de Borel–Cantelli aos eventos \(A_n^{(k)}=\{ |\xi _n-\xi |\gt 1/k\} \). A hipótese fornece \(\sum _n\P (A_n^{(k)})\lt \infty \), logo \(\P (A_n^{(k)}\ \mathrm{i.v.})=0\). Fora da união desses eventos-limite, para todo \(k\) temos eventualmente \(|\xi _n-\xi |\leq 1/k\); logo \(\xi _n\to \xi \). Portanto, \(\xi _n\xrightarrow {q.c.}\xi \).
Seja \((\xi _n)_{n\geq 1}\) uma sequência tal que
Então \(\xi _n \ \xrightarrow {q.c.}\ 0.\)
Pelo teorema anterior basta mostrar que
Como \(|\xi _n|=1/n\), a desigualdade \(|\xi _n|\gt \epsilon \) só pode ocorrer para \(n\lt 1/\epsilon \). Logo temos
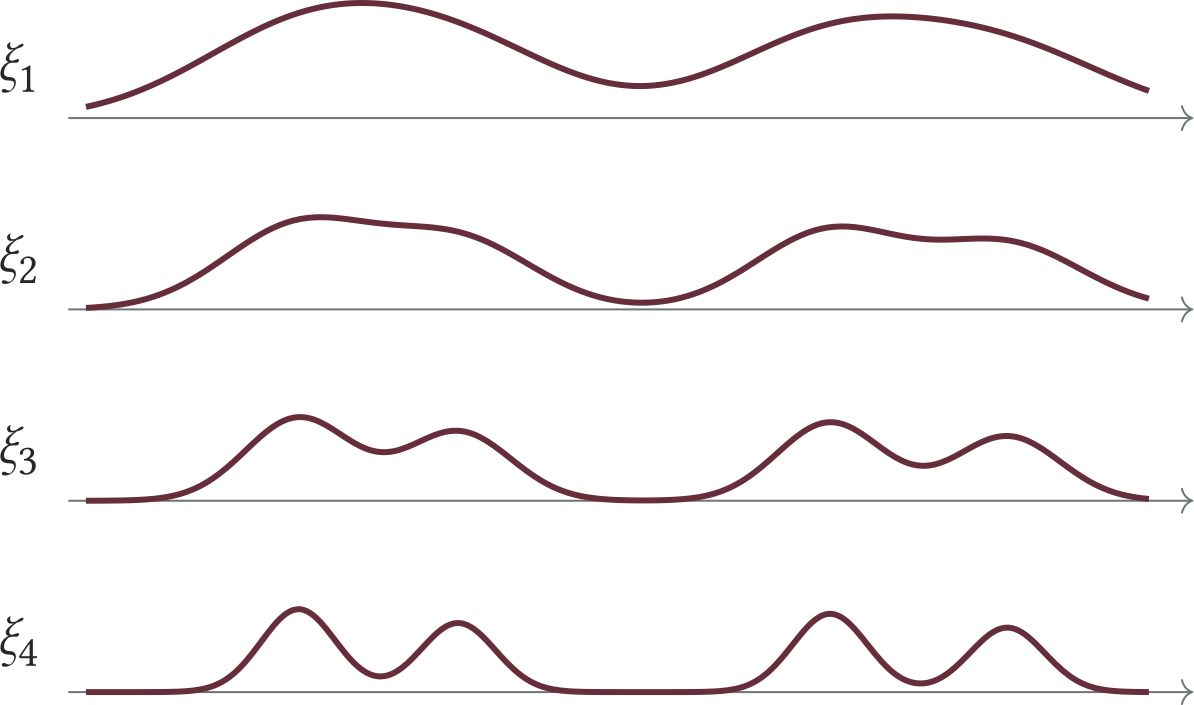
Em \(\Omega =[0,1]\), com a medida de Lebesgue, para cada \(m\geq 2\), particione \([0,1]\) em \(m\) intervalos mensuráveis disjuntos \(I_{m,1},\ldots ,I_{m,m}\), cada um com medida \(1/m\), e enumere em blocos as funções indicadoras
Denote a sequência resultante por \((\xi _n)\). Em cada bloco, temos \(\P (\xi _n=1)=1/m\); portanto, ao avançarmos pelos blocos, \(\P (|\xi _n|\gt \epsilon )\to 0\) para todo \(0\lt \epsilon \lt 1\). Assim, \(\xi _n\to 0\) em probabilidade.
Por outro lado, em cada bloco e para cada \(\omega \in [0,1]\), exatamente uma das indicadoras vale \(1\) em \(\omega \) e as demais valem \(0\). Logo \((\xi _n(\omega ))\) assume os valores \(0\) e \(1\) infinitas vezes e não converge em nenhum ponto.
10.2.4 Convergência em \(\mathcal L^p\)
A convergência em \(\L ^p\) controla o tamanho médio do erro, medido pela potência \(p\).
Seja \(X_n \sim \operatorname {Uni}\left(0, \frac{1}{n}\right)\). Então \(X_n \xrightarrow {\L ^{p}}0\) para todo \(p \geq 1\).
A densidade de \(X_n\) é dada por
Então
Se \(p=q\), não há o que provar. Suponha \(p\lt q\) e ponha \(r=q/p\gt 1\), com expoente conjugado \(r'\). Aplicando Hölder a \(|\xi _n-\xi |^p\cdot 1\) e usando \(\P (\Omega )=1\), obtemos
Logo
Considere uma sequência \(\{ X_n\} \) tal que
Mostre que
\( X_n \xrightarrow {p} \ 0.\)
\(X_n\) não converge em \(\L ^p\) para qualquer \(p\geq 1\).
Para mostrar que \(X_n \ \xrightarrow {p} \ 0\), podemos escrever, para qualquer \(\epsilon \gt 0\)
\begin{align*} \lim _{n \rightarrow \infty } \P \big(| X_n | \geq \epsilon \big) & = \lim _{n \rightarrow \infty } \P (X_n = n ^2) \\ & = \lim _{n \rightarrow \infty } \frac{1}{n} \\ & = 0. \end{align*}Assim \(X_n \xrightarrow {p} 0\).
Para qualquer \(p\geq 1\), podemos escrever
\begin{align*} \lim _{n\to \infty }\mathbf{E}\left(|X_n|^p\right) & = \lim _{n\to \infty }\left(n^{2p}\frac1n\right) \\ & = \lim _{n \rightarrow \infty } n ^{2p-1} \\ & = \infty \qquad (\text{ pois $ p \geq 1 $}). \end{align*}Portanto, \(X_n\) não converge em \(\L ^p\) para qualquer \(p\geq 1\). Em particular, embora \(X_n\xrightarrow {\P }0\), o valor esperado de \(X_n\) não converge para \(0\).
10.3 Comparando os Modos de Convergência
As noções anteriores não formam apenas uma lista: há uma hierarquia entre elas, embora algumas implicações dependam de hipóteses adicionais. As relações principais estão resumidas no diagrama:
"

q.c. [r, Rightarrow] ¶ [u, Rightarrow, bend left=25, "dominação em \(\L ^q\)“] [r, Rightarrow] d

Convergência quase certa implica convergência em probabilidade
\(\xi _n \rightarrow \xi \) q.c. implica \(\xi _n \rightarrow \xi \) em probabilidade.
Se \(\xi _n \rightarrow \xi \) em probabilidade, então existe uma subsequência \(\xi _{n_k} \rightarrow \xi \) quase certamente.
Suponha \(\xi _n\to \xi \) q.c. e fixe \(\epsilon \gt 0\). Ponha \(A_n=\{ |\xi _n-\xi |\gt \epsilon \} \) e \(B_N=\bigcup _{n\geq N}A_n\). Então \(B_N\downarrow \limsup _n A_n\), cuja probabilidade é zero pelo Teorema 10.13. Como \(\P (B_1)\leq 1\lt \infty \), a continuidade da probabilidade por cima dá \(\P (B_N)\downarrow 0\). Para \(n\geq N\), \(A_n\subset B_N\); logo \(\P (A_n)\to 0\).
Concluímos portanto que \( \xi _n \rightarrow \xi \) em probabilidade.
Suponha \( \xi _n \rightarrow \xi \) em probabilidade. Queremos encontrar uma subsequência que converge quase certamente.
Pela convergência em probabilidade, podemos escolher recursivamente \(n_1\lt n_2\lt \cdots \) de modo que
\[ \P \left(|\xi _{n_k}-\xi |\gt \frac1k\right)\lt 2^{-k}, \qquad k=1,2,\ldots . \]Como \(\sum _k2^{-k}\lt \infty \), o primeiro lema de Borel–Cantelli mostra que \(|\xi _{n_k}-\xi |\gt 1/k\) ocorre apenas finitas vezes, quase certamente. Portanto, \(\xi _{n_k}\to \xi \) quase certamente.
Convergência em \(\L ^p\) implica convergência em Probabilidade
Usando a desigualdade de Markov, temos, para todo \(\epsilon \gt 0\),
Vimos que se a sequência \(\xi _n\) converge em \(\L ^p\) para \(\xi \) então a sequência também converge em probabilidade, porém a recíproca nem sempre é verdadeira.
Toda subsequência \((\xi _{n_k})\) possui, pela parte anterior, uma subsubsequência \((\xi _{n_{k_j}})\) que converge para \(\xi \) quase certamente. Ao passar ao limite nessa subsubsequência, obtemos \(|\xi |\leq \eta \) quase certamente. Consequentemente,
O lado direito é integrável e o lado esquerdo converge quase certamente para zero. Pelo Teorema da Convergência Dominada, \(\mathbf{E}|\xi _{n_{k_j}}-\xi |^p\to 0\).
Assim, toda subsequência da sequência numérica \(a_n=\mathbf{E}|\xi _n-\xi |^p\) possui uma subsubsequência convergente a zero. Se \(a_n\) não convergisse a zero, haveria uma subsequência limitada inferiormente por alguma constante positiva, uma contradição. Logo \(a_n\to 0\).
Decompondo nos conjuntos \(\{ \xi _n\leq \xi \} \) e \(\{ \xi _n\gt \xi \} \),
Além disso, \(0\leq (\xi -\xi _n)\mathbb {1}_{\{ \xi _n\leq \xi \} }\leq \xi \), e esse termo converge quase certamente para zero. A convergência dominada e a hipótese sobre as esperanças mostram que os dois termos da última expressão tendem a zero.
Convergência em Probabilidade implica Convergência em Distribuição
Tome \(\epsilon \gt 0\) e note que, como \(\xi _n\xrightarrow {\P }\xi \), então
Fixado também \(\delta \gt 0\), existe \(n_0\geq 1\) tal que
para todo \(n\geq n_0\).
Se \(\xi _n\leq x\) e \(|\xi _n-\xi |\leq \epsilon \), então \(\xi \leq x+\epsilon \). Logo, para \(n\geq n_0\),
Concluímos assim que
para todo \(\epsilon \gt 0\).
De modo análogo, se \(\xi \leq x-\epsilon \) e \(|\xi _n-\xi |\leq \epsilon \), então \(\xi _n\leq x\). Portanto,
Segue então que para todo \(\epsilon \gt 0\),
Tomando \(x\) como ponto de continuidade de \(F_\xi \) e fazendo \(\epsilon \downarrow 0\), encontramos
concluindo o resultado.
O núcleo conceitual do capítulo termina aqui. As implicações acima dizem como os quatro modos se relacionam; os exemplos anteriores mostram por que as recíprocas falham sem hipóteses adicionais. A partir deste ponto, mudamos de pergunta: em vez de comparar definições, passamos a desenvolver ferramentas para reconhecer limites em distribuição e extrair subsequências convergentes.
10.4 Ferramentas para convergência de leis
Há dois mecanismos principais nesta segunda parte. Skorokhod permite realizar leis convergentes num espaço comum, com convergência quase certa. Helly e tightness fornecem compacidade: permitem extrair subsequências e impedir que massa escape para o infinito. Estas ferramentas, juntamente com o critério de unicidade de limites subsequenciais, serão usadas novamente no capítulo do Teorema do Limite Central.
10.4.1 Representação de Skorokhod
A convergência em distribuição compara leis, não trajetórias, e por isso não exige que as variáveis estejam no mesmo espaço. O Teorema de Representação de Skorokhod mostra até onde podemos inverter essa fraqueza: em um espaço adequado, é possível realizar cópias com as mesmas leis que convergem quase certamente.
Sejam \(F_n\) e \(F\) as funções de distribuição de \(\xi _n\) e \(\xi \), respectivamente. Em \((0,1)\), munido da medida de Lebesgue, considere a variável uniforme \(U(u)=u\) e defina
onde as estrelas denotam as inversas generalizadas. Pela Proposição 6.9, \(\xi _n'\stackrel d=\xi _n\) e \(\xi '\stackrel d=\xi \).
Resta provar a convergência quase certa. Fixe \(u\in (0,1)\) em que \(F^*\) é contínua e fixe \(\varepsilon \gt 0\). Como uma função monótona possui no máximo uma quantidade enumerável de descontinuidades, podemos escolher um ponto de continuidade \(x_-\) de \(F\) tal que
Pela caracterização \(F^*(u)\leq x\Longleftrightarrow u\leq F(x)\), a desigualdade \(x_-\lt F^*(u)\) implica \(F(x_-)\lt u\). Como \(F_n(x_-)\to F(x_-)\), temos \(F_n(x_-)\lt u\) para todo \(n\) suficientemente grande e, novamente pela mesma caracterização,
Daí, \(\liminf _nF_n^*(u)\geq F^*(u)\).
Para obter a desigualdade oposta, a continuidade de \(F^*\) em \(u\) permite escolher \(u'\in (u,1)\) tão próximo de \(u\) que \(F^*(u')\lt F^*(u)+\varepsilon /2\). Escolha então um ponto de continuidade \(x_+\) de \(F\) no intervalo
Como \(F^*(u')\leq x_+\), temos \(u'\leq F(x_+)\). Portanto, \(F_n(x_+)\to F(x_+)\) e, como \(u'\gt u\), vale \(F_n(x_+)\gt u\) para todo \(n\) suficientemente grande. Segue que
e assim \(\limsup _nF_n^*(u)\leq F^*(u)\). Concluímos que \(F_n^*(u)\to F^*(u)\) em todo ponto de continuidade de \(F^*\).
Pelo Corolário 6.11, o conjunto \(D_{F^*}\) das descontinuidades de \(F^*\) é no máximo enumerável. Como \(U\) é uniforme, \(\P (U\in D_{F^*})=0\). Logo
como queríamos.
10.4.2 Seleção de Helly, tightness e Prokhorov
O Princípio de Seleção de Helly fornece uma forma de compacidade para funções de distribuição, mas exige uma ressalva: o limite obtido pode perder massa no infinito e, portanto, não ser ele próprio uma função de distribuição.
Enumere os racionais como \(\mathbb {Q}=\{ q_1,q_2,\ldots \} \). Como cada sequência \((F_n(q_j))_{n\geq 1}\) toma valores em \([0,1]\), aplicações sucessivas de Bolzano–Weierstrass e o argumento diagonal fornecem uma subsequência \((F_{n_k})\) para a qual \(F_{n_k}(q)\) converge para todo \(q\in \mathbb {Q}\). Escreva
A monotonicidade das funções \(F_{n_k}\) implica que \(G\) é não decrescente.
Defina, para \(x\in \mathbb {R}\),
É imediato que \(F\) toma valores em \([0,1]\) e é não decrescente. Além disso, se \(L=\inf _{y\gt x}F(y)\), então \(L\geq F(x)\). Reciprocamente, dado \(\varepsilon \gt 0\), escolha \(q\in \mathbb {Q}\), \(q\gt x\), tal que \(G(q)\lt F(x)+\varepsilon \) e depois escolha \(y\) com \(x\lt y\lt q\). Como o racional \(q\) participa do ínfimo que define \(F(y)\),
Logo \(L=F(x)\), o que prova a continuidade à direita de \(F\).
Resta provar a convergência. Fixe \(x\in \mathbb {R}\) e \(\varepsilon \gt 0\). Pela definição de \(F(x)\), existe \(q\in \mathbb {Q}\), \(q\gt x\), tal que \(G(q)\lt F(x)+\varepsilon /2\). Para \(k\) suficientemente grande, \(F_{n_k}(q)\lt F(x)+\varepsilon \) e, pela monotonicidade,
Portanto, \(\limsup _kF_{n_k}(x)\leq F(x)\).
Suponha agora que \(x\) seja ponto de continuidade de \(F\). Escolha \(r\lt x\) de modo que \(F(r)\gt F(x)-\varepsilon /2\) e um racional \(q\) com \(r\lt q\lt x\). Da definição de \(F(r)\),
Para \(k\) suficientemente grande, \(F_{n_k}(q)\gt F(x)-\varepsilon \) e, novamente pela monotonicidade,
Assim, \(\liminf _kF_{n_k}(x)\geq F(x)\). As duas estimativas provam que \(F_{n_k}(x)\to F(x)\) em todo ponto de continuidade de \(F\).
O princípio de seleção de Helly diz que, dada \((F_n)_{n\geq 1}\), alguma subsequência \(F_{n_k}(x)\) converge para uma função \(F(x)\) em todos os pontos de continuidade de \(F\). A função limite é não decrescente e contínua à direita, mas ainda pode não ser uma função de distribuição.
Falta garantir que
O princípio de Helly, sozinho, não garante essas duas igualdades: à medida que \(n\) cresce, pode haver massa de probabilidade escapando para \(+\infty \) ou para \(-\infty \), como mostra o exemplo abaixo.
Se \(U\) é uniforme em \([0,1]\) e \(\delta ,\epsilon \gt 0\) satisfazem \(\delta +\epsilon \lt 1\), defina
para \(n\ge 1\).
Para todo \(t\gt 0\),
de modo que quando \(n\to \infty \) uma “massa” de probabilidade \(\epsilon \) está sendo perdida em \(+\infty \) e \(\delta \) em \(-\infty \).
Consequentemente,
que é uma função não-decrescente e contínua pela direita, mas não é uma função distribuição.
Uma forma de resolver esse problema é garantir que a massa de probabilidade fique quase toda contida em um intervalo limitado, uniformemente ao longo da sequência. Isto é, para todo \(\epsilon \gt 0\) devem existir \(a,b\in \mathbb {R}\) tais que \(\P (a\lt X_n\leq b)\gt 1-\epsilon \) para todo \(n\geq 1\).
Esta propriedade é denominada tightness e está precisamente definida abaixo.
Fixe \(\varepsilon \gt 0\) e escreva \(F_n\) e \(F\) para as funções de distribuição de \(X_n\) e \(X\). Escolha pontos de continuidade \(a\lt b\) de \(F\) tais que
Como \(F_n(a)\to F(a)\) e \(F_n(b)\to F(b)\), para todo \(n\) suficientemente grande,
Restam apenas finitos índices. Para cada um deles, a continuidade por baixo em \(\{ |X_j|\leq M\} \uparrow \Omega \) permite escolher um intervalo compacto que contenha massa maior que \(1-\varepsilon \). Tome então um único intervalo compacto que contenha todos esses intervalos e também \([a,b]\). Esse intervalo funciona simultaneamente para todo \(n\).
Seja \(F_n(x)=\P _n((-\infty ,x])\). Pelo princípio de seleção de Helly, existem uma subsequência \((F_{n_k})\) e uma função \(F:\mathbb {R}\to [0,1]\), não decrescente e contínua à direita, tais que \(F_{n_k}(x)\to F(x)\) em todo ponto de continuidade de \(F\).
Fixe \(\varepsilon \gt 0\). Pela tightness, existe \([a_0,b_0]\) tal que \(\P _n([a_0,b_0])\gt 1-\varepsilon \) para todo \(n\). Como \(F\) possui no máximo uma quantidade enumerável de descontinuidades, podemos escolher pontos de continuidade \(a\lt a_0\) e \(b\gt b_0\). Então
Se \(L_-:=\lim _{x\to -\infty }F(x)\) e \(L_+:=\lim _{x\to \infty }F(x)\), segue que \(L_+-L_-\geq 1-\varepsilon \). Como isso vale para todo \(\varepsilon \gt 0\) e \(0\leq L_-\leq L_+\leq 1\), necessariamente \(L_-=0\) e \(L_+=1\).
Portanto, \(F\) é uma função de distribuição. Pela Proposição 6.9, existe uma variável aleatória \(X\) com função de distribuição \(F\); seja \(\P \) a lei de \(X\). A convergência obtida nos pontos de continuidade de \(F\) é precisamente \(\P _{n_k}\Rightarrow \P \).
Assim, tomando \(X\) uma variável aleatória com função distribuição \(F\), mostramos o seguinte resultado.
A família das distribuições \((\P _{X_n})\) é tight. Pelo teorema anterior, alguma subsequência \((\P _{X_{n_k}})\) converge fracamente para uma medida de probabilidade \(\P \). No espaço canônico \((\mathbb {R},\mathcal{B}(\mathbb {R}),\P )\), a aplicação identidade define uma variável aleatória \(X\) com lei \(\P \). Pela definição de convergência em distribuição, \(X_{n_k}\xrightarrow dX\).
A tightness impede que a massa escape e garante limites ao menos ao longo de subsequências. Para obter a convergência da sequência inteira, resta mostrar que todas as subsequências convergentes conduzem ao mesmo limite.
Denote por \(F\) a função de distribuição de \(X\) e por \(F_n\) a de \(X_n\). Se \(X_n\) não convergisse em distribuição para \(X\), existiriam um ponto de continuidade \(x\) de \(F\), uma constante \(\epsilon \gt 0\) e uma subsequência \((n_k)\) tais que
A subsequência \((X_{n_k})\) continua tight. Pela Proposição 10.32, ela possui uma subsubsequência convergente em distribuição; pela hipótese, seu limite é \(X\). Logo \(F_{n_{k_i}}(x)\to F(x)\), contradizendo a desigualdade anterior.
Esses modos de convergência serão usados repetidamente nos teoremas-limite.
Seja \((\xi _n)_{n\geq 1}\) uma sequência de variáveis aleatórias tal que onde \(\lambda \gt 0\) e \(\operatorname {Ge}_0(p)\) conta o número de fracassos antes do primeiro sucesso. Defina \(\eta _n=\xi _n/n\). Calcule \(\P (\eta _n\gt x)\) e mostre que \(\eta _n\) converge em distribuição para uma variável exponencial de taxa \(\lambda \). Sejam \((\xi _n)\) e \((\eta _n)\) duas sequências de variáveis aleatórias definidas no mesmo espaço de probabilidade. Suponha que Prove que \(\xi _n+\eta _n\xrightarrow {\P }\xi +\eta \). Considere uma sequência \((\xi _n)\) tal que Mostre que: \(\xi _n\xrightarrow {\P }0\). \(\xi _n\xrightarrow {\L ^r}0\) para \(0\lt r\lt 2\). \(\xi _n\) não converge para zero em \(\L ^r\) para \(r\geq 2\). \(\xi _n\xrightarrow {q.c.}0\). Suponha que \(\xi _n\xrightarrow {\L ^r}\xi \) para \(r\geq 1\). Mostre que Suponha que \(\xi _n\xrightarrow d\xi \) e \(\eta _n\xrightarrow {\P }c\), onde \(c\) é constante. Prove que Prove o Teorema da Aplicação Contínua para a convergência em probabilidade: se \(g:\mathbb {R}\to \mathbb {R}\) é contínua, então Seja \((\xi _n)\) uma sequência de variáveis aleatórias mutuamente independentes que converge em probabilidade para \(\xi \). Mostre que \(\xi \) é constante quase certamente. Dica. Escolha duas subsequências com índices disjuntos. Seus pares permanecem independentes, mas convergem em probabilidade para \((\xi ,\xi )\). Conclua que duas cópias independentes com a lei de \(\xi \) são iguais quase certamente. Prove que, se \(\xi _n\xrightarrow {\L ^2}\xi \), então Mostre diretamente que a convergência em \(\L ^p\) implica convergência em probabilidade para todo \(p\gt 0\). Dê um contraexemplo para a recíproca, por exemplo quando \(p=1\). Considere variáveis aleatórias \(\xi _1,\xi _2,\ldots \) com funções de distribuição \(F_1,F_2,\ldots \). Suponha que \(\xi _n\xrightarrow d\xi \) e que a função de distribuição \(F\) de \(\xi \) seja contínua. Prove que \(F_n\to F\) uniformemente, isto é, Considere variáveis aleatórias de valores inteiros \(\xi _1,\xi _2,\ldots \) e uma variável aleatória \(\xi \) também de valores inteiros. Mostre que \(\xi _n\xrightarrow d\xi \) se, e somente se, Na volta, justifique por que a massa não pode escapar para o infinito. Considere variáveis aleatórias independentes \(\xi _1,\xi _2,\ldots \), uniformemente distribuídas em \([0,1]\), e defina \(Z_n=\max _{k\leq n}\xi _k\). Prove que \(Z_n\to 1\) em probabilidade. Prove que \(Z_n\to 1\) quase certamente. Da hipergeométrica à binomial. Para cada \(n\geq 5\), uma urna contém \(n\) bolas azuis e \(n\) bolas vermelhas. Retiram-se dez bolas, sem reposição, e \(X_n\) denota o número de bolas azuis retiradas. Determine a lei de \(X_n\) e prove que Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Se \(\mu (\Omega )\lt \infty \) e \(f_n\to f\) quase certamente, prove que, para todo \(\varepsilon \gt 0\), existe \(A\) com \(\mu (A)\lt \varepsilon \) tal que \(f_n\to f\) uniformemente em \(A^c\).
Sugestão: para \(m,N\ge 1\), use
Ver solução
Ver solução
\(Q_n(U)\) tem distribuição \(F_n\) e \(Q(U)\) tem distribuição \(F\);
se \(u\) é ponto de continuidade de \(Q\), então \(Q_n(u)\to Q(u)\);
consequentemente, \(Q_n(U)\to Q(U)\) quase certamente.
Ver solução
Para \(k\) fixo, mostre que
\[ \mathbf{E}[(I_n)_k] =(n)_k(1-p_n)^{k(n-k)+\binom k2}. \]Prove que
\[ \mathbf{E}[(I_n)_k]\longrightarrow e^{-ck}. \]Use o critério de convergência por momentos fatoriais para concluir
\[ I_n\xrightarrow d\operatorname {Poisson}(e^{-c}). \]