Distribuições
6.1 Distribuição de uma variável aleatória
Uma variável aleatória induz uma probabilidade na reta,
Neste capítulo, essa lei passa a ser o objeto central. O espaço amostral fica em segundo plano e estudamos diretamente como uma distribuição pode ser descrita.
Dizemos que as variáveis aleatórias \(\xi \) e \(\eta \) são iguais quase certamente, fato que denotaremos por
\[ \xi \overset {\mathrm{q.c.}}{=} \eta , \]se \(\P (\xi \neq \eta )=0\).
Dizemos que \(\xi \) e \(\eta \) são iguais em distribuição, fato que denotaremos por
\[ \xi \overset {\mathrm d}{=} \eta , \]se tiverem a mesma lei, isto é,
\[ \P (\xi \in A)=\P (\eta \in A) \qquad \text{para todo }A\in \mathcal{B}(\mathbb {R}). \]
Se \(\xi \overset {\mathrm{q.c.}}{=}\eta \), então \(\xi \overset {\mathrm d}{=}\eta \), mas a recíproca não vale em geral. A igualdade quase certa compara duas variáveis no mesmo espaço de probabilidade; a igualdade em distribuição compara apenas suas leis.
A mesma construção vale em dimensão finita. Se \(\xi =(\xi _1,\ldots ,\xi _n)\) é um vetor aleatório, sua distribuição é a medida-imagem em \(\mathbb {R}^n\),
As distribuições de cada coordenada \(\xi _i\) são as distribuições marginais do vetor.
No restante do capítulo desenvolveremos descrições cada vez mais econômicas dessas leis, começando pela função de distribuição.
6.2 A função de distribuição
A função de distribuição \( F: \mathbb {R}\rightarrow [0,1] \) de uma variável aleatória \( \xi \) é definida como
\( F \) é não decrescente e \( 0 \leq F (x) \leq 1 .\)
\( F (x) \rightarrow 0 \) quando \( x \rightarrow - \infty \) e \( F (x) \rightarrow 1 \) quando \( x \rightarrow + \infty .\)
\( F \) é contínua à direita, ou seja
\[ \lim _{y \rightarrow x_+} F (y) = F (x). \]\( F \) possui limites à esquerda em todos os pontos. Além disso,
\[ F (x^-): = \lim _{y \rightarrow x^-} F (y) = \P (\xi \lt x). \]Em particular,
\[ \P (\xi = x) = F (x) - F (x^-). \]\( F \) possui no máximo número enumerável de descontinuidades.
Uma função \(F\) que é contínua à direita e possui limites à esquerda em todos os pontos é dita càdlàg, do francês continue à droite, limites à gauche.
Se \(x\lt y\), então \(\{ \xi \leq x\} \subseteq \{ \xi \leq y\} \), de onde \(F(x)\leq F(y)\). As cotas \(0\leq F\leq 1\) decorrem dos axiomas da probabilidade.
Como \(\{ \xi \leq -n\} \downarrow \varnothing \) e \(\{ \xi \leq n\} \uparrow \Omega \), a continuidade da probabilidade por cima e por baixo dá
\[ F(-n)\longrightarrow 0, \qquad F(n)\longrightarrow 1. \]A monotonicidade estende esses limites de sequências inteiras para \(x\to -\infty \) e \(x\to +\infty \).
Se \(x_n\downarrow x\), então \(\{ \xi \leq x_n\} \downarrow \{ \xi \leq x\} \). Pela continuidade por cima da probabilidade, \(F(x_n)\to F(x)\). Para uma sequência arbitrária \(y_n\gt x\) com \(y_n\to x\), ponha \(z_n=\sup _{k\geq n}y_k\). Então \(z_n\downarrow x\) e, pela monotonicidade,
\[ F(x)\leq F(y_n)\leq F(z_n). \]Como \(F(z_n)\to F(x)\), segue que \(F(y_n)\to F(x)\). Logo \(F\) é contínua à direita.
Se \(x_n\uparrow x\), com \(x_n\lt x\), então \(\{ \xi \leq x_n\} \uparrow \{ \xi \lt x\} \). Pela continuidade por baixo,
\[ F(x^-)=\lim _{n\to \infty }F(x_n)=\P (\xi \lt x). \]A monotonicidade mostra que o valor independe da sequência escolhida. Como \(\{ \xi \leq x\} \) é a união disjunta de \(\{ \xi \lt x\} \) e \(\{ \xi =x\} \),
\[ \P (\xi =x)=F(x)-F(x^-). \]Pela continuidade à direita, toda descontinuidade de \(F\) é um salto positivo. Para \(m\geq 1\), ponha
\[ D_m=\{ x:F(x)-F(x^-)\geq 1/m\} . \]Se \(x_1\lt \cdots \lt x_r\) pertencem a \(D_m\), então, pela monotonicidade,
\[ \frac rm \leq \sum _{j=1}^r\bigl(F(x_j)-F(x_j^-)\bigr) \leq 1. \]Portanto, \(D_m\) possui no máximo \(m\) pontos. O conjunto de descontinuidades é \(\bigcup _{m\geq 1}D_m\) e, assim, é no máximo enumerável.
Como \(\{ \xi \leq b\} \) é a união disjunta de \(\{ \xi \leq a\} \) e \(\{ a\lt \xi \leq b\} \),
o que prova a identidade.
Os intervalos \((-\infty ,x]\) formam um \(\pi \)-sistema que gera \(\mathcal B(\mathbb {R})\). Por isso, os valores de \(F\) já determinam toda a lei.
Sejam \(\xi \) uma variável aleatória definida em \((\Omega _1,\mathcal{F}_1,\P _1)\) e \(\eta \) uma variável aleatória definida em \((\Omega _2,\mathcal{F}_2,\P _2)\). Então \(\xi \overset {\mathrm d}{=}\eta \) se, e somente se,
De maneira equivalente, a distribuição \(\P _\xi \) de \(\xi \) está completamente determinada pelos valores de \(\P _1(\xi \leq x), x\in \mathbb {R}.\)
Se \(\xi \) e \(\eta \) têm a mesma distribuição, a igualdade nos intervalos \((-\infty ,x]\) é imediata. Reciprocamente, suponha que essas igualdades valham para todo \(x\in \mathbb {R}\). As probabilidades induzidas \(\P _\xi \) e \(\P _\eta \) coincidem no \(\pi \)-sistema
que gera \(\mathcal{B}(\mathbb {R})\). Pelo Teorema de Unicidade de Medidas (Teorema 2.12), elas coincidem em \(\mathcal{B}(\mathbb {R})\). Portanto, \(\xi \stackrel{\mathrm d}= \eta \).
O resultado distingue claramente igualdade em distribuição de igualdade quase certa. No espaço \(([0,1],\mathcal B([0,1]),\lambda )\), por exemplo, defina \(\xi (\omega )=\omega \) e \(\eta (\omega )=1-\omega \). Para todo \(x\in [0,1]\),
e as duas funções de distribuição coincidem também fora de \([0,1]\). Pelo Teorema 6.5, \(\xi \overset {\mathrm d}= \eta \). Entretanto, \(\P (\xi =\eta )=\P (\{ 1/2\} )=0\), de modo que elas não são iguais quase certamente.
6.3 Construindo uma distribuição a partir de uma função
Até aqui partimos de uma variável aleatória e obtivemos sua função de distribuição. Podemos inverter a pergunta: dadas as propriedades que acabamos de provar, elas são suficientes para construir uma distribuição?
\(F\) é não decrescente;
\(F\) é contínua à direita;
- \[ \lim _{x\to -\infty }F(x)=0, \qquad \lim _{x\to +\infty }F(x)=1. \]
Toda função de distribuição satisfaz essas condições. Mostraremos agora a recíproca, e a demonstração será construtiva: uma única variável uniforme em \((0,1)\) será suficiente para produzir qualquer lei na reta.
Dada uma candidata \(F\), procuraremos uma variável aleatória \(X\) tal que
A ideia é partir de uma variável \(U\sim \mathrm{Uniforme}(0,1)\) e procurar uma transformação \(F^*:(0,1)\to \mathbb {R}\) para a qual \(X=F^*(U)\) tenha a lei prescrita.
Para escolher \(F^*\), lembre que o que gostaríamos é que \(\P (X\le x)=\P (F^*(U)\le x)=F(x)\).
Para isso note primeiro que, como \(F(x)\in [0,1]\), então \(\P (U\le F(x))=F(x)\). Ou seja, queremos \(F^*\) tal que
Ou ainda, que \(F^*(u)\le x\Leftrightarrow u\le F(x)\).
Se \(F\) fosse inversível, poderíamos fazer \(F^*=F^{-1}\) e, como \(F\) é crescente teríamos que
Em geral \(F\) não é inversível, mas a construção ainda depende de “inverter” de algum modo a função de distribuição \(F:\mathbb {R}\to [0,1]\).
Como \(F\) é não decrescente, as dificuldades para uma inversão clássica se concentram em dois tipos de comportamento:
intervalos \((a,b)\) onde a função é constante;
pontos de descontinuidade de \(F\).
Não precisamos, porém, de uma inversa clássica. Basta uma função \(F^*:(0,1)\to \mathbb {R}\) que preserve a equivalência entre as desigualdades: \(F^*(\omega )\leq x\) se, e só se, \(F(x)\geq \omega \).
Uma maneira de resolver esse problema é tentar definir \(F^*\) de modo que
se \(F\) é inversível em \((a,b)\) então queremos que \(F^*(\omega )=F^{-1}(\omega )\) em \(F((a,b))\);
se \(F(x)=\omega \) para todo \(a\lt x\lt b\), então \(F^*\) é descontínua em \(\omega \);
se \(F(x)\) é descontínua em \(x=x_0\) com \(\omega _1=\lim \limits _{x\to x_0^-}F(x)\lt F(x_0)=\omega _2\), então \(F^*(\omega )=x_0\) para \(\omega \in (\omega _1,\omega _2)\).
Essas ideias são melhor visualizadas na Figura 6.1.
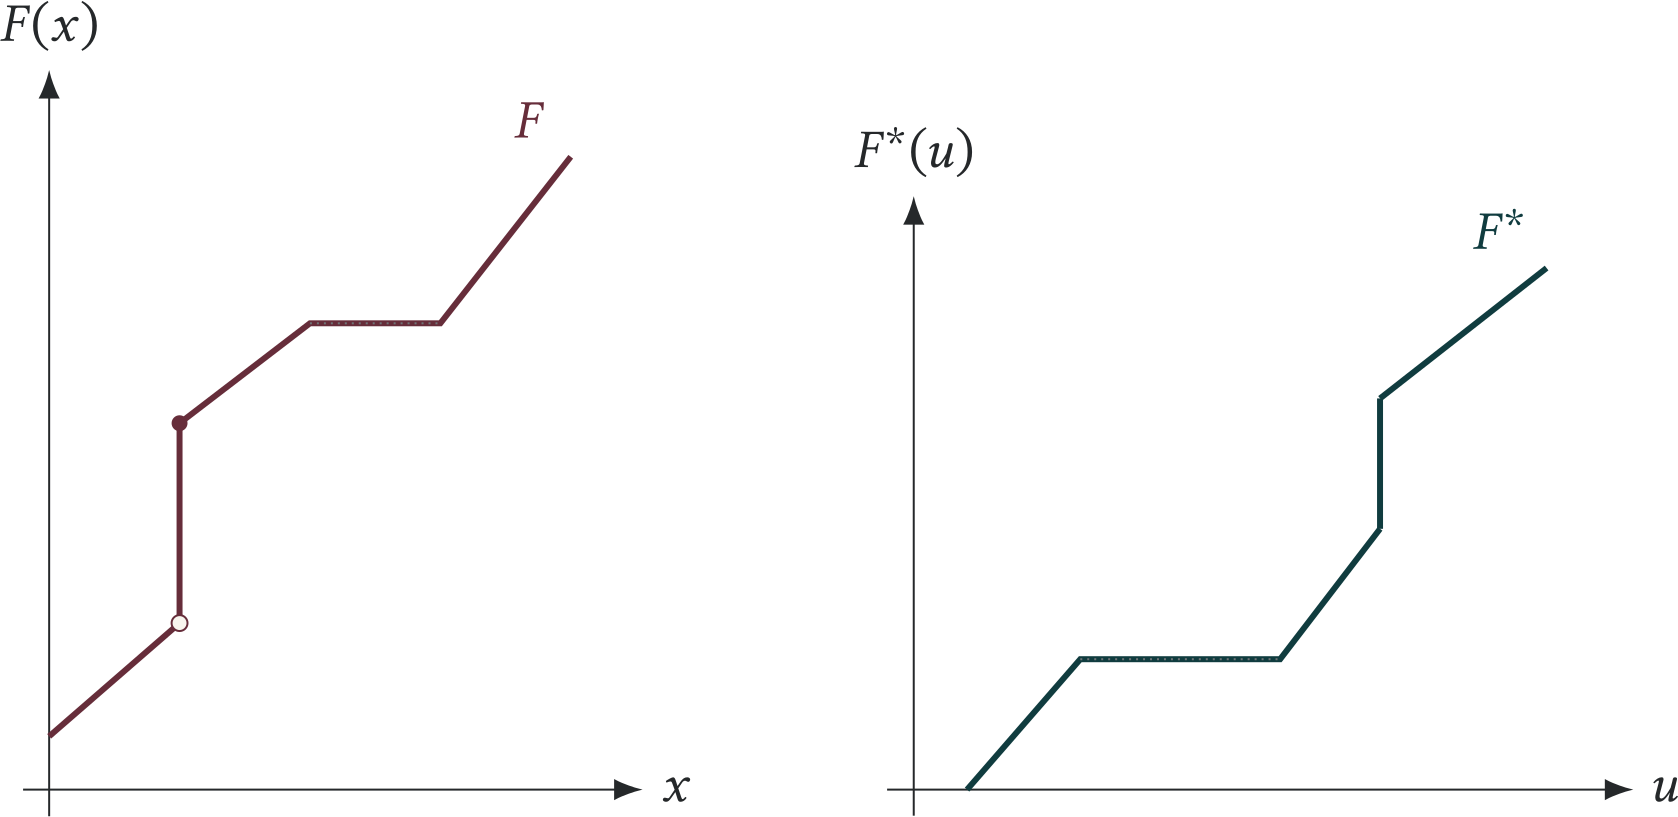
Existem diversas formas de definir uma função \(F^*\) com tais propriedades, e a seguir apresentaremos uma das mais comuns.
Apesar de não ser a inversa de \(F\), \(F^*\) ainda herda algumas propriedades de \(F\).
\(F^*(u)=\sup \{ x\in \mathbb {R}:F(x)\lt u\} \);
\(F^*\) é não decrescente;
se \(0\lt F(x)\lt 1\), então \(F^*(F(x))\leq x\);
\(F(F^*(u))\geq u\);
\(F^*(u)\leq x\) se e somente se \(u\leq F(x)\).
Para \(u\in (0,1)\), o conjunto \(A_u=\{ x:F(x)\geq u\} \) é não vazio e limitado inferiormente, em virtude dos limites de \(F\) em \(\pm \infty \). Portanto, \(F^*(u)\) é um número real.
Pela monotonicidade de \(F\), o complemento de \(A_u\) é \(B_u=\{ x:F(x)\lt u\} \), e todo elemento de \(B_u\) é menor que todo elemento de \(A_u\). Se \(a=\inf A_u\), então \(x\lt a\) implica \(x\in B_u\), enquanto \(x\gt a\) implica que existe \(z\in A_u\) com \(z\lt x\) e, pela monotonicidade, \(x\in A_u\). Logo \(\sup B_u=a=\inf A_u\).
Se \(u_1\lt u_2\), então \(A_{u_2}\subseteq A_{u_1}\), de modo que \(F^*(u_1)\leq F^*(u_2)\).
O ponto \(x\) pertence a \(A_{F(x)}\); portanto, o ínfimo desse conjunto é menor ou igual a \(x\).
Ponha \(a=F^*(u)\). Para cada \(n\), escolha \(y_n\in A_u\) com \(a\leq y_n\lt a+1/n\) e defina \(x_n=\min \{ y_1,\ldots ,y_n\} \). Então \(x_n\downarrow a\), pois \(a\leq x_n\leq y_n\lt a+1/n\). Pela continuidade de \(F\) à direita,
\[ F(a)=\lim _nF(x_n)\geq u. \]Se \(F^*(u)\leq x\), o item anterior e a monotonicidade dão \(u\leq F(F^*(u))\leq F(x)\). Reciprocamente, se \(u\leq F(x)\), então \(x\in A_u\) e, por definição, \(F^*(u)\leq x\).
Com isso, dada uma variável aleatória \(U\) definida em um espaço de probabilidade \((\Omega , \mathcal{F}, \P )\), e uniformemente distribuída no intervalo \((0,1)\), podemos definir a variável aleatória
e perceber que para \(x\in \mathbb {R}\) temos \(F(x)\in [0,1]\), e portanto
onde na última igualdade usamos que a probabilidade que a uniforme seja menor que \(y\) é \(y\), i.e., \(\P (U\leq y)=y\)
Mostramos assim o seguinte resultado.
Tome \(\Omega =(0,1)\), \(\mathcal{F}=\mathcal{B}((0,1))\), \(\P =\lambda |_{(0,1)}\) e \(U(\omega )=\omega \). Pelo item 5 da Proposição 6.8,
que é boreliano. Portanto, \(F^*\) é Borel mensurável e \(X=F^*(U)\) é uma variável aleatória. Novamente pelo mesmo item,
Como \(U\) é uniforme em \((0,1)\),
para todo \(x\in \mathbb {R}\).
Portanto, toda candidata a função de distribuição é efetivamente a função de distribuição de alguma variável aleatória. A partir deste ponto, podemos usar simplesmente a expressão função de distribuição para funções com essas propriedades.
A função \(F\) já possui no máximo um número enumerável de descontinuidades. Para usar a construção acima mais adiante, convém registrar que o mesmo vale para a inversa generalizada \(F^*\). O fato é uma propriedade geral de funções monótonas.
Se \(f:I\to \mathbb {R}\) é uma função não decrescente definida em um intervalo \(I\subseteq \mathbb {R}\), então o conjunto \(D_f\) formado pelos pontos de descontinuidade de \(f\) é no máximo enumerável.
O mesmo resultado vale para \(f\) não-crescente.
Suponha primeiro que \(f\) seja não decrescente. Em todo ponto interior \(a\) de \(I\), os limites laterais
existem. Se \(a\in D_f\) é interior a \(I\), então \(f(a-)\lt f(a+)\); logo o intervalo \(I_a=(f(a-),f(a+))\) é não vazio.
Se \(a_1\lt a_2\), então \(f(a_1+)\leq f(a_2-)\), de modo que \(I_{a_1}\) e \(I_{a_2}\) são disjuntos. Escolha um racional \(r(a)\in I_a\) para cada ponto de descontinuidade interior. O mapa \(a\mapsto r(a)\) é injetivo e toma valores em \(\mathbb {Q}\); portanto há no máximo um número enumerável desses pontos. Os extremos de \(I\), quando pertencem a \(I\), acrescentam no máximo dois pontos.
Para uma função não crescente, aplique o resultado a \(-f\).
As funções \(F\) e \(F^*\) são não decrescentes; basta aplicar a proposição anterior a cada uma delas.
A construção também permite fixar uma terminologia que usaremos repetidamente.
6.4 Distribuições discretas
A primeira possibilidade é que toda a massa da distribuição esteja concentrada num conjunto enumerável.
Podemos enumerar o conjunto \(S\), escrevendo \( S = \{ x_1, x_2, \ldots \} \), e definimos \( p_k: = \P (\xi = x_k) .\) Então temos
e esta é uma soma sobre um conjunto enumerável. Estes \( p_k \) às vezes são denominados massas pontuais.
Massa de um ponto em zero:
\[ \P (\xi = 0) = 1. \]Portanto, a função de distribuição \( F \) é:
\[ F (x) = \left\{ \begin{array}{ll} 0 & , x \lt 0 \\ 1 & , x \geq 0 \end{array} \right. \]A distribuição correspondente é a medida de Dirac no \(0\).
Qualquer variável aleatória simples é discreta. Uma variável aleatória simples é uma variável aleatória que toma um número finito de valores.
Uma distribuição discreta não precisa manter seus átomos afastados: podemos tomar \( S = \mathbb {Q}\) e atribuir massas positivas que somem \( 1 \), por exemplo, \( p_k = \frac1{2 ^k} \), após enumerar os racionais. A distribuição é discreta; o conjunto de seus átomos não tem a mesma obrigação.
Algumas Distribuições Discretas
| Distribuição | Notação | Função de Probabilidade | Domínio |
|---|---|---|---|
| Um ponto | $\delta_a$ | $p(a)=1$ | $\{a\}$ |
| Uniforme Discreta | $\mathrm{Unif}\{x_1,\ldots,x_n\}$ | $p(x_i)=\frac{1}{n}$ | $\{x_1,\ldots,x_n\}$ |
| Bernoulli | $\operatorname{Be}(p)$ | $p(0)=q$, $p(1)=p$ | $\{0,1\}$ |
| Binomial | $\operatorname{Bin}(n,p)$ | $p(k)=\binom nkp^kq^{n-k}$ | $k=0,1,\dots,n$ |
| Geométrica (fracassos) | $\operatorname{Ge}_0(p)$ | $p(k)=pq^k$ | $k\in\N_0$ |
| Primeiro Sucesso | $\operatorname{Ge}_1(p)$ | $p(k)=pq^{k-1}$ | $k\in\N$ |
| Poisson | $\operatorname{Poisson}(\lambda)$ | $p(k)=e^{-\lambda}\frac{\lambda^k}{k!}$ | $k\in\N_0$ |
A distribuição uniforme discreta assume os valores \(x_1,\dots x_n\) e \(p(x_i)=\dfrac {1}{n} .\) Aqui e nas linhas seguintes, \(q=1-p\). A distribuição \(\operatorname {Be}(p)\) descreve o resultado de um experimento de lançamento de moeda (não necessariamente honesta), e a distribuição \(\operatorname {Bin}(n,p)\) descreve o número de sucessos em \(n\) lançamentos. A distribuição \(\operatorname {Ge}_0(p)\) descreve o número de fracassos antes do primeiro sucesso, enquanto \(\operatorname {Ge}_1(p)\) descreve o número de lançamentos necessários até o primeiro sucesso.
A distribuição de Poisson surge como o limite da distribuição binomial quando \(n \to \infty \) e \(p \to 0\) e \(np \to \lambda .\)
Para \(n\) suficientemente grande, temos \(n\geq k\) e \(p_n\lt 1\), e então
Os dois primeiros fatores convergem, respectivamente, para \(1\) e \(\lambda ^k/k!\), e o último converge para \(1\). Como \(p_n\to 0\),
com a razão interpretada por continuidade quando \(p_n=0\). Logo \((1-p_n)^n\to e^{-\lambda }\), e o produto dos quatro limites dá a conclusão. Quando \(k=0\), usa-se a convenção \(\lambda ^0=1\), inclusive para \(\lambda =0\).
6.5 Densidades e distribuições absolutamente contínuas
A distribuição de \(\xi \) é absolutamente contínua se existir uma função \(f\), denominada densidade de \(\xi \), tal que
Claramente, é necessário que \( f \geq 0 \) e que
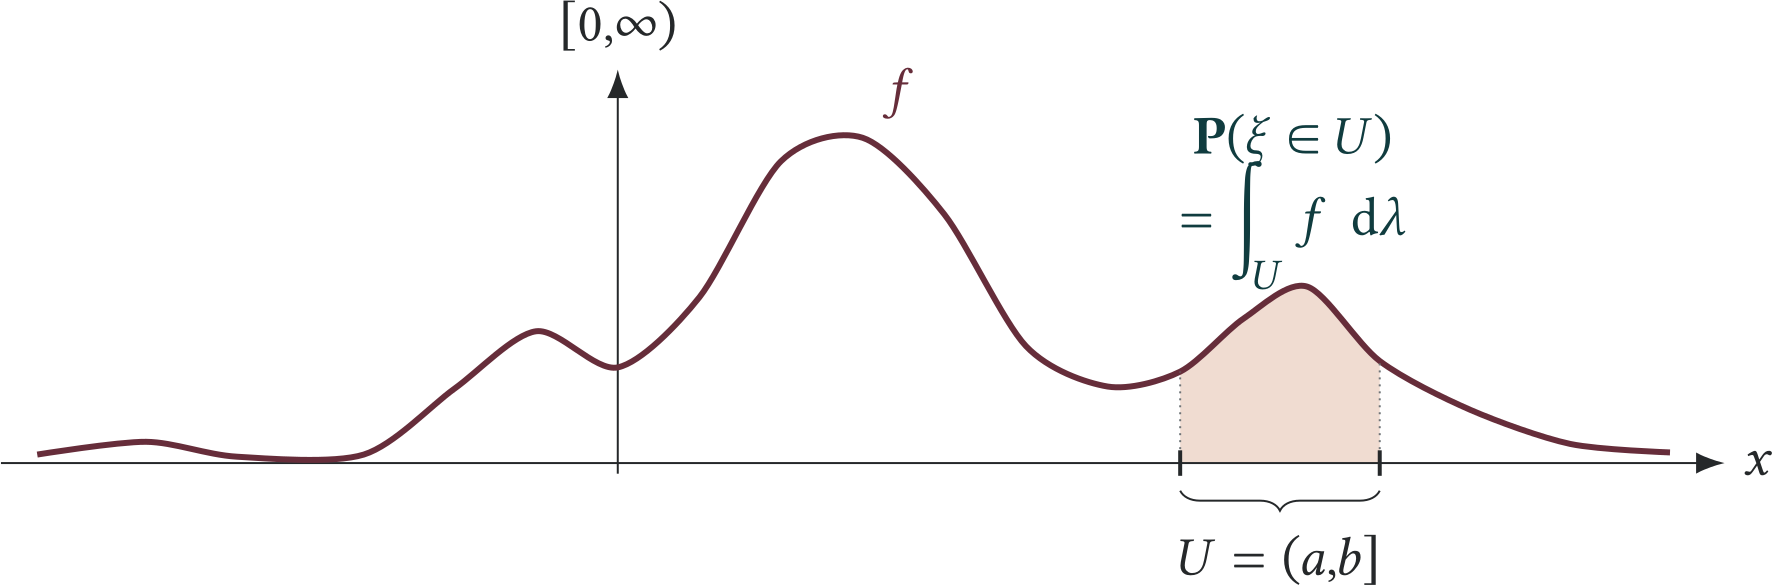
Em particular, se \( f \) for contínua, então
\[ F '(x) = f (x), \]ou seja, é a derivada de uma função de distribuição.
Então, podemos dizer
\[ \P (\xi \in (a, b]) = F (b) - F (a) = \displaystyle \int _a ^b f (x) \ dx. \]Alternativamente, podemos começar com uma função \( f \) tal que
\[ f \geq 0 \qquad \text{e} \qquad \displaystyle \int _{- \infty } ^\infty f (x) \ dx = 1, \]e definir a função de distribuição pela fórmula
\[ F (x): = \displaystyle \int _{- \infty } ^x f (y) \ dy. \]
Uma densidade não é determinada ponto a ponto, mas apenas quase certamente. O exemplo seguinte torna isso explícito.
Alice secretamente escolhe dois números reais diferentes por um processo desconhecido e os coloca em dois envelopes. Bob escolhe um dos dois envelopes aleatoriamente (com um lançamento de uma moeda justa) e mostra o número desse envelope. Agora você deve adivinhar se o número no outro envelope fechado é maior ou menor que o que você viu.
Existe uma estratégia que lhe dê uma chance melhor do que 50% de adivinhar corretamente, não importando o procedimento que Alice usasse para escolher seus números?
Solução:
Antes de abrir qualquer envelope, você escolhe um número \(r\) de forma aleatória, independentemente da escolha de Bob, usando uma distribuição absolutamente contínua que dê probabilidade positiva a todo intervalo aberto; a distribuição normal padrão é um exemplo. Vamos chamar de \(x\) o número do envelope aberto por Bob.
A estratégia agora é: se \(r \lt x\), então você prevê que o número oculto \(y\) é menor que \(x\); Caso contrário, você adivinha que \(y\) é maior do que \(x .\)
Para ver por que a estratégia é vencedora, denote os dois números de Alice por \(a\lt b\) e ponha \(\varepsilon =\P (a\lt r\lt b)\gt 0\). Existem três casos:
Se \(r\lt a\), a regra sempre prevê que o número oculto é menor. Ela acerta exatamente quando Bob mostra \(b\), o que ocorre com probabilidade \(1/2\).
Se \(r\gt b\), a regra sempre prevê que o número oculto é maior. Ela acerta exatamente quando Bob mostra \(a\), novamente com probabilidade \(1/2\).
Se \(a\lt r\lt b\), a regra acerta qualquer que seja o envelope mostrado.
Portanto, a probabilidade de vitória é
O número auxiliar não precisa adivinhar os de Alice: basta ter uma chance positiva de cair entre eles.
Distribuição Uniforme Contínua
Uma variável aleatória \(\xi \) tem distribuição uniforme no intervalo \([a,b]\), para \(a\lt b\), se sua lei é absolutamente contínua e sua densidade é
e denotamos esse fato por \(\xi \sim \mathrm{Uniforme}([a,b]) .\)
Nesse caso, a probabilidade de \(\xi \) estar num subintervalo de \([a,b]\) é proporcional ao comprimento de tal subintervalo; de fato, para \(a\leq y\lt z\leq b\),
Distribuição Exponencial
Uma variável aleatória \(\xi \) tem distribuição exponencial com parâmetro \(\lambda \gt 0\), e denotamos esse fato por
se sua função de densidade é
A função de distribuição é
Portanto, \(\P (\xi \gt a) = \mathrm{e}^{-\lambda a}\) para \(a\geq 0\).
Distribuição Normal
Sejam \(\mu \in \mathbb {R}\) e \(\sigma \gt 0\). A variável aleatória \(\xi \) possui distribuição normal com média \(\mu \) e variância \(\sigma ^2\), abreviado por \(\xi \sim \mathcal{N}(\mu ;\sigma ^2)\), se sua densidade é dada por
Em particular, a distribuição normal padrão \(\mathcal{N}(0;1)\) tem densidade
6.6 Distribuições singulares contínuas
As distribuições discretas concentram massa em pontos; as absolutamente contínuas espalham a massa segundo uma densidade. Existe ainda um terceiro comportamento. Diremos que uma distribuição é singular contínua quando sua medida de probabilidade é singular em relação à medida de Lebesgue e não possui átomos. Assim, toda a massa fica concentrada num conjunto de medida de Lebesgue zero, mas nenhum ponto individual carrega massa positiva.
Em termos da função de distribuição, a ausência de átomos equivale à continuidade. A caracterização analítica usual por derivada nula quase certamente será retomada depois da decomposição de Lebesgue–Radon–Nikodým. No exemplo de Cantor, porém, essa propriedade será visível diretamente.
O exemplo canônico é a distribuição de Cantor.
Distribuição uniforme no conjunto de Cantor
Retomemos a construção do conjunto de Cantor do Capítulo 2; veja a Figura 2.6. Escreva \(C_n\) para a união dos \(2^n\) intervalos restantes após \(n\) etapas e
Cada componente de \(C_n\) tem comprimento \(3^{-n}\); portanto
O que nos interessa agora não é reconstruir \(C\), mas colocar sobre ele uma lei contínua sem densidade.
Construiremos uma função de distribuição que cresce sobre o conjunto de Cantor e permanece constante nos intervalos removidos. Defina
e seja \(\nu _n\) a probabilidade com densidade \(f_n\). Se \(\mathcal I_n\) denota a coleção dos \(2^n\) intervalos componentes de \(C_n\), então cada \(J\in \mathcal I_n\) tem comprimento \(3^{-n}\) e
Mais geralmente, para \(k\geq 0\),
Fixados \(x\in \mathbb {R}\) e \(k\geq 0\), todos os componentes de \(\mathcal I_n\) inteiramente à esquerda de \(x\) dão a mesma contribuição a \(F_n(x)\) e \(F_{n+k}(x)\). Há no máximo um componente de nível \(n\) cortado pelo ponto \(x\), e a massa que cada uma das duas probabilidades atribui a esse componente é no máximo \(2^{-n}\). Consequentemente,
Logo \((F_n)\) é uniformemente de Cauchy. Seu limite uniforme \(F\) é contínuo, não decrescente, vale \(0\) à esquerda de \(0\) e vale \(1\) à direita de \(1\); portanto, é uma função de distribuição.
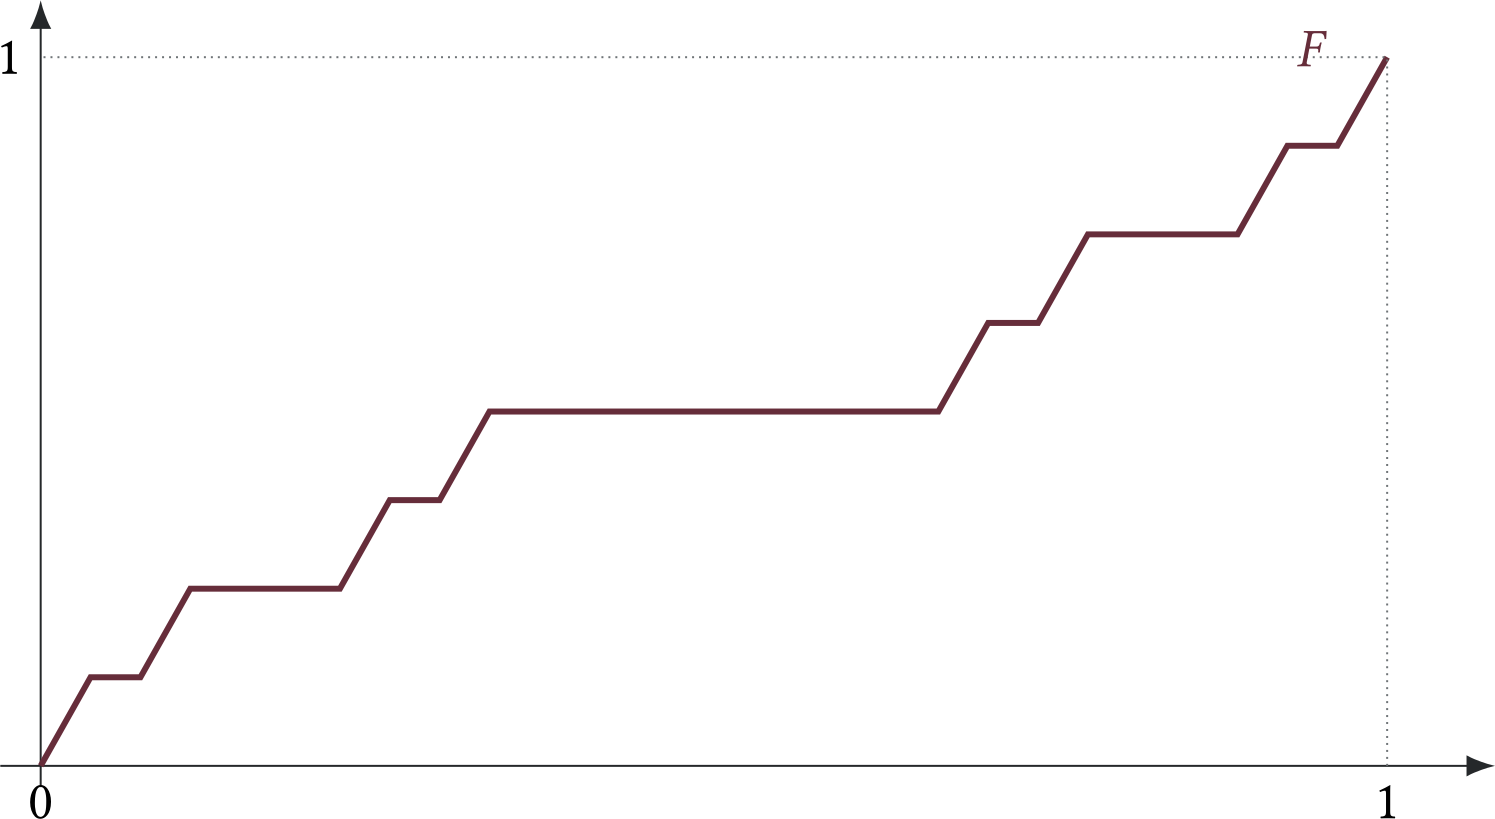
Cada componente de \([0,1]\setminus C\) foi removida em alguma etapa. A partir dessa etapa, todas as funções \(F_n\) são constantes nessa componente, e o mesmo vale para \(F\). Como \(\lambda (C)=0\), segue que \(F'=0\) quase certamente. Assim, \(F\) é uma função de distribuição singular contínua. Ela não pode ter densidade: se \(F(x)=\int _{-\infty }^x h(t)\, \d t\), então \(h=F'=0\) quase certamente, o que contradiz \(\int _{\mathbb {R}} h\, \d\lambda =1\).
A construção probabilística correspondente, por lançamentos de moedas, é desenvolvida no Exercício 6.6, ao final do capítulo.
6.7 Decomposição de distribuições
Vimos três mecanismos distintos: massa concentrada em pontos, massa descrita por uma densidade e massa contínua concentrada num conjunto de medida de Lebesgue zero. O resultado desta seção mostra que não falta um quarto tipo: toda distribuição é obtida combinando exatamente esses três comportamentos.
Começamos separando os átomos da parte contínua.
Seja \(\nu \) a medida de probabilidade cuja função de distribuição é \(F\). Já provamos que \(F\) possui no máximo um número enumerável de saltos; enumere seus pontos como \(\{ x_j\} _{j\geq 1}\) e defina
A série \(\sum _jp_j\) é no máximo \(1\). A fórmula
define uma medida finita e discreta. Além disso, \(\nu _d\leq \nu \): para um conjunto \(A\) e um subconjunto finito \(J\) dos índices com \(x_j\in A\),
e basta fazer os subconjuntos finitos crescerem. Logo \(\nu _c:=\nu -\nu _d\) é também uma medida finita e positiva.
Ponha \(\beta =\nu _d(\mathbb {R})\) e \(\alpha =\nu _c(\mathbb {R})=1-\beta \). Se \(\beta \gt 0\), normalize \(\nu _d/\beta \) e denote sua função de distribuição por \(F_d\); se \(\beta =0\), escolha qualquer função de distribuição discreta para \(F_d\). Analogamente, se \(\alpha \gt 0\), normalize \(\nu _c/\alpha \) e denote sua função de distribuição por \(F_c\). A medida \(\nu _c\) não possui átomos, pois retiramos precisamente todas as massas pontuais de \(\nu \). Assim,
quando \(\alpha \gt 0\); pela continuidade à direita, \(F_c\) é contínua. Se \(\alpha =0\), escolha qualquer função de distribuição contínua para \(F_c\). Finalmente,
e \(\alpha +\beta =1\).
A etapa restante consiste em decompor a parte contínua. Esse passo é estruturalmente uma decomposição de medidas e ficará mais natural quando dispormos do teorema de Lebesgue–Radon–Nikodým.
A demonstração será dada no Capítulo 13, como consequência da decomposição de Lebesgue–Radon–Nikodým da medida associada a \(F\) em relação à medida de Lebesgue.
Combinando esse enunciado com a separação elementar dos átomos, obtemos a classificação completa.
\(F_{ac}\) é absolutamente contínua;
\(F_d\) é discreta;
\(F_s\) é singular contínua.
Pelo Teorema 6.17, escrevemos
com \(F_d\) discreta e \(F_c\) contínua. Aplicando o Teorema 6.18 a \(F_c\), obtemos \(F_c=rF_{ac}+sF_s\), com \(r+s=1\). Substituindo,
A existência da decomposição de \(F_c\), usada neste argumento, será provada no Capítulo 13.
Toda distribuição na reta se decompõe, portanto, nesses três tipos fundamentais.
Variáveis aleatórias discretas independentes. Sejam \(X\) e \(Y\) variáveis aleatórias independentes com valores inteiros. Prove que, para todo \(n\in \mathbb {Z}\), Se \(X\sim \operatorname {Poisson}(\lambda )\) e \(Y\sim \operatorname {Poisson}(\mu )\), determine a distribuição de \(X+Y\). Se \(X\sim \operatorname {Binomial}(n,p)\) e \(Y\sim \operatorname {Binomial}(m,p)\), determine a distribuição de \(X+Y\). A lei de uma variável aleatória. Seja \(X:(\Omega ,\mathcal F,\P )\to \mathbb {R}\) uma variável aleatória. Para \(A\in \mathcal B(\mathbb {R})\), defina Prove diretamente que \(P_X\) é uma medida de probabilidade em \((\mathbb {R},\mathcal B(\mathbb {R}))\). Seja \(F:\mathbb {R}\to [0,1]\) uma função não decrescente, contínua à direita e tal que Construa explicitamente um espaço de probabilidade e uma variável aleatória \(X\) cuja função de distribuição seja \(F\). Dica. Tome uma variável uniforme \(U\) em \((0,1)\) e use uma inversa generalizada de \(F\). Sejam \(Y_1,Y_2,\ldots \) variáveis aleatórias independentes, com e defina Mostre que a série converge para um valor em \([0,1]\). Para \(U_n=\sum _{k=1}^{n}2^{-k}Y_k\), calcule a função de distribuição de \(U_n\) nos pontos diádicos. Passando ao limite, prove que \(U\) possui distribuição uniforme em \([0,1]\). Explique por que a dupla representação binária dos racionais diádicos não altera a conclusão. Escreva Prove, usando apenas transformações mensuráveis, que Outra construção da distribuição de Cantor. Sejam \(Y_1,Y_2,\ldots \) como no exercício da expansão binária e defina Prove que \(Y\) toma valores no conjunto de Cantor e que sua função de distribuição \(F_Y\) é contínua. Mostre que \(F_Y\) é constante em cada componente conexa de \([0,1]\setminus C\), onde \(C\) é o conjunto de Cantor. Conclua que \(F_Y'(x)=0\) para Lebesgue-quase todo \(x\). Seja \(\mu _Y\) a lei de \(Y\) e \(\lambda \) a medida de Lebesgue. Prove que \(\mu _Y\) e \(\lambda \) são mutuamente singulares, isto é, encontre um boreliano \(A\) tal que \(\lambda (A)=0\) e \(\mu _Y(A^c)=0\). Recorde que uma variável aleatória \(Y\) é estocasticamente maior do que \(X\) quando Prove que essa relação vale se, e somente se, existem variáveis \(X^*\) e \(Y^*\), definidas no mesmo espaço de probabilidade, tais que Dica. Para uma das implicações, use o mesmo uniforme nas inversas generalizadas das duas funções de distribuição. Convenções para a inversa generalizada. Seja \(F\) uma função de distribuição e, para \(t\in (0,1)\), defina Prove que \(F^{-1}_1=F^{-1}_2\) e que \(F^{-1}_3=F^{-1}_4\). Dê um exemplo de função de distribuição e de \(t\in (0,1)\) para os quais \(F^{-1}_1(t)\neq F^{-1}_3(t)\). Para um conjunto não vazio \(S_t=\{ y:F(y)\geq t\} \), monotonicidade e continuidade à direita mostram que sua extremidade esquerda é simultaneamente \(\inf S_t\) e \(\sup \{ y:F(y)\lt t\} \); logo \(F_1^{-1}=F_2^{-1}\). Aplicando o mesmo argumento a \(\{ F\gt t\} \) obtém-se \(F_3^{-1}=F_4^{-1}\). Se \(X\) é Bernoulli\((1/2)\) em \(\{ 0,1\} \) e \(t=1/2\), então \(F_1^{-1}(t)=F_2^{-1}(t)=0\), enquanto \(F_3^{-1}(t)=F_4^{-1}(t)=1\).
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Distribuição induzida por geometria. Um ponto é escolhido uniformemente na bola unitária
isto é, a probabilidade de uma região boreliana \(A\subseteq B\) é \(\lambda _2(A)/\pi \). Se \(X\) é a distância do ponto escolhido à origem, determine a função de distribuição de \(X\).
Ver solução
Ver solução
Prove que \(D_v\sim \operatorname {Binomial}(n-1,p)\).
Para \(u\ne v\), escreva
\[ D_u=X_{uv}+A,\qquad D_v=X_{uv}+B, \]com \(A,B,X_{uv}\) independentes, e determine suas leis.
Calcule \(\operatorname {Cov}(D_u,D_v)\) e \(\operatorname {Corr}(D_u,D_v)\).