Leis dos grandes números
Com os modos de convergência já distinguidos, podemos formular com precisão as leis dos grandes números. Para somas
estudaremos condições sob as quais \(S_n/n\) se aproxima da média comum. As versões fraca e forte diferem justamente pelo modo de convergência envolvido.
11.1 Lei fraca dos grandes números
A lei fraca afirma a convergência de \(S_n/n\) em probabilidade. Com variâncias uniformemente limitadas, obtemos primeiro a convergência em \(\L ^2\); a desigualdade de Chebyshev fornece então a convergência em probabilidade.
Basta mostrar que
A convergência em probabilidade seguirá da convergência em \(\L ^2\), pela desigualdade de Chebyshev.
Pela linearidade da esperança, \(\mathbf{E}\left[\dfrac {S_n}{n}\right] = \mu .\) A independência permite somar as variâncias:
A demonstração fornece uma taxa \(O(n^{-1})\) para o erro quadrático médio e, por Chebyshev, para a probabilidade de um desvio fixo. A estimativa ainda não é somável em \(n\): para concluir convergência quase certa por Borel–Cantelli, precisaremos de outro argumento.
A mesma ideia se estende a vetores aleatórios de dimensão finita.
Escreva \(\boldsymbol {\xi }^{(i)}=(\xi ^{(i)}_1,\ldots ,\xi ^{(i)}_d)\). Cada sequência de coordenadas \(\xi ^{(1)}_j,\xi ^{(2)}_j,\ldots \) satisfaz as hipóteses do Teorema 11.1; logo, para todo \(j\),
Para a norma do máximo e qualquer \(\varepsilon \gt 0\), a probabilidade de que o vetor se afaste de sua média por mais de \(\varepsilon \) é limitada pela soma das \(d\) probabilidades correspondentes às coordenadas. Como \(d\) é finito, essa soma tende a zero.
O caso dos ensaios de Bernoulli antecede historicamente as versões gerais. Nele, a média amostral é a frequência relativa de sucessos, e a lei dos grandes números dá uma forma precisa à interpretação frequentista da probabilidade.
Se \(\xi _k\) é a indicadora de sucesso no \(k\)-ésimo ensaio, então as variáveis \(\xi _k\) são independentes, \(S_n=\sum _{k=1}^n\xi _k\), \(\mathbf{E}[\xi _k]=p\) e \(\operatorname {Var}(\xi _k)=p(1-p)\leq 1/4\). Basta aplicar o Teorema 11.1.
Podemos dispensar a hipótese de variância finita se, em contrapartida, supusermos que as variáveis aleatórias \( \xi _k \) são identicamente distribuídas. A ferramenta será o método de truncamento de Markov: primeiro controlamos variáveis limitadas e depois estimamos a contribuição das caudas.
Mais adiante, um exercício apresenta uma extensão para somas independentes não necessariamente identicamente distribuídas.
\(|\xi ^{(M)}|\leq M\) e \(|\xi ^{(M)}|\leq |\xi |\);
\(\xi ^{(M)}\to \xi \) pontualmente quando \(M\to \infty \);
\(\xi ^{(M)}\) possui momentos de todas as ordens;
- \begin{equation} \label{nov21} \mathbf{E}[\xi ^{(M)}]\longrightarrow \mathbf{E}[\xi ], \qquad \mathbf{E}|\xi ^{(M)}-\xi |\longrightarrow 0 \qquad (M\to \infty ). \tag{11.1} \end{equation}
As duas primeiras afirmações seguem diretamente da definição. Além disso, para todo \(r\gt 0\), \(|\xi ^{(M)}|^r\leq M^r\), de modo que todos os momentos são finitos.
Por fim, \(|\xi ^{(M)}|\leq |\xi |\) e \(\xi ^{(M)}\to \xi \); como \(\xi \) é integrável, o Teorema da Convergência Dominada dá a convergência das esperanças. Aplicando-o também a \(|\xi ^{(M)}-\xi |=|\xi |\mathbb {1}_{\{ |\xi |\gt M\} }\), obtemos (11.1).
Pela definição do truncamento,
A conclusão é exatamente (11.1).
Para \(M\gt 1\), defina
As variáveis \(\xi _k^{(M)}\) continuam i.i.d. e
Pelo Teorema 11.1,
Em particular, por Cauchy–Schwarz,
Pela desigualdade triangular e pela distribuição comum,
Portanto, para todo \(M\) fixo,
Fazendo \(M\to \infty \) e usando (11.1), concluímos na verdade que \(S_n/n\to \mu \) em \(\L ^1\) e, portanto, em probabilidade.
11.2 Desigualdade maximal de Kolmogorov
A lei fraca controla a soma num instante fixo. Uma ferramenta clássica para passar desse controle pontual ao comportamento das somas parciais é estimar o maior desvio ocorrido até um dado instante. A desigualdade maximal de Kolmogorov fornece esse controle.
Seja \( (\xi _n) _{n \ge 1} \) uma sequência de variáveis aleatórias independentes, definidas no mesmo espaço de probabilidade, com esperança \(0\) e variância finita. Seja \(S_n = \sum _{k = 1} ^n \xi _k \). Então para \( \lambda \gt 0 \),
O evento \( \{ \max _{1 \le k \le n} | S_k | \ge \lambda \} \) é a união disjunta dos eventos
Para cada \(k=1,\ldots ,n\), \(S_n-S_k=\xi _{k+1}+\cdots +\xi _n\), que é independente da \(\sigma \)-álgebra gerada por \(\xi _1,\ldots ,\xi _k\). Em particular, é independente de \(S_k\mathbb {1}_{A_k}\).
Como \(\mathbf{E}[S_n-S_k]=0\), a independência fornece
No evento \(A_k\), vale \(\lambda ^{-2}S_k^2\geq 1\), de modo que \(\mathbb {1}_{A_k}\leq \lambda ^{-2}S_k^2\mathbb {1}_{A_k} \), e
onde a última igualdade decorre do termo misto nulo calculado acima.
Portanto,
Somando sobre os eventos disjuntos \(A_k\), encontramos
Como \(\mathbf{E}[S_n]=0\), temos \(\mathbf{E}[S_n^2]=\operatorname {Var}(S_n)\), e a conclusão segue.
11.3 Lei forte dos grandes números
Na lei fraca, o conjunto em que a média se afasta de \(\mu \) pode mudar com \(n\); exigimos apenas que sua probabilidade tenda a zero. A lei forte afirma algo sobre a sequência inteira: para variáveis i.i.d. integráveis,
Começaremos pelo caso de quarto momento finito. A estimativa resultante será somável, o que permitirá aplicar Borel–Cantelli; depois removeremos essa hipótese adicional.
Comecemos pelo caso \(\mu =0\). O caso geral segue ao aplicar esse caso às variáveis centradas \(\xi _k-\mu \), que ainda são i.i.d. e têm quarto momento finito.
Na expansão
todo termo em que algum índice aparece uma única vez é nulo, por independência e pelo fato de \(\mathbf{E}[\xi _i]=0\). Restam os \(n\) termos com os quatro índices iguais e, para cada par de índices distintos, as seis ordenações que os fazem aparecer duas vezes cada. Portanto,
Como a independência dá \(\mathbf{E}[\xi _1^2\xi _2^2]=(\mathbf{E}[\xi _1^2])^2\leq \mathbf{E}[\xi _1^4]\), existe \(C\lt \infty \) tal que
Consequentemente, pela desigualdade de Markov aplicada a \(S_n^4\),
A série do lado direito é convergente. Pelo primeiro lema de Borel–Cantelli, para cada \(m\geq 1\),
Fora da união enumerável desses eventos nulos, para cada \(m\) existe um índice a partir do qual \(|S_n/n|\leq 1/m\). Portanto \(S_n/n\to 0\) quase certamente.
O resultado se estende a vetores de dimensão finita pela aplicação do caso escalar a cada coordenada.
Cada coordenada satisfaz a versão escalar precedente. Como há apenas \(d\) coordenadas, a interseção dos \(d\) eventos de probabilidade um em que as convergências coordenada a coordenada ocorrem ainda tem probabilidade um. Em dimensão finita, convergência coordenada a coordenada equivale à convergência em qualquer norma.
A fórmula das caudas, Proposição 7.24, aplicada a \(|\xi _1|\) implica
Como as variáveis são identicamente distribuídas, a mesma série é \(\sum _n\P (|\xi _n|\gt n)\). Os eventos \(\{ |\xi _n|\gt n\} \) são independentes; portanto, o segundo lema de Borel–Cantelli dá
Por outro lado, se \(S_n/n\) convergisse em um ponto \(\omega \), então
Isso é incompatível com \(|\xi _n|/n\gt 1\) infinitas vezes. Logo o evento de convergência está contido no complementar de um evento de probabilidade um e, portanto, tem probabilidade zero.
Combinaremos o truncamento com o controle das médias ao longo de uma subsequência geométrica.
Passo 1: redução ao caso não negativo. Suponha primeiro que \(\xi _k\geq 0\). Ao final, o caso geral seguirá de \(\xi _k=\xi _k^+-\xi _k^-\), pois as partes positiva e negativa são integráveis e cada uma forma uma sequência i.i.d.
Passo 2: truncamento. Defina
Pela representação por camadas do Corolário 8.12,
O primeiro lema de Borel–Cantelli mostra que \(Y_k=\xi _k\) para todo \(k\) suficientemente grande, quase certamente. Assim, \((S_n-T_n)/n\to 0\) quase certamente.
Os truncamentos \(Y_k\) são independentes, mas seus níveis de corte variam com \(k\), de modo que já não são identicamente distribuídos. Suas médias e variâncias devem, por isso, conservar esse índice. Como \(0\leq Y_k\leq k\), a mesma representação por camadas, agora com \(r=2\), dá
Por Tonelli,
De fato, a soma interna é limitada por uma constante para \(0\leq t\lt 1\) e por \(2/t\) para \(t\geq 1\); a última integral é, portanto, dominada por uma constante mais \(4\mathbf{E}[\xi _1]\).
Passo 3: uma subsequência geométrica. Para \(\alpha \gt 1\), ponha \(m_j=\lfloor \alpha ^j\rfloor \). Descartar um número finito de termos permite supor que \((m_j)\) é estritamente crescente e que \(m_j\geq \alpha ^j/2\). Se \(R_n=T_n-\mathbf{E}[T_n]\), então Chebyshev, a independência e Tonelli dão
pois a soma geométrica interna é no máximo \(C_\alpha /k^2\). Aplicando Borel–Cantelli a \(\varepsilon =1/r\), \(r\in \mathbb {N}\), obtemos
Além disso, \(\| Y_k-\xi _k\| _1=\mathbf{E}[\xi _1\mathbf1_{\{ \xi _1\gt k\} }]\to 0\). Como \(\mathbf{E}[\xi _k]=\mu \), segue que \(\mathbf{E}[Y_k]\to \mu \) e, pelo lema de Cesàro,
Concluímos que \(T_{m_j}/m_j\to \mu \) quase certamente.
Passo 4: preenchimento das lacunas. Como \(T_n\) é crescente, se \(m_j\leq n\leq m_{j+1}\), então
Como \(m_{j+1}/m_j\to \alpha \), segue que, quase certamente,
Repetindo o argumento para a sequência enumerável \(\alpha _r=1+1/r\) e fazendo \(r\to \infty \), obtemos \(T_n/n\to \mu \) quase certamente. Pelo Passo 2, o mesmo vale para \(S_n/n\).
Finalmente, para variáveis de sinal arbitrário, aplicamos o caso não negativo separadamente a \(\xi _k^+\) e \(\xi _k^-\) e subtraímos os limites.
11.4 Integração de Monte Carlo
Se \(f:[0,1]\to \mathbb {R}\) é integrável, queremos aproximar
Uma aproximação determinística usa uma malha prescrita. O método de Monte Carlo substitui essa malha por pontos aleatórios: sejam \(U_1,U_2,\ldots \) variáveis i.i.d. uniformes em \([0,1]\) e defina
O acaso entra apenas na escolha dos pontos. A Lei Forte dos Grandes Números mostra que essa média amostral recupera a integral.
As variáveis \(f(U_k)\) são i.i.d. e integráveis. Como \(U_k\) tem distribuição uniforme,
A conclusão segue da Lei Forte dos Grandes Números de Kolmogorov.
A integrabilidade basta para garantir a convergência desse método de computação científica. Quantificar o erro é outra questão: hipóteses adicionais, como variância finita, permitem obter estimativas para amostras de tamanho finito.
11.5 Polinômios de Bernstein e o teorema de Weierstrass
As leis dos grandes números também permitem demonstrar um resultado inteiramente determinístico. A interpretação dos polinômios de Bernstein como esperanças de funções de variáveis binomiais conduz a uma prova do Teorema de Weierstrass. Esta seção é adaptada de [23].
Polinômios de Bernstein
Os polinômios de Bernstein são definidos por
para \(j=0,1,\ldots ,n\).
Os polinômios \(b_{n,j}\) formam uma família de \(n+1\) polinômios de grau no máximo \(n\).
Para \(0\lt j\lt n\), o máximo de \(b_{n,j}\) em \([0,1]\) é atingido unicamente em \(j/n\).
A família \(b_{n,0},\ldots ,b_{n,n}\) é uma base do espaço dos polinômios de grau no máximo \(n\).
Eles satisfazem a simetria \(b_{n,j}(x)=b_{n,n-j}(1-x)\), a positividade \(b_{n,j}(x)\geq 0\) em \([0,1]\) e a normalização \(\sum _{j=0}^nb_{n,j}(x)=1\).
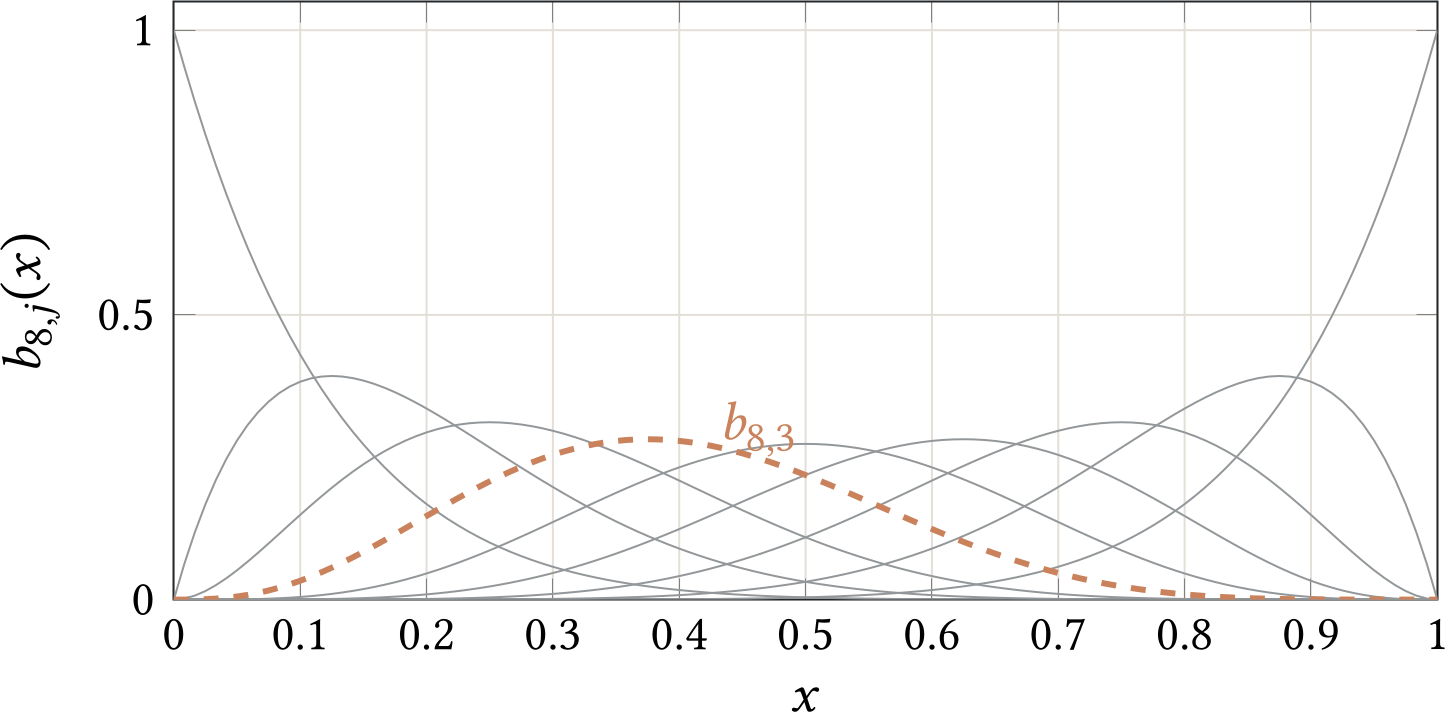
Figura 11.1 Polinômios de Bernstein \(b_{8,j}\), \(j=0,\ldots ,8\). A curva tracejada destaca \(b_{8,3}\). Para cada \(x\), a soma das nove curvas é \(1\).
Teorema de Aproximação de Weierstrass
Associemos agora esses polinômios a uma função contínua \(f:[0,1]^d\to \mathbb {C}\), definindo
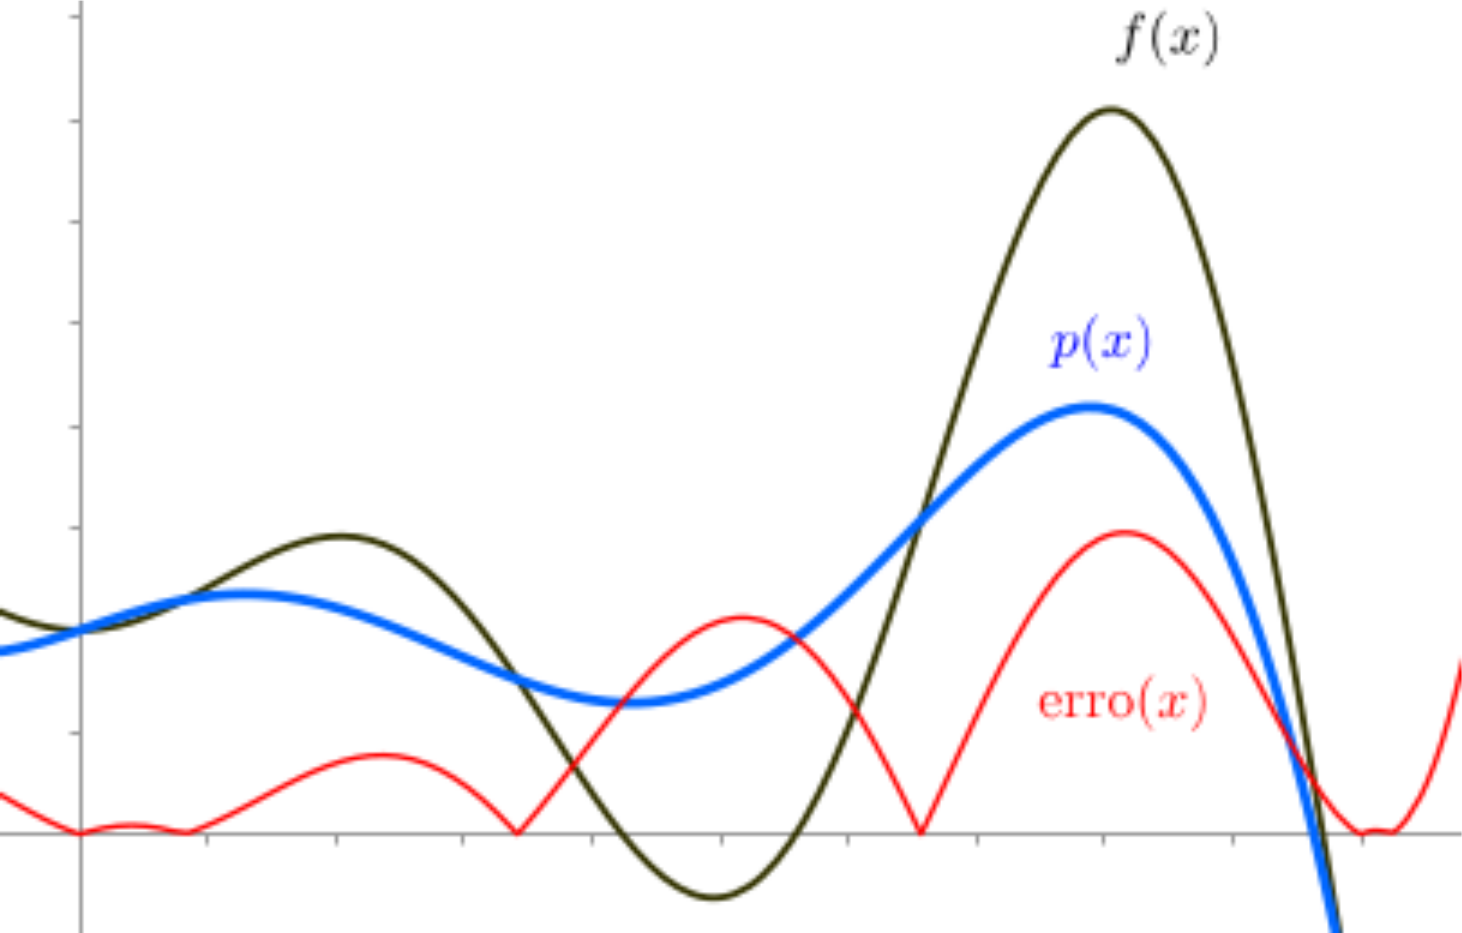
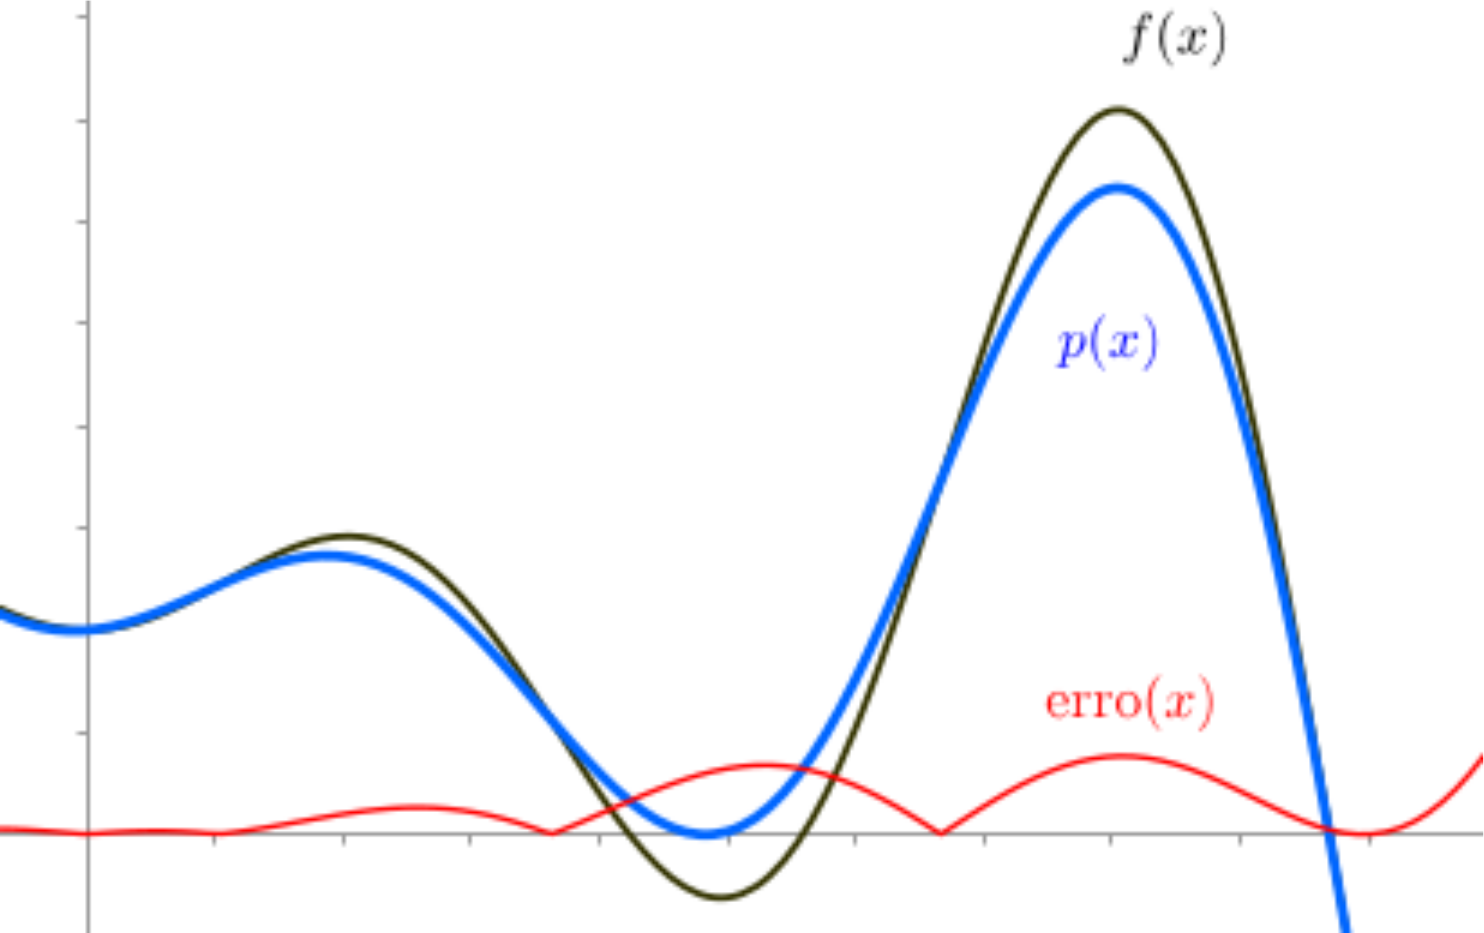
O teorema afirma que esses polinômios aproximam \(f\) uniformemente.
A estrutura dos polinômios torna-se mais clara com a interpretação probabilística
onde as coordenadas de \(\mathbf{S}_n\) são independentes e
A lei dos grandes números sugere a concentração de \(\mathbf{S}_n/n\) perto de \(\mathbf{x}\). Para passar dessa observação à convergência uniforme, precisamos de uma estimativa que não dependa de \(\mathbf{x}\). A desigualdade de Chebyshev fornecerá justamente esse controle.
Fixe \(\mathbf{x}=(x_1,\ldots ,x_d)\in [0,1]^d\). Para \(1\leq k\leq d\) e \(1\leq j\leq n\), sejam \(\xi _{k,j}\) variáveis independentes de Bernoulli com parâmetro \(x_k\). Ponha
A independência e a fórmula da distribuição binomial mostram, pela definição da esperança, que
Use a norma do máximo em \(\mathbb {R}^d\). Como
a desigualdade da união e a desigualdade de Chebyshev dão, para todo \(\delta \gt 0\),
Essa cota não depende de \(\mathbf{x}\).
Seja \(M=\max _{\mathbf{y}\in [0,1]^d}|f(\mathbf{y})|\). Dado \(\varepsilon \gt 0\), a continuidade uniforme de \(f\) fornece \(\delta \gt 0\) tal que \(|f(\mathbf{y})-f(\mathbf{x})|\lt \varepsilon /2\) sempre que \(\| \mathbf{y}-\mathbf{x}\| _\infty \lt \delta \). Separando a esperança conforme esse evento e seu complementar, obtemos
Para \(n\) suficientemente grande, o último termo é menor que \(\varepsilon /2\), uniformemente em \(\mathbf{x}\). Logo \(\| B_n[f]-f\| _\infty \to 0\).
A interpretação probabilística fornece, assim, uma prova do teorema de Weierstrass.
Uma extensão da Lei Forte: Kolmogorov e Kronecker
A Lei Forte apresentada no texto trata sobretudo de sequências i.i.d. Há uma extensão simples e útil para somas de variáveis independentes que não precisam ter a mesma distribuição. Ela repousa em três ferramentas que também voltarão a aparecer, em linguagem de martingalas, no Capítulo 15.
A ferramenta de partida é a Desigualdade Maximal de Kolmogorov, Teorema 11.9, já demonstrada no corpo do capítulo. Aqui ela será usada para obter um critério de convergência de séries e, depois, uma versão não i.i.d. da Lei Forte.
Escreva \(S_n=\sum _{k\leq n}X_k\). Para \(m\lt n\), a desigualdade maximal aplicada à cauda fornece
Fazendo \(n\to \infty \) e usando continuidade da probabilidade,
Se \(C_m(r)=\{ \sup _{j,\ell \geq m}|S_j-S_\ell |\gt r\} \), então \(C_m(r)\subseteq \{ \sup _{j\geq m}|S_j-S_m|\gt r/2\} \); portanto \(\P (C_m(r))\to 0\). Como \(C_m(r)\) decresce em \(m\), segue que, para cada \(r\gt 0\), quase toda trajetória é eventualmente \(r\)-Cauchy. Intersectando sobre \(r\in \mathbb {Q}_{\gt 0}\), \((S_n)\) é Cauchy quase certamente e, portanto, converge.
Ponha \(T_n=\sum _{k=1}^n x_k/k\) e \(T_0=0\). Como \(x_k=k(T_k-T_{k-1})\), uma soma por partes dá
Se \(T_n\to T\), a média de Cesàro à direita também converge a \(T\); a diferença, portanto, tende a zero.
Truncamento. Seja \(\xi \) uma variável aleatória integrável. Para \(M\gt 0\), defina Prove que: \(|\xi ^{(M)}|\leq M\) e \(|\xi ^{(M)}|\leq |\xi |\) pontualmente; \(\xi ^{(M)}\to \xi \) quase certamente quando \(M\to \infty \); para cada \(M\) fixo, \(\xi ^{(M)}\) possui momentos de todas as ordens; \(\mathbf{E}[\xi ^{(M)}]\to \mathbf{E}[\xi ]\) quando \(M\to \infty \). Indique explicitamente qual função domina a sequência no último item. Sejam \(\xi _1,\xi _2,\ldots \) variáveis aleatórias i.i.d. com distribuição \(N(0,1)\). Prove que converge quase certamente e determine o limite. Sejam \(\xi _1,\xi _2,\ldots \) variáveis aleatórias i.i.d. com distribuição uniforme em \((0,1)\). Prove que a média geométrica converge quase certamente e determine o limite. Dica. Aplique a Lei Forte dos Grandes Números a \(\log \xi _1,\log \xi _2,\ldots \) e verifique antes a integrabilidade. Lei Fraca por funções geradoras de momentos. Sejam \(\xi _1,\xi _2,\ldots \) variáveis aleatórias i.i.d., com \(\mathbf{E}|\xi _1|\lt \infty \), e suponha que seja finita para \(s\in [-c,c]\), onde \(c\gt 0\). Defina \(\overline\xi _n=n^{-1}\sum _{k=1}^{n}\xi _k\) e \(\mu =\mathbf{E}[\xi _1]\). Prove que, para todo \(s\in [-c,c]\), Reconheça o limite como a função geradora de momentos da constante \(\mu \) e conclua que \(\overline\xi _n\xrightarrow {\P }\mu \). Dica. Mostre que \(M_\xi (u)=1+u\mathbf{E}[\xi _1]+o(u)\) quando \(u\to 0\). Sejam \(\xi _1,\xi _2,\ldots \) variáveis aleatórias independentes com Para \(S_n=\sum _{k=1}^{n}\xi _k\), prove que Dica. Aplique o Teorema 11.16 à série \(\sum _k\xi _k/k\) e depois o Lema 11.17. Seja \(\xi _1,\xi _2,\ldots \) uma sequência i.i.d. com e defina Prove que a série converge e que \(Z\) pertence ao conjunto de Cantor quase certamente. Prove que \(Z\) possui a distribuição de Cantor. Calcule \(\mathbf{E}[Z]\) e \(\operatorname {Var}(Z)\) justificando a troca entre soma e esperança. Integração de Monte Carlo. Seja \(f:[0,1]\to [0,1]\) contínua. Considere \(\xi _1,c_1,\xi _2,c_2,\ldots \) independentes e uniformes em \([0,1]\) e defina Mostre que \(\eta _1,\eta _2,\ldots \) são i.i.d. de Bernoulli e calcule \(\mathbf{E}[\eta _i]\). Use a Lei Forte dos Grandes Números para concluir que
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução
Ver solução