Produto Interno
Os axiomas de espaço vetorial descrevem a adição e a multiplicação por escalares, mas não definem comprimento, ângulo ou perpendicularidade. O produto interno acrescenta essas noções à estrutura linear.
O produto escalar de \(\mathbb {R}^n\) fornece o modelo para a definição abstrata. A partir de suas propriedades, definimos a norma, a ortogonalidade e as projeções; a adjunta relaciona o produto interno aos operadores. A seção opcional sobre espaços de Hilbert trata dessas construções quando a dimensão é infinita e a completeza precisa ser considerada.
O comprimento de \(\bm {u}\) e o ângulo entre dois vetores não nulos podem ser recuperados desse único número:
Em particular, \(\lVert \bm {u}\rVert \) é a distância do ponto \(\bm {u}\) à origem.
As propriedades algébricas que tornam possível essa interpretação são as seguintes.
\( \bm {u}\cdot \bm {u}\geq 0 \) e \( \bm {u}\cdot \bm {u}= 0 \) se, e somente se, \( \bm {u}= \vec0 \). Dizemos que o produto escalar é positivo definido.
\( \bm {u}\cdot \bm {v}= \bm {v}\cdot \bm {u}\). Dizemos que o produto escalar é simétrico.
\( (\bm {u}+\bm {v}) \cdot \bm {w}= \bm {u}\cdot \bm {w}+\bm {v}\cdot \bm {w}\). Dizemos que o produto escalar é aditivo no primeiro argumento.
\( (\lambda \bm {u}) \cdot \bm {v}= \bm {u}\cdot (\lambda \bm {v}) = \lambda (\bm {u}\cdot \bm {v}) \). Dizemos que o produto escalar é homogêneo em relação aos escalares.
Escreva \(\bm {u}=(u_1,\ldots ,u_n)\), \(\bm {v}=(v_1,\ldots ,v_n)\) e \(\bm {w}=(w_1,\ldots ,w_n)\). Então
e essa soma é zero exatamente quando \(u_i=0\) para todo \(i\), isto é, quando \(\bm {u}=\vec0\). Além disso,
e
Tomaremos essas propriedades como axiomas e as transportaremos para espaços vetoriais abstratos. No caso complexo, a simetria precisa envolver conjugação: é ela que garante que \(\langle \bm {v},\bm {v}\rangle \) seja real e não negativo.
7.1 Produto Interno
Neste capítulo, \(\mathbb {K}\) denotará \(\mathbb {R}\) ou \(\mathbb {C}\), e \(\overline\lambda \) indicará o conjugado de \(\lambda \in \mathbb {C}\).
Seja \(V\) um espaço vetorial sobre \(\mathbb {K}\). Um produto interno em \(V\) é uma função \(\langle \ ,\ \rangle :V\times V\to \mathbb {K}\) com as seguintes propriedades:
Linear na primeira coordenada: para todos \( \bm {u},\bm {v}\in V \) e \( \lambda _1, \lambda _2 \in \mathbb {K}\)
\[ \langle \lambda _1\bm {u}+\lambda _2\bm {v}, \ \bm {w}\rangle = \lambda _1 \langle \bm {u}, \ \bm {w}\rangle +\lambda _2 \langle \bm {v}, \ \bm {w}\rangle \]Simétrico:
\[ \langle \bm {u}, \ \bm {v}\rangle = \overline{\langle \bm {v}, \bm {u}\rangle } \quad \text{ (simetria Hermitiana) } \]Positivo definido: Para todo \(\bm {v}\in V, \)
\[ \langle \bm {v},\bm {v}\rangle \geq 0 \text{ e } \langle \bm {v},\bm {v}\rangle = 0 \text{ se, e somente se, }\bm {v}= \vec0 . \]
Quando \(\mathbb {K}= \mathbb {R}\) a condição de simetria se reduz a
Um espaço vetorial \( V \), munido de um produto interno, é denominado espaço com produto interno.
Observe que um subespaço vetorial \( S \) de um espaço com produto interno \( V \) também é um espaço com produto interno com a restrição do produto interno de \( V \) a \( S. \)
Se \(\mathbb {K}= \mathbb {R}\), então o produto interno é linear em ambas as coordenadas, ou seja, o produto interno é bilinear.
No entanto, se \(\mathbb {K}= \mathbb {C}\), então o produto interno é linear na primeira coordenada e conjugado-linear na segunda, isto é,
\[ \langle \bm {w}, \lambda _1\bm {u}+\lambda _2\bm {v}\rangle = \overline{\lambda _1} \langle \bm {w}, \bm {u}\rangle +\overline{\lambda _2} \langle \bm {w}, \bm {v}\rangle . \]\(\langle \vec0,\bm {v}\rangle =\langle \bm {v},\vec0\rangle =0\).
Se \(\mathbb {K}=\mathbb {R}\), a linearidade na segunda coordenada segue da simetria e da linearidade na primeira. De fato,
Se \(\mathbb {K}= \mathbb {C}\), então
Finalmente, pela linearidade na primeira coordenada, \(\langle \vec0,\bm {v}\rangle =\langle \vec0+\vec0,\bm {v}\rangle =2\langle \vec0,\bm {v}\rangle \), logo \(\langle \vec0,\bm {v}\rangle =0\). Pela simetria hermitiana, também \(\langle \bm {v},\vec0\rangle =0\).
Assim, um produto interno complexo é linear na primeira coordenada e conjugado-linear na segunda. Dizemos, por isso, que ele é sesquilinear: o prefixo latino sesqui significa “uma vez e meia”.
O espaço vetorial \( C [a, \ b] \) de todas as funções contínuas reais no intervalo fechado \( [a, \ b] \) é um espaço de produto interno com
Vamos provar apenas que é positivo definido.
Ou seja, vamos provar que se
\( f \) é contínuo no intervalo fechado \( [a, b] \).
\( f \ge 0 \) em \( (a, b) \).
Então, \( f = 0 \) em \( [a, b] \) ou \( \displaystyle \int _a^b f (t) dt\gt 0 \).
Sejam \( m \) e \( M \) os valores mínimo e máximo de \( f \) no intervalo \( [a, b] \). Portanto, temos \( 0 \le m \le f (t) \le M \) para todos os \( t \) em \( [a, b] \).
Se \( M = 0 \), então \( f \) é identicamente nula.
Então agora assuma que \( M\gt 0 \). Se \( m = M \), então \( f (t) = M \) para todos os \( t \) e \( \displaystyle \int _a^b f (t) dt = M (b -a)\gt 0 \) e terminamos a demonstração.
Assim podemos assumir que \( m \lt M \). Então o número \( A = \frac{1}{2} (M+m) \) é positivo e estritamente menor que \( M \). Seja \( f (c) = M \), com \( c \) em \( [a, b] \). Como \( f \) é contínua em \( [a, b] \), temos que \( f \) é maior que \( A \) se estivermos perto o suficiente de \( t = c \). Logo existe uma vizinhança \( [p, q] \) contendo \( c \), de modo que \( f (t) \ge A \) nesse intervalo, onde temos: \( a \le p \lt q \le b \) e \( p \le c \le q \). Então, como \( f (t) \ge 0 \) em \( [a, b] \), temos \( \displaystyle \int _a^pf (t) dt \ge 0 \) e \( \displaystyle \int _q^bf (t) dt \ge 0 \), então obtemos:
Então \( \displaystyle \int _a^b f (t) dt\gt 0 \) e obtemos o resultado desejado. Aplicando esse resultado à função não negativa \(f^2\), concluímos que \(\langle f,f\rangle =0\) implica \(f=0\), como exigido pela positividade definida.
No espaço vetorial real \(\mathcal{M}_{n, n}(\mathbb {R})\) o produto interno usual é definido da seguinte forma:
Um dos exemplos de espaços de produto interno mais fundamentais é o espaço vetorial \( \ell ^{2} \) de todas as sequências reais (ou complexas) \( (s_{n}) \) com a propriedade que
munido do produto interno
Tais sequências são denominadas quadrado somáveis. Para que o produto interno esteja bem definido a soma à direita na Equação 7.1 deve convergir. Para provar isso, observamos que, se \( (s_{n }), (t_{n }) \in \ell ^{2} \), então
e consequentemente
o que implica que a série \(\sum _n|s_nt_n|\) converge. Portanto, a série da Equação 7.1 converge absolutamente. Deixamos ao leitor verificar os demais axiomas do produto interno.
Seja \(V\) um espaço vetorial de dimensão finita e base \(\underline{\textsc{B}}=\{ \bm {v}_{1},\ \ldots ,\ \bm {v}_{n}\} , \). Sejam \(\bm {v}=\sum _{i=1}^na_i\bm {v}_i\) e \(\bm {u}=\sum _{j=1}^n b_j\bm {v}_j\) vetores em \(V\). Então
onde \(G=[g_{ij}]\) é a matriz definida por \(g_{ij}=\langle \bm {v}_i,\bm {v}_j\rangle \) para \(1\leq i,j\leq n\). A matriz \(G\) é conhecida como matriz de Gram na base \(\underline{\textsc{B}}\).
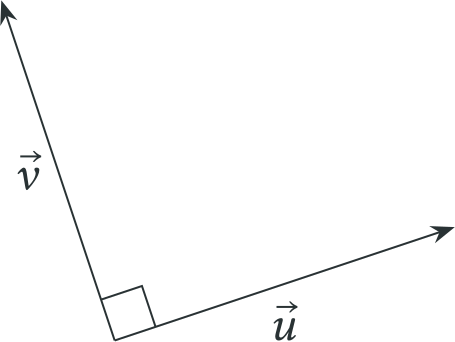
O seguinte resultado simples é bastante útil.
Tomando \(\bm {x}=\bm {u}-\bm {v}\), obtemos
Como o produto interno é positivo definido, \(\bm {u}-\bm {v}=\vec0\) e, portanto, \(\bm {u}=\bm {v}\).
7.2 Normas
Todo produto interno determina uma noção de comprimento. Para \(\bm {v}\in V\), definimos a norma induzida por
Um vetor de norma \(1\) é denominado unitário.
\( \Vert \bm {v}\Vert \geq 0 \) e \( \Vert \bm {v}\Vert = 0 \) se, e somente se, \(\bm {v}= \vec0. \)
Para todos \( \lambda \in \mathbb {K}\) e \(\bm {v}\in V, \)
\[ \Vert \lambda \bm {v}\Vert = | \lambda | \Vert \bm {v}\Vert \](Pitágoras) Se \(\bm {v}\perp \bm {u}\), temos
\[ \Vert \bm {v}+\bm {u}\Vert ^{2}=\Vert \bm {v}\Vert ^{2}+\Vert \bm {u}\Vert ^{2} \](Desigualdade de Cauchy-Schwarz-Bunyakovsky) Para todos \( \bm {u},\bm {v}\in V, \)
\[ | \langle \bm {u}, \ \bm {v}\rangle | \leq \Vert \bm {u}\Vert \Vert \bm {v}\Vert \]com igualdade se, e somente se, \( \bm {u}\) e \(\bm {v}\) forem múltiplos escalares um do outro.
(Desigualdade triangular) Para todos \( \bm {u},\bm {v}\in V, \)
\[ \Vert \bm {u}+\bm {v}\Vert \leq \Vert \bm {u}\Vert +\Vert \bm {v}\Vert \]com igualdade se, e somente se, um dos vetores for zero ou \(\bm {u}=\lambda \bm {v}\) para algum escalar real \(\lambda \geq 0\).
Para todos \( \bm {u}, \bm {v}, \bm {w}\in V, \)
\[ \Vert \bm {u}-\bm {v}\Vert \leq \Vert \bm {u}-\bm {w}\Vert +\Vert \bm {w}-\bm {v}\Vert \]Para todos \( \bm {u},\bm {v}\in V, \)
\[ | \Vert \bm {u}\Vert - \Vert \bm {v}\Vert | \leq \Vert \bm {u}-\bm {v}\Vert \](Regra do Paralelogramo) Para todos \( \bm {u},\bm {v}\in V, \)
\[ \Vert \bm {u}+\bm {v}\Vert ^{2}+\Vert \bm {u}-\bm {v}\Vert ^{2} = 2 \Vert \bm {u}\Vert ^{2} +2 \Vert \bm {v}\Vert ^{2} \]
As afirmações a e b seguem diretamente da definição:
Além disso, \(\lVert \bm {v}\rVert =0\) se, e somente se, \(\langle \bm {v},\bm {v}\rangle =0\), o que equivale a \(\bm {v}=\vec0\).
Para demonstrar Pitágoras observamos que
pois \(\bm {v}\) e \(\bm {u}\) são ortogonais.
Para demonstrar Cauchy–Schwarz, o caso em que um dos vetores é zero é imediato. Se \(\bm {v}\neq 0\), tome \(\lambda =\langle \bm {u},\bm {v}\rangle /\langle \bm {v},\bm {v}\rangle \). Então
o que equivale à desigualdade de Cauchy–Schwarz–Bunyakovsky. Além disso, a igualdade vale se, e somente se, \( \Vert \bm {u}-\lambda \bm {v}\Vert ^{2} = 0 \), isto é, se, e somente se, \( \bm {u}-\lambda \bm {v}= \vec0 \), o que equivale a \( \bm {u}\) e \(\bm {v}\) serem múltiplos escalares um do outro.
Para provar a desigualdade triangular, utilizaremos a desigualdade de Cauchy-Schwarz-Bunyakovsky
Na desigualdade acima usamos primeiro \(\operatorname {Re}z\leq |z|\) e depois Cauchy–Schwarz–Bunyakovsky. Assim, temos a desigualdade triangular. Se nenhum dos vetores é nulo, a igualdade ocorre exatamente quando
Pelo caso de igualdade de Cauchy–Schwarz, isso significa que \(\bm {u}=\lambda \bm {v}\); a primeira igualdade força \(\lambda \) a ser real e não negativo. A recíproca é imediata, e o caso em que um vetor é nulo também é imediato.
A afirmação f é a desigualdade triangular aplicada a
Para g, a desigualdade triangular fornece \(\lVert \bm {u}\rVert \leq \lVert \bm {u}-\bm {v}\rVert +\lVert \bm {v}\rVert \) e, trocando \(\bm {u}\) e \(\bm {v}\), também \(\lVert \bm {v}\rVert \leq \lVert \bm {u}-\bm {v}\rVert +\lVert \bm {u}\rVert \). As duas desigualdades juntas dão o resultado.
Finalmente, expandindo os dois termos do lado esquerdo, obtemos
que prova h.
A desigualdade de Cauchy–Schwarz garante que, para vetores não nulos em um espaço com produto interno real,
Podemos, portanto, definir o ângulo sem ambiguidade.
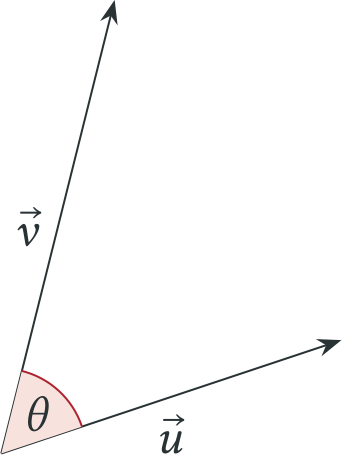
Podemos generalizar o conceito de norma de modo a torná-lo independente do produto interno.
\(\Vert \bm {v}\Vert \gt 0\) se \(\bm {v}\neq 0\);
\(\Vert \lambda \bm {v}\Vert =|\lambda |\Vert \bm {v}\Vert \), para \(\lambda \in \mathbb {K}\);
\(\Vert \bm {v}+\bm {u}\Vert \leq \Vert \bm {v}\Vert +\Vert \bm {u}\Vert .\)
No espaço vetorial real \(\mathbb {R}^{n}\) temos as seguintes normas
a) Norma do Máximo: \(\Vert x\Vert _{\infty } = \displaystyle \max \{ |x_{i}|\ ;\ 1\leq i\leq n\} \)
b) Norma do Táxi: \(\Vert x\Vert _{1} = \displaystyle \sum _{i=1}^{n}|x_{i}|\)
No espaço vetorial real \(\mathcal{M}_{n, n}(\mathbb {R}).\) temos as seguintes normas
a) \( \Vert A\Vert _{\infty }=\max \{ \sum _{j=1}^{n}|a_{ij}|\ ;\ 1\leq i\leq n\} \)
b) \(\Vert A\Vert _{1}=\max \{ \sum _{i=1}^{n}|a_{ij}|\ ;\ 1\leq j\leq n\} \)
Observamos que nem todas as normas provêm de um produto interno.
O produto interno em \( V \) pode ser recuperado da norma associada. Assim, conhecer o comprimento de todos os vetores em \( V \) equivale a conhecer todos os produtos internos dos vetores em \( V. \)
Se \( V \) é um espaço real com produto interno, então
\[ \langle \bm {u}, \ \bm {v}\rangle = \frac{1}{4} (\Vert \bm {u}+\bm {v}\Vert ^{2} - \Vert \bm {u}-\bm {v}\Vert ^{2}) \]Se \( V \) é um espaço complexo com produto interno, então
\[ \langle \bm {u}, \ \bm {v}\rangle = \frac{1}{4} (\Vert \bm {u}+\bm {v}\Vert ^{2} - \Vert \bm {u}-\bm {v}\Vert ^{2})+\frac{1}{4} i (\Vert \bm {u}+i\bm {v}\Vert ^{2} - \Vert \bm {u}-i\bm {v}\Vert ^{2}) \]
Expandindo os quadrados pela sesquilinearidade, obtemos
e, no caso complexo,
Somando as duas identidades, obtemos a fórmula complexa; no caso real, a primeira identidade já fornece o resultado.
Se a norma é induzida por um produto interno, a regra do paralelogramo segue expandindo os dois lados. Reciprocamente, no caso real, defina
A regra do paralelogramo implica as identidades \(B(\bm {x}+\bm {z},\bm {y})=B(\bm {x},\bm {y})+B(\bm {z},\bm {y})\) e \(B(-\bm {x},\bm {y})=-B(\bm {x},\bm {y})\). Daí segue a homogeneidade para escalares inteiros e racionais. Pela desigualdade triangular invertida, \(|\lVert \bm {x}\rVert -\lVert \bm {y}\rVert |\leq \lVert \bm {x}-\bm {y}\rVert \); portanto, a norma e a função \(B\) são contínuas. Aproximando um escalar real por racionais, estendemos a homogeneidade a todos os escalares reais. A simetria é imediata e \(B(\bm {x},\bm {x})=\| \bm {x}\| ^2\), logo \(B\) é um produto interno que induz a norma dada.
No caso complexo, usa-se a identidade de polarização complexa para definir o produto interno; o mesmo argumento fornece a aditividade, e os termos com \(i\) fornecem a homogeneidade complexa. A unicidade, em ambos os casos, decorre diretamente das identidades de polarização.
A norma pode ser usada para definir a distância entre dois vetores em um espaço com produto interno.
\( d (\bm {u}, \ \bm {v}) \geq 0 \) e \( d (\bm {u}, \ \bm {v}) = 0 \) se, e somente se, \( \bm {u}=\bm {v}\).
\(d (\bm {u}, \ \bm {v}) = d (\bm {v}, \ \bm {u})\). Nesse caso dizemos que \(d\) é simétrica.
\(d (\bm {u}, \ \bm {v}) \leq d (\bm {u}, \ \bm {w})+d (\bm {w}, \ \bm {v}) \). Nesse caso dizemos que \(d\) satisfaz a desigualdade triangular.
A afirmação a segue da positividade da norma, pois \(d(\bm {u},\bm {v})=0\) se, e somente se, \(\bm {u}-\bm {v}=\vec0\). Para b,
Finalmente,
pela desigualdade triangular da norma.
Qualquer conjunto não vazio \( V \), juntamente com uma função \( d: V \times V \rightarrow \mathbb {R}\) que satisfaça as propriedades da Proposição 7.24, é denominado espaço métrico e a função \( d \) é dita métrica em \( V \). Assim, qualquer espaço com produto interno é um espaço métrico com a métrica induzida pelo produto interno.
A presença de um produto interno e, portanto, de uma métrica, permite a definição de diversos conceitos analíticos em \( V \) como convergência de sequências e séries infinitas, funções contínuas e conjuntos abertos, fechados e compactos.
7.3 Bases Ortonormais
O conjunto \(S^{\perp }\) é um subespaço de \(V\), mesmo que \(S\) não o seja. Se \(S\) é um subespaço de \(V\) então \(S\cap S^{\perp }=\{ \vec0\} \).
O vetor nulo pertence a \(S^{\perp }\). Se \(\bm {u},\bm {v}\in S^{\perp }\) e \(\lambda ,\mu \in \mathbb {K}\), então, para todo \(\bm {s}\in S\),
Logo \(\lambda \bm {u}+\mu \bm {v}\in S^{\perp }\), e \(S^{\perp }\) é um subespaço. Se \(S\) também é um subespaço e \(\bm {v}\in S\cap S^{\perp }\), então \(\langle \bm {v},\bm {v}\rangle =0\); portanto, \(\bm {v}=\vec0\).
A ortogonalidade é mais forte que a independência linear.
Sejam \(\bm {x}_{1}, \ldots , \bm {x}_{m}\in X\) tais que
Então
Como \(\langle \bm {x}_{i}, \bm {x}_{i}\rangle =\Vert \bm {x}_{i}\Vert ^{2}\neq 0\), temos que \(\alpha _{i}=0.\)
Seja \( O \) a coleção de todos os conjuntos ortonormais em um espaço com produto interno \( V. \) Observe que qualquer conjunto unitário \( \{ \bm {v}\} \) com \( || \bm {v}|| = 1 \) é um conjunto ortonormal em \( V \). Como uma subfamília do conjunto das partes \( \mathscr {P}(V) \) a família \( O \) é parcialmente ordenada pela ordem dada pela inclusão de conjuntos.
Em dimensão infinita, um sistema ortonormal maximal não precisa ser uma base do espaço vetorial. Para evitar ambiguidade, denominaremos uma base no sentido puramente algébrico de base de Hamel.
\( A \) é um conjunto ortonormal maximal em \( V. \)
Não há vetor unitário \( \bm {v}\) para o qual \( A \bigcup \{ \bm {v}\} \) seja um conjunto ortonormal.
Se \( \bm {v}\perp A \), \( \bm {v}= \vec0\) (isto é,\( \ A^{\perp } = \{ \vec0\} ) \).
Seja \( A \) um conjunto ortonormal em um espaço com produto interno \( V. \)
a \(\Rightarrow \)b Se existe um vetor unitário \( \bm {v}\) em \( V \) para o qual \( A \bigcup \{ \bm {v}\} \) é um conjunto ortonormal, \( A \bigcup \{ \bm {v}\} \) é um conjunto ortonormal que inclui propriamente \( A \) (pois \( \bm {v}\perp A \)). Portanto, \( A \) não é um conjunto ortonormal maximal em \( V. \)
b \(\Rightarrow \)c Se houver um vetor diferente de zero \( \bm {v}\) em \( V \), de modo que \( \bm {v}\perp A \), existe um vetor unitário \( \bm {v}'= \frac{\bm {v}}{\Vert \bm {v}\Vert } \) em \( V \) de modo que \( A \bigcup \{ \bm {v}'\} \) é um conjunto ortonormal.
c \(\Rightarrow \)a Se a não for verdadeiro, então existe um conjunto ortonormal \( A '\) em \( V \) que contém propriamente \( A \) de modo que \( A' \backslash A \neq \emptyset . \) Seja \( \bm {v}\) em \( A '\backslash A \), que é um vetor diferente de zero \( (\) na verdade, \( \bm {v}\) é um vetor unitário) ortogonal a \( A \) (porque \( \bm {v}\in A ', A \subset A' \) e \( A '\) é um conjunto ortonormal). Assim c não é verdadeiro.
O Lema de Zorn pode ser usado para mostrar que qualquer espaço com produto interno possui um sistema ortonormal maximal.
Seja \( A \) um conjunto ortonormal em um espaço com produto interno \( V \). Definimos
a família de todos os conjuntos ortonormais em \( V \) que incluem \( A \).
Como \(O_{A}\) é uma subfamília não vazia (pois \(A\in O_{A}\)) do conjunto das partes \(\mathscr {P}(V)\), ela é parcialmente ordenada pela inclusão. Considere uma cadeia arbitrária \(C=\{ C_i:i\in \Delta \} \) em \(O_A\) e a união \(U=\bigcup _{i\in \Delta }C_i\). Se \(\bm {v}\) e \(\bm {u}\) são vetores distintos de \(U\), existem \(C_i,C_j\in C\) tais que \(\bm {v}\in C_i\) e \(\bm {u}\in C_j\). Como \(C\) é uma cadeia, \(C_i\subseteq C_j\) ou \(C_j\subseteq C_i\). Sem perda de generalidade, suponha \(C_i\subseteq C_j\); então \(\bm {v},\bm {u}\in C_j\) e, portanto, são ortogonais. Além disso, todo vetor de \(U\) é unitário e \(A\subseteq U\). Logo \(U\) é ortonormal e pertence a \(O_A\).
Como \(U\) é um limite superior para \(C\), toda cadeia em \(O_A\) tem um limite superior em \(O_A\). Pelo Lema de Zorn, \(O_A\) possui um elemento maximal \(B\). Esse conjunto é ortonormal e contém \(A\). Se existisse um vetor unitário \(\bm {v}\) tal que \(B\cup \{ \bm {v}\} \) fosse ortonormal, esse conjunto pertenceria a \(O_A\) e conteria propriamente \(B\), em contradição com a maximalidade. Portanto, \(B\) é um sistema ortonormal maximal em \(V\) que contém \(A\).
O próximo resultado fornece um algoritmo que transforma uma sequência linearmente independente em uma sequência ortogonal.
Seja \( \underline{\textsc{B}}= (\bm {v}_{1}, \ \bm {v}_{2}, \ \ldots ) \) uma sequência de vetores linearmente independentes em um espaço com produto interno \( V \), então a sequência \( O = (\bm {u}_{ 1}, \ \bm {u}_{2}, \ \ldots ) \) definida por
é uma sequência ortogonal em \( V \) com a propriedade que
para todos os \( k\gt 0.\)
A partir da sequência ortogonal \( (\bm {u}_{i}) \), obtemos a sequência ortonormal \( (\bm {w}_{i}) \), onde \( \bm {w}_{i} = \bm {u}_{i} / \Vert \bm {u}_{i} \Vert \).
A demonstração é por indução. Para \(k=1\), temos \(\bm {u}_1=\bm {v}_1\neq \vec0\), e a igualdade dos espaços gerados é imediata.
Suponha agora que \(\bm {u}_1,\ldots ,\bm {u}_k\) sejam não nulos e ortogonais e que
Defina
Para \(1\leq i\leq k\), a ortogonalidade dos vetores já construídos dá
Logo \(\bm {u}_{k+1}\) é ortogonal aos vetores anteriores. Ele não pode ser nulo: se fosse, a fórmula mostraria que \(\bm {v}_{k+1}\in \langle \bm {u}_1,\ldots ,\bm {u}_k\rangle =\langle \bm {v}_1,\ldots ,\bm {v}_k\rangle \), contrariando a independência linear da sequência \((\bm {v}_i)\).
A própria fórmula mostra que \(\bm {u}_{k+1}\in \langle \bm {v}_1,\ldots ,\bm {v}_{k+1}\rangle \), enquanto a identidade obtida ao isolarmos \(\bm {v}_{k+1}\) mostra a inclusão inversa entre os espaços gerados. Portanto,
Isso completa a indução. Como nenhum \(\bm {u}_i\) é nulo, sua normalização produz a sequência ortonormal anunciada.
Considere o espaço vetorial \(P_{3}(\mathbb {R})\) munido do produto interno
Podemos a partir da base \(\underline{\textsc{B}}=\{ 1,\ x,\ x^{2},\ x^{3}\} \) obter uma base ortogonal utilizando o processo de ortogonalização de Gram–Schmidt:
\(P_{0}(x)=1 , \quad P_{1}(x)=x, \quad P_{2}(x)=x^{2} -\frac{1}{3} \quad \text{ e } \quad P_{3}(x)=x^{3} - \frac{3}{5}x.\)
Os polinômios \(P_{0}, P_{1},P_{2}, P_{3}\) são denominados polinômios ortogonais de Legendre.
Considere o espaço vetorial \(P_{3}(\mathbb {R})\) munido do produto interno
Utilizando o processo de ortogonalização de Gram-Schmidt na base \(\underline{\textsc{B}}=\{ 1,\ x,\ x^{2},\ x^{3}\} \), obtemos os polinômios
que são denominados polinômios ortogonais de Laguerre.
Na construção dos polinômios de Laguerre utilizamos que \(\displaystyle \displaystyle \int _{0}^{\infty }\exp (-x)x^{n}dx=n!\) para \( n\in \mathbb {N}\)
Se \( \dim V = n \) for finita, então \( V \) terá uma base ortonormal de tamanho \( n \) e todos os sistemas ortonormais maximais terão tamanho \( n. \)
Se \( V \) possuir um sistema ortonormal maximal finito com tamanho \( n \), então \( \dim V = n. \)
Para a parte a, a aplicação do processo de Gram–Schmidt a uma base de Hamel fornece uma base ortonormal de tamanho \(n\). Um sistema ortonormal tem no máximo \(n\) elementos; se tiver menos, pode ser ampliado aplicando Gram–Schmidt após acrescentar um vetor fora de seu espaço gerado. Logo todo sistema ortonormal maximal tem tamanho \(n\).
Para a parte b, se \(\dim V\gt n\), podemos acrescentar a um sistema ortonormal maximal de tamanho \(n\) um vetor fora de seu espaço gerado e aplicar Gram–Schmidt, obtendo um sistema ortonormal maior, contradição.
Obtenha a fatoração QR reduzida, com diagonal positiva de \(R\), de cada matriz abaixo. As colunas de \(Q\) devem ser os vetores resultantes de Gram–Schmidt na ordem dada.
Seja \(A=[a_1\ \cdots \ a_n]\in M_{m\times n}(\mathbb {R})\), com colunas linearmente independentes. Aplique Gram–Schmidt, nessa ordem, e normalize os vetores obtidos, formando \(Q=[q_1\ \cdots \ q_n]\).
Prove que \(\langle a_1,\ldots ,a_j\rangle =\langle q_1,\ldots ,q_j\rangle \) para todo \(j\).
Defina \(r_{ij}=\langle a_j,q_i\rangle \). Mostre que \(A=QR\), \(Q^TQ=I_n\), \(R\) é triangular superior e \(r_{jj}\gt 0\).
Prove a unicidade dessa fatoração sob a condição \(r_{jj}\gt 0\). Complete \(Q\) a uma matriz ortogonal \(\widehat Q\) e obtenha a fatoração completa \(A=\widehat Q\binom {R}{0}\).
Para \(v\in \mathbb {R}^m\setminus \{ 0\} \), defina \(H_v=I-2vv^T/(v^Tv)\).
Prove que \(H_v\) é simétrica e ortogonal, fixa \(v^\perp \), envia \(v\) a \(-v\) e tem determinante \(-1\).
Para \(a\neq 0\), escolha \(\alpha \in \{ \| a\| ,-\| a\| \} \) e \(v=a-\alpha e_1\neq 0\). Mostre que \(H_va=\alpha e_1\). Explique como repetir essa construção em blocos menores para obter uma fatoração QR.
Use esse procedimento para fatorar \(A=\begin{bmatrix} 12 & -51 & 4 \\ 6 & 167 & -68 \\ -4 & 24 & -41 \end{bmatrix}\).
Nos exemplos de Legendre e Laguerre acima, os polinômios foram escolhidos mônicos. Nos exercícios seguintes, indicamos explicitamente as normalizações clássicas. Cada construção utiliza o espaço de polinômios de grau limitado e o produto interno definido pela integral com o peso indicado.
Em \(\mathbb R_4[x]\), use \(\langle p,q\rangle =\int _{-1}^1p(x)q(x)\, dx\). Aplique Gram–Schmidt a \(1,x,x^2,x^3,x^4\) e reescale os resultados para obter \(P_n(1)=1\), para \(0\leq n\leq 4\). Confira esses cinco polinômios pela fórmula de Rodrigues Usando integração por partes, prove que a fórmula é ortogonal a todo polinômio de grau menor que \(n\). Calcule \(\| P_n\| ^2\) para \(0\leq n\leq 4\) e normalize para obter uma base ortonormal de \(\mathbb R_4[x]\). Distinga essa normalização da escolha mônica dos exemplos anteriores.
Defina \(T_0=1\), \(T_1=x\) e \(T_{n+1}=2xT_n-T_{n-1}\) para \(n\geq 1\).
Gere \(T_2,T_3,T_4\) e prove por indução que \(T_n(\cos \theta )=\cos (n\theta )\). Determine seu grau e coeficiente líder.
Com a substituição \(x=\cos \theta \), prove a ortogonalidade para o produto
\[ \langle p,q\rangle _T=\int _{-1}^1\frac{p(x)q(x)}{\sqrt{1-x^2}}\, dx \]e calcule as normas. Dê uma base ortonormal de \(\mathbb R_4[x]\).
Explique por que aplicar Gram–Schmidt a \(1,x,\ldots ,x^4\) com esse peso produz múltiplos desses mesmos polinômios. Para conferir os cálculos, use \(\mu _{2m}=\pi \binom {2m}{m}/4^m\) e \(\mu _{2m+1}=0\).
Use \(\langle p,q\rangle _L=\int _0^\infty p(x)q(x)e^{-x}\, dx\) e os momentos \(\int _0^\infty x^ke^{-x}\, dx=k!\).
Aplique Gram–Schmidt a \(1,x,x^2,x^3,x^4\) e reescale para obter \(L_n(0)=1\).
Confira o resultado pela fórmula de Rodrigues
\[ L_n(x)=\frac{e^x}{n!}\frac{d^n}{dx^n}(e^{-x}x^n). \]Prove a ortogonalidade aos graus menores e que \(\| L_n\| _L^2=1\).
Relacione essa escolha aos polinômios mônicos de Laguerre apresentados anteriormente.
Use o produto \(\langle p,q\rangle _H=\int _{-\infty }^{\infty }p(x)q(x)e^{-x^2}\, dx\). Podem ser usadas as identidades
Aplique Gram–Schmidt a \(1,x,x^2,x^3,x^4\) e reescale para que \(H_n\) tenha coeficiente líder \(2^n\).
Confira o resultado pela fórmula
\[ H_n(x)=(-1)^ne^{x^2}\frac{d^n}{dx^n}e^{-x^2}. \]Explique por que as integrações por partes não produzem termos de fronteira e prove a ortogonalidade aos graus menores.
Prove que \(\| H_n\| _H^2=2^nn!\sqrt\pi \) e dê a base ortonormal correspondente até grau quatro. Esta é a convenção de Hermite com peso \(e^{-x^2}\).
Seja \(I\) um intervalo aberto e \(w:I\to (0,\infty )\) contínua, com \(\int _I |x|^k w(x)\, dx\lt \infty \) para todo inteiro \(k\geq 0\). Em cada espaço \(\mathbb R_n[x]\) de polinômios de grau no máximo \(n\), use \(\langle p,q\rangle _w=\int _Ip(x)q(x)w(x)\, dx\) e escreva \(\mu _k=\int _Ix^kw(x)\, dx\).
Prove que esse produto é definido positivo. Mostre que Gram–Schmidt aplicado a \(1,x,\ldots ,x^n\), sem normalizar as normas, produz polinômios mônicos \(p_0,\ldots ,p_n\), com \(\deg p_j=j\).
Para \(n\geq 1\), escreva o sistema linear que determina \(p_n=x^n+\sum _{j=0}^{n-1}a_jx^j\) pela ortogonalidade a \(1,x,\ldots ,x^{n-1}\). Prove que sua matriz de momentos é definida positiva e que a solução é única.
Se \(I\) é simétrico em relação à origem e \(w\) é par, prove que \(p_n(-x)=(-1)^np_n(x)\).
Para os polinômios mônicos ortogonais \(p_n\) de um peso positivo, ponha \(h_n=\langle p_n,p_n\rangle _w\).
Prove que, para \(n\geq 1\),
\[ p_{n+1}=(x-\alpha _n)p_n-\beta _np_{n-1},\qquad \alpha _n=\frac{\langle xp_n,p_n\rangle _w}{h_n},\quad \beta _n=\frac{h_n}{h_{n-1}}\gt 0. \]Determine também \(p_0\) e \(p_1\) a partir dos momentos.
Calcule \(\alpha _n,\beta _n\) para as quatro famílias dos exercícios anteriores. Atente para a diferença entre \(\beta _1\) e \(\beta _n\), \(n\geq 2\), em Chebyshev.
Escreva as recorrências para os polinômios com as normalizações clássicas \(P_n,H_n,L_n,T_n\). Use-as para conferir os polinômios de grau quatro já obtidos.
Seja \(p_n\) um polinômio real de grau \(n\geq 1\), ortogonal a todos os polinômios de grau menor para um peso contínuo e estritamente positivo em um intervalo aberto \(I\), com todos os momentos absolutos finitos. Prove que \(p_n\) tem exatamente \(n\) zeros distintos em \(I\), todos simples. Sugestão: forme o produto dos fatores correspondentes aos zeros em que \(p_n\) troca de sinal. Aplique o resultado para localizar os zeros de Legendre e Chebyshev em \((-1,1)\), os de Laguerre em \((0,\infty )\) e os de Hermite em \(\mathbb R\).
7.4 Melhor Aproximação
Bases ortonormais têm uma grande vantagem sobre bases arbitrárias. Do ponto de vista computacional, se \( B = \{ \bm {v}_{1}, \ \ldots , \ \bm {v}_{n} \} \) é uma base para \( V \), então cada \(\bm {v}\in V \) pode ser escrito na forma
Em geral, no entanto, determinar as coordenadas \( \lambda _{i} \) requer a resolução de um sistema de equações lineares de tamanho \( n \times n. \)
Por outro lado, se \( O = \{ \bm {u}_{1}, \ \ldots , \ \bm {u}_{n} \} \) é uma base ortonormal para \(V\) e
então os coeficientes são facilmente calculados:
Mesmo quando \( O = \{ \bm {u}_{1}, \ \ldots , \ \bm {u}_{n} \} \) não é uma base (mas apenas um conjunto ortonormal), ainda podemos considerar a expansão
Seja \( C [-1, \ 1] \) o espaço vetorial de todas as funções contínuas reais no intervalo fechado \( [-1, \ 1] \) munido do produto interno
Já vimos que conjunto \(\underline{\textsc{B}}=\{ \sin (n \pi x)\} _{n=1}^{\infty }\) é ortogonal.
Os coeficientes de Fourier da função \(f (x) = x\), para \(x \in [-1,1]\), com relação ao conjunto ortogonal \(\underline{\textsc{B}}\), são dados por:
O conjunto \( O \) é uma base ortonormal para \( V. \)
Todo vetor é igual à sua expansão de Fourier, ou seja, para todos os \( \bm {v}\in V \)
\[ \hat{\bm {v}} = \bm {v} \]A identidade de Bessel vale para todos os \(\bm {v}\in V \), isto é,
\[ \Vert \hat{\bm {v}} \Vert = \Vert \bm {v}\Vert \]A identidade de Parseval vale para todos os \( \bm {v}, \bm {w}\in V \), ou seja
\[ \langle \bm {v}, \ \bm {w}\rangle = \langle \bm {v}, \ \bm {u}_{1} \rangle \overline{\langle \bm {w}, \bm {u}_{1} \rangle }+\cdots +\langle \bm {v}, \ \bm {u}_{k} \rangle \overline{\langle \bm {w}, \bm {u}_{k} \rangle } \]
Ponha \(\vec r=\bm {v}-\hat{\bm {v}}\). Para \(1\leq j\leq k\),
Logo \(\vec r\) é ortogonal a \(\langle O\rangle \) e, em particular, a \(\hat{\bm {v}}\). Por Pitágoras,
Da primeira igualdade segue a desigualdade de Bessel.
Se \(O\) é uma base ortonormal, a fórmula das coordenadas em uma base ortonormal dá \(\bm {v}=\hat{\bm {v}}\) para todo \(\bm {v}\), provando a\(\Rightarrow \)b. Reciprocamente, se b vale, todo vetor pertence a \(\langle O\rangle \); portanto, \(O\) é uma base, e temos b\(\Rightarrow \)a.
A implicação b\(\Rightarrow \)c é imediata. Se c vale, a identidade de Pitágoras acima fornece \(\lVert \vec r\rVert =0\), logo \(\bm {v}=\hat{\bm {v}}\); assim, c\(\Rightarrow \)b.
Sob b, expandimos os dois vetores na base \(O\) e obtemos
que é d. Finalmente, tomando \(\bm {w}=\bm {v}\) em d, obtemos \(\lVert \bm {v}\rVert ^{2}=\sum _i|\langle \bm {v},\bm {u}_i\rangle |^{2} =\lVert \hat{\bm {v}}\rVert ^{2}\), isto é, c.
Vimos que, se \( S \) é um subespaço de um espaço com produto interno \( V \), então \( S \cap S^{\perp } = \{ \vec0\} \). Isso levanta a questão de saber se o complemento ortogonal \( S^{\perp } \) é um complemento de espaço vetorial de \( S \), ou seja, se \( V = S \oplus S^{\perp }.\)
Se \( S \) é um subespaço de dimensão finita de \( V \), a resposta é sim, mas para subespaços de dimensão infinita em geral, \( V \neq S \oplus S^{\perp } .\)
Seja \( V = \ell ^{2} \) e seja \( S \) o subespaço de todas as sequências de suporte finito, isto é, o subespaço gerado pelos vetores
onde \( \vec{e}_{i} \) tem um 1 na \(i\)-ésima coordenada e zeros nos outros lugares. Se \( \bm {x}= (x_{n}) \in S^{\perp } \), então
\( x_{i} = \langle \bm {x}, \vec{e}_{i} \rangle = 0 \) para todos os \( i \) e, portanto, \( \bm {x}= \vec0 \). Portanto, \( S^{\perp } = \{ \vec0\} \). No entanto,
7.5 Projeção
Como mostra o próximo teorema, no caso de dimensão finita, os complementos ortogonais também são complementos de espaço vetorial.
Seja \( O = \{ \bm {u}_{1}, \ \ldots , \ \bm {u}_{k} \} \) uma base ortonormal de \( S \). Para cada \(\bm {v}\in V, \) considere a expansão de Fourier
em relação a \( O \). Podemos escrever
onde \( \hat{\bm {v}} \in S \). Além disso, \( \bm {v}- \hat{\bm {v}} \in S^{\perp } \), já que
Como os \(\bm {u}_i\) geram \(S\), a linearidade mostra que \(\bm {v}-\hat{\bm {v}}\) é ortogonal a todo vetor de \(S\). Portanto, \( V = S+S^{\perp } \). Já observamos que \( S \cap S^{\perp } = \{ \vec0 \} \) e, portanto, \( V = S \oplus S^{\perp }. \)
De acordo com a prova do teorema da projeção, o componente de \( \bm {v}\) que está em \( S \) é a expansão de Fourier de \( \bm {v}\) em relação a qualquer base ortonormal \( O \) de \( S. \)
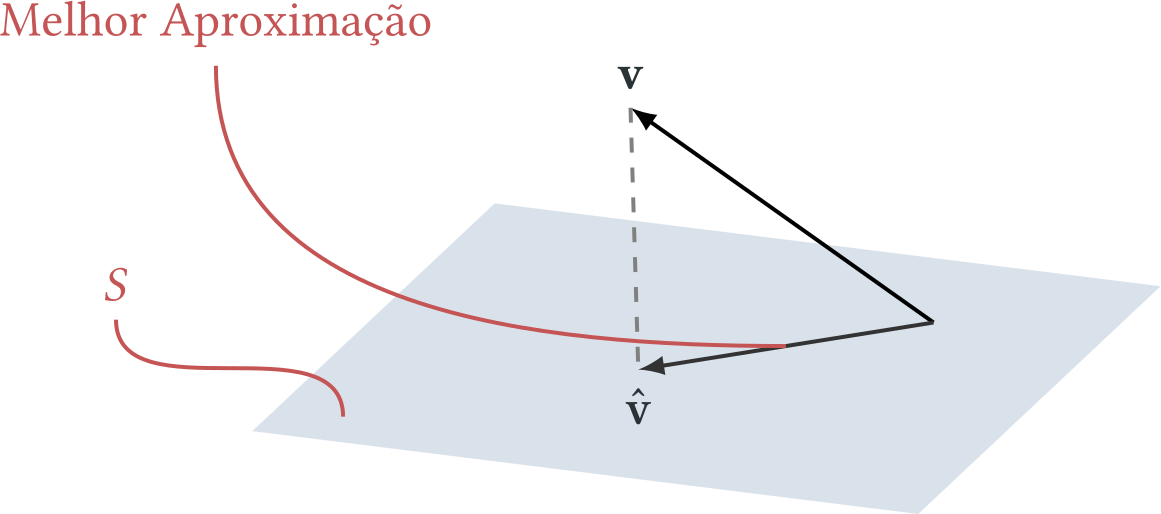
O teorema da projeção implica que, se \( \bm {v}= \hat{\bm {v}}+\vec{s}^{\perp } \) em que \( \hat{\bm {v}} \in S \) e \( \vec{s}^{\perp } \in S^{\perp } \) então \( \hat{\bm {v}} \) é o elemento de \( S \) mais próximo de \( \bm {v}\), ou seja, \( \hat{\bm {v}} \) é a melhor aproximação para \( \bm {v}\) em \( S \). Pois se \( \vec{t} \in S \), como \( \bm {v}- \hat{\bm {v}} \in S^{\perp } \), temos \( (\bm {v}- \hat{\bm {v}}) \perp (\hat{\bm {v}} -\vec{t}) \) e assim
Desse fato resulta que \( \Vert \vec{v}-\vec{t} \Vert \) é mínimo, e apenas é mínimo, quando \( \vec{t} = \hat{\bm {v}} \). Além disso, observamos que \( \hat{\bm {v}} \) é o único vetor em \( S \) para o qual \( \bm {v}- \hat{\bm {v}} \perp S \). Assim, podemos dizer que a melhor aproximação de \( \bm {v}\) a partir de \( S \) é o único vetor \( \vec{s} \in S \) para o qual \( (\bm {v}-\vec{s}) \perp S \) e que esse vetor é a expansão de Fourier \( \hat{\bm {v}} \) de \( \bm {v}. \)
\( V = S_{1} \oplus \cdots \oplus S_{n} \)
\( S_{i} \perp S_{j} \) por \( i \neq j \)
O teorema 7.41 afirma que \( V = S \odot S^{\perp } \), para qualquer subespaço de dimensão finita \( S \) de um espaço vetorial \( V \). O seguinte resultado simples é muito útil.
\( V = S \odot T \)
\( V = S \oplus T \) e \( T = S^{\perp } \)
\( V = S \oplus T \) e \( T{\subseteq } S^{\perp } \)
Suponha que a seja válido. Então \( V = S \oplus T \) e \( S \perp T \), o que implica que \( T \subseteq S^{\perp } \). Mas se \( \vec{w} \in S^{\perp } \) então \( \vec{w} = \vec{s}+\vec{t} \) para \( \vec{s} \in S, \vec{t} \in T \) e assim
Portanto, \( \vec{s} = \vec0 \) e \( \vec{w} \in T \), o que implica que \( S^{\perp }{\subseteq } T \). Portanto, \( S^{\perp } = T \), o que fornece b. Obviamente, b implica c. Finalmente, se c vale, então \( T \subseteq S^{\perp } \), o que implica que \( S \perp T \) e, portanto, a vale.
Se \( \dim V \lt \infty \) e \( S \) for um subespaço de \( V \),
\[ \dim (S^{\perp }) = \dim V - \dim (S) \]Se \( S \) é um subespaço de dimensão finita de \( V \), então
\[ S^{\perp \perp } = S \]Se \( X \) for um subconjunto de \( V \) e \( \dim (\langle X\rangle ) \lt \infty \), então
\[ X^{\perp \perp } = \langle X\rangle \]
Como \( V = S \oplus S^{\perp } \), temos \( \dim V = \dim (S)+\dim (S^{\perp }) \), o que prova a parte a. Quanto à parte b, está claro que \( S \subseteq S^{\perp \perp } \). Por outro lado, se \(\bm {v}\in S^{\perp \perp } \) então pelo teorema da projeção
onde \( \vec{s} \in S \) e \( \vec{s} '\in S^{\perp } \). Mas \(\bm {v}\in S^{\perp \perp } \) implica que \( 0 = \langle \bm {v}, \vec{s} ' \rangle = \langle \vec{s}', \vec{s} ' \rangle \) e assim \( \vec{s}' = \vec0 \), mostrando que \(\bm {v}\in S \). Portanto, \( S^{\perp \perp }{\subseteq } S \) e \( S^{\perp \perp } = S \).
Para c, observe que \(X^{\perp }=\langle X\rangle ^{\perp }\): ser ortogonal a cada elemento de \(X\) equivale, por linearidade, a ser ortogonal a toda combinação linear desses elementos. Aplicando b ao subespaço finito-dimensional \(\langle X\rangle \), obtemos
Os próximos exercícios aplicam a projeção ortogonal a espaços de polinômios e a espaços trigonométricos finitos. Na transformada discreta de Fourier, o espaço ambiente também tem dimensão finita.
Determine o polinômio \(q\in \mathbb R_2[x]\) que melhor aproxima \(f(x)=x^4\) em \([-1,1]\) em cada produto interno: Use Legendre no primeiro caso e Chebyshev no segundo. Calcule o quadrado do erro mínimo em cada norma e verifique a ortogonalidade do resíduo a \(1,x,x^2\). Explique por que os polinômios minimizadores são diferentes.
Fixe \(N\geq 1\) e considere \(E_N=\operatorname {span}\{ 1,\cos x,\sin x,\ldots ,\cos Nx,\sin Nx\} \), com \(\langle f,g\rangle =\int _{-\pi }^{\pi }f(x)g(x)\, dx\).
Calcule os produtos internos dos geradores e obtenha uma base ortonormal de \(E_N\). Determine sua dimensão.
Para \(f\in C([-\pi ,\pi ],\mathbb R)\), mostre que o elemento de \(E_N\) que minimiza \(\int _{-\pi }^{\pi }(f-p)^2\, dx\) é
\[ p_N=\frac{a_0}{2}+\sum _{n=1}^N(a_n\cos nx+b_n\sin nx), \]onde \(a_n=\pi ^{-1}\int _{-\pi }^{\pi }f(x)\cos nx\, dx\), inclusive \(n=0\), e \(b_n=\pi ^{-1}\int _{-\pi }^{\pi }f(x)\sin nx\, dx\).
Prove a identidade finita
\[ \| f\| ^2=\frac\pi 2a_0^2+\pi \sum _{n=1}^N(a_n^2+b_n^2)+\| f-p_N\| ^2. \]Mostre que o erro mínimo não aumenta ao substituir \(N\) por \(N+1\).
Para \(f(x)=|x|\) em \([-\pi ,\pi ]\), calcule os coeficientes \(a_0,a_n,b_n\) do exercício anterior usando paridade e integração por partes. Escreva a melhor aproximação em \(E_2\) e determine seu erro mínimo ao quadrado. Para um inteiro \(N\) fixado, escreva também a projeção em \(E_N\) e seu erro em termos de uma soma finita. Explique por que passar de \(E_1\) para \(E_2\) não melhora a aproximação dessa função.
Em \(\mathbb C^m\), com índices \(0,\ldots ,m-1\), use \(\langle u,v\rangle =m^{-1}\sum _{j=0}^{m-1}u_j\overline{v_j}\). Ponha \(\omega =e^{2\pi i/m}\) e \(e_k=(\omega ^{jk})_{j=0}^{m-1}\).
Prove que \(e_0,\ldots ,e_{m-1}\) formam uma base ortonormal. Deduza a transformada \(\widehat f_k=m^{-1}\sum _jf_j\omega ^{-jk}\), a inversão \(f_j=\sum _k\widehat f_k\omega ^{jk}\) e a identidade \(m^{-1}\sum _j|f_j|^2=\sum _k|\widehat f_k|^2\).
Para \(m=4\) e \(f=(1,2,0,-1)\), calcule a transformada e confira a identidade das normas.
Mostre que essa base diagonaliza o deslocamento circular \(S(f)_j=f_{j-1}\), com índices tomados módulo \(m\), e determine seus autovalores.
7.6 Adjuntas
Nesta seção, o símbolo \(T^*\) denota a adjunta determinada pelos produtos internos. A transposta algébrica do capítulo anterior é denotada por \(T^{\mathrm{t}}\); em bases ortonormais, as duas construções correspondem pela representação de Riesz.
Em nosso primeiro resultado, mostramos que em dimensão finita existe uma correspondência canônica entre os vetores do espaço dual \(V^{\ast }\) e os vetores de \(V\).
Considere uma base ortonormal \(\underline{\textsc{x}}=\{ \bm {x}_{1}, \ldots , \bm {x}_{n}\} \) de \(V\). Como \(\bm {x}=\langle \bm {x}, \bm {x}_{1}\rangle \bm {x}_{1}+\ldots + \langle \bm {x}, \bm {x}_{n}\rangle \bm {x}_n\), temos
Defina \(\bm {y}=\overline{ f(\bm {x}_{1})}\bm {x}_{1}+\ldots +\overline{ f(\bm {x}_{n})}\bm {x}_{n}.\) Se também \(f(\bm {x})=\langle \bm {x},\bm {z}\rangle \) para todo \(\bm {x}\in V\), então \(\langle \bm {x},\bm {y}-\bm {z}\rangle =0\) para todo \(\bm {x}\in V\); tomando \(\bm {x}=\bm {y}-\bm {z}\), obtemos \(\bm {y}=\bm {z}\).
Para \(f\in V^{\ast }\), denotaremos por \(f^{\sharp }\) o único vetor \(\bm {y}\in V\) tal que
A aplicação \(f\mapsto f^{\sharp }\) é aditiva. Sobre \(\mathbb {R}\), ela é linear; sobre \(\mathbb {C}\), é conjugado-linear, pois \((\lambda f)^{\sharp }=\overline\lambda ,f^{\sharp }\).
Para \(\bm {w}\in W\) fixo, a aplicação \(\bm {v}\mapsto \langle T\bm {v}, \bm {w}\rangle \) pertence ao dual de \(V\). O Teorema de Representação de Riesz garante então que existe um único \(\bm {y}\in V\) tal que
Definimos \(T^{\ast }\bm {w}=\bm {y}\). Temos assim uma aplicação \(T^{\ast }\) : \(W\rightarrow V.\)
Para demonstrar a linearidade de \(T^{\ast }\) sejam \(\bm {u}, \bm {w}\in W\) e \(\lambda \in \mathbb {K}. \) Então
Se \(S^{\ast }\) : \(W\rightarrow V\) fosse outra aplicação linear tal que \(\langle T\bm {v}, \bm {w}\rangle = \langle \bm {v}, S^{\ast }\bm {w}\rangle , \) então \(\langle \bm {v}, T^{\ast }\bm {w}-S^{\ast }\bm {w}\rangle =0\) para todo \(\bm {v}\in V\). Escolhendo \(\bm {v}=T^{\ast }\bm {w}-S^{\ast }\bm {w}\), concluímos que \(T^{\ast }=S^{\ast }\)
O resultado a seguir enumera algumas propriedades do mapa \(T\mapsto T^{\ast }\) de \(\operatorname {Hom}(V,W)\) em \(\operatorname {Hom}(W,V)\).
Se \( S, T \in \operatorname {Hom}(V, \ W) \) então \( (S+T)^{\ast } = S^{\ast }+T^{\ast } \);
Se \( T \in \operatorname {Hom}(V, \ W) \) e \( \lambda \in \mathbb {K}\), então \( (\lambda T)^{\ast } = \overline{\lambda } T^{\ast }.\);
Se \( S \in \operatorname {Hom}(V, \ W) \) e \( T \in \operatorname {Hom}(W, \ Z) \), então \( (TS)^{\ast } = S^{\ast } T^{\ast } \);
Se \( T \in \operatorname {Hom}(V, \ W) \) então \( (T^{\ast })^{\ast } = T \); e
\( I_{V}^{\ast } = I_{V}\).
Munimos \(V\), \(W\) e \(Z\) dos produtos internos indicados no enunciado.
1 Seja \( \bm {v}\in V, \bm {w}\in W \). Então
Consequentemente, \( (S+T)^{\ast } (\bm {w}) = S^{\ast } (\bm {w})+T^{\ast } (\bm {w}) \) para todos os \( \bm {w}\in W \) e, portanto, \( (S+T)^{\ast } = S^{\ast }+T^{\ast }.\)
2 Sejam \( \bm {v}\in V, \bm {w}\in W \) e \( \lambda \) um escalar. Então
Podemos então concluir que \( (\lambda T)^{\ast } = \overline{\lambda } T^{\ast }.\)
3 Se \(S:V\to W\), \(T:W\to Z\), \(\bm {v}\in V\) e \(\bm {z}\in Z\), então
Pela unicidade da adjunta, \((T\circ S)^*=S^*\circ T^*\).
4 Para \(\bm {v}\in V\) e \(\bm {w}\in W\), temos
Como isso vale para todo \(\bm {w}\), segue que \((T^{\ast })^{\ast }\bm {v}=T\bm {v}\) para todo \(\bm {v}\).
5 Por fim, \(\langle I_V\bm {v},\bm {w}\rangle _V=\langle \bm {v},\bm {w}\rangle _V =\langle \bm {v},I_V\bm {w}\rangle _V\); pela unicidade da adjunta, \(I_V^{\ast }=I_V\).
Em seguida, apresentaremos algumas relações entre a imagem e o núcleo de \( T \in \operatorname {Hom}(V, \ W) \) e de \( T^{\ast } \in \operatorname {Hom}(W, \ V) \).
\( \ker (T^{\ast }) = \operatorname {im}(T)^{\perp } \);
\(\operatorname {im}(T^{\ast }) =\ker (T)^{\perp } \);
\(\ker (T) = \operatorname {im}(T^{\ast })^{\perp } \); e
\(\operatorname {im}(T) =\ker (T^{\ast })^{\perp }.\)
Sejam \( (V, \ \langle \cdot ,\cdot \rangle _{V}) \), \( (W, \ \langle \cdot ,\cdot \rangle _{W}) \).
1 Suponha \( \bm {w}\in \ker (T^{\ast }) \). Então \( \langle \bm {v}, T^{\ast } (\bm {w}) \rangle _{V} = \langle \bm {v}, \vec0 \rangle _{V} = 0 \) para todos os \( \bm {v}\in V. \) Pela definição de \( T^{\ast }, \langle \bm {v}, T^{\ast } (\bm {w}) \rangle _{V} = \langle T (\bm {v}), \bm {w}\rangle _{W} \). Isso implica que \( \bm {w}\perp T (\bm {v}) \) para todos os \( \bm {v}\in V \) e, portanto, \( \bm {w}\in \operatorname {im}(T)^{\perp } \). Portanto, \(\ker (T^{\ast }) \subseteq \operatorname {im}(T)^{\perp }.\)
Seja \( \bm {w}\in \operatorname {im}(T)^{\perp } \). Então, para todos os \( \bm {v}\in V, \langle T (\bm {v}), \bm {w}\rangle _{W} = 0 \). Mas então, pela definição de \( T^{\ast }, \langle \bm {v}, T^{\ast } (\bm {w}) \rangle _{V} = 0 \). Em particular, \( \langle T^{\ast } (\bm {w}), T^{\ast } (\bm {w}) \rangle _{V} = 0 \), e logo , \( T^{\ast } (\bm {w}) = \vec0 \) e \( \bm {w}\in \ker (T^{\ast }) \).
Como \( (T^{\ast })^{\ast } = T \), temos que 3 é consequência de 1.
De 1 também deduzimos que \(\ker (T^{\ast })^{\perp } = [\operatorname {im}(T)^{\perp }]^{\perp } = \operatorname {im}(T) \) e, consequentemente, 4 também é verdadeiro.
Finalmente, como \(\ker (T) = \operatorname {im}(T^{\ast })^{\perp } \), temos que \(\ker (T)^{\perp } = [\operatorname {im}(T^{\ast })^{\perp }]^{\perp } = \operatorname {im}(T^{\ast }) \), e assim 2 é válido.
O teorema seguinte relaciona as matrizes de \(T\) e \(T^{\ast }\) calculadas em bases ortonormais de \(V\) e \(W\).
Munimos \(V\) e \(W\) dos produtos internos indicados no enunciado. Então
Precisamos provar que \( b_{ji} = \overline{a_{ij}} \) ou equivalente, que \( a_{ij} = \overline{b_{ji}} \). Fazemos isso calculando \(\langle T (\bm {v}_{j}), \bm {w}_{i} \rangle _{W} = \langle \bm {v}_{j}, T^{\ast } (\bm {w}_{i}) \rangle _{V } \) usando as Equações 7.2 e 7.3.
Por um lado
na última igualdade, utilizamos que \(\underline{\textsc{w}} \) é uma base ortonormal de \(W\). Por outro lado,
Assim, \( a_{ij} = \overline{b_{ji}} \).
7.6.1 Mínimos quadrados
Sejam \(A\in \mathcal{M}_{m, n}(\mathbb {R})\) e \(\bm {b}\in \mathbb {R}^m\). Quando o sistema \(A\bm {x}=\bm {b}\) não possui solução, procuramos um vetor \(\widehat{\bm {x}}\) que minimize
Como \(A\bm {x}\) percorre \(\operatorname {im}A\), o Teorema da Projeção mostra que esse mínimo é atingido exatamente quando
Equivalentemente,
Pelas relações entre imagem e núcleo da adjunta, \((\operatorname {im}A)^\perp =\ker A^{\mathrm{t}}\) no caso real. Portanto,
Essas são as equações normais do problema de mínimos quadrados.
Se \(A\) tem posto coluna completo, então \(A^{\mathrm{t}}A\) é invertível. De fato,
que é positivo para todo \(\bm {x}\neq \vec0\). Nesse caso a solução de mínimos quadrados é única e
Os exercícios seguintes desenvolvem essa construção em problemas de aproximação, regressão e fatoração QR.
Determine todos os minimizadores de \(\| A_ix-b_i\| \) nos três casos: Verifique a ortogonalidade dos resíduos às colunas de cada matriz.
Sejam \(V,W\) espaços de dimensão finita com produto interno, \(A:V\to W\) linear e \(b\in W\). Um minimizador de \(\| Ax-b\| \) é chamado solução de mínimos quadrados.
Prove que \(x\) é minimizador se, e somente se, \(Ax=P_{\operatorname {im}A}b\), ou, equivalentemente, \(A^\ast Ax=A^\ast b\).
Mostre que \(\ker (A^\ast A)=\ker A\) e que \(\operatorname {posto}(A^\ast A)=\operatorname {posto}A\).
Prove que os minimizadores formam \(x_0+\ker A\), onde \(x_0\) é qualquer minimizador. Quando a solução é única?
No caso real, se \(A=QR\) é uma fatoração reduzida com colunas independentes, prove que \(Rx=Q^Tb\). Explique como resolver esse sistema por substituição regressiva.
Seja \(A\) autoadjunto em um espaço real com produto interno e \(v\neq 0\). Determine o escalar \(\lambda \in \mathbb {R}\) que minimiza \(\| Av-\lambda v\| \) e o valor mínimo ao quadrado. Quando esse mínimo é zero?
Um modelo \(y_i\approx \sum _j\beta _j f_j(s_i)\) é linear nos parâmetros, mesmo quando as funções \(f_j\) não são lineares. Escreva a linha \(i\) da matriz de projeto para: um polinômio de grau no máximo \(k\) em \(x_i\); uma tendência linear no tempo acrescida de uma oscilação com período conhecido \(T\gt 0\); um plano em duas variáveis \(u_i,v_i\); um modelo com termo constante, oscilação em \(u\) com frequência conhecida \(\omega \), termos linear e quadrático em \(v\) e termo \(uv\).
Para dados \((x_i,y_i)\), \(1\leq i\leq N\), ajuste a reta \(y=\beta _0+\beta _1x\) minimizando a soma dos quadrados dos resíduos verticais.
Escreva a matriz de projeto e prove que o ajuste é único se existem dois valores distintos de \(x_i\). Interprete a ortogonalidade do resíduo às colunas da matriz. Explique por que uma reta pode ser inadequada para dados com tendência curvilínea.
Ponha \(z_i=x_i-\overline x\). Mostre que as colunas \(1\) e \(z\) são ortogonais e calcule \(X^TX\) para essa parametrização. Elas já são ortonormais?
Deduza fórmulas para \(\widehat\beta _0,\widehat\beta _1\) e ajuste os pontos \((2,3),(3,2),(5,1),(6,0)\).
Represente os pontos \((1,1{,}8),(2,2{,}7),(3,3{,}4),(4,3{,}8),(5,3{,}9)\) e ajuste o modelo \(y=\beta _0+\beta _1x+\beta _2x^2\) por mínimos quadrados. Compare o sinal de \(\beta _2\) com a tendência observada.
Explique por que a matriz \(V=(x_i^{j-1})_{1\leq i,j\leq N}\) é invertível quando os \(x_i\) são distintos. Use-a para determinar o polinômio de grau no máximo quatro que interpola \((-2,3),(-1,5),(0,5),(1,4),(2,3)\). Compare o resultado com o ajuste quadrático por mínimos quadrados.
Sejam \(w_i\gt 0\) e \(D=\operatorname {diag}(w_1,\ldots ,w_N)\). Para um modelo linear \(X\beta \approx y\), minimize \(E(\beta )=\sum _{i=1}^Nw_i^2((X\beta )_i-y_i)^2\). Determine as equações normais, interprete o problema como mínimos quadrados usuais e dê uma condição para a unicidade.
Considere \(r=\beta +e\, r\cos \theta \), com \(\theta \) em radianos. Foram observados os pares \((r,\theta )\): \((3,0{,}88),(2{,}3,1{,}1),(1{,}65,1{,}42),(1{,}25,1{,}77),(1{,}01,2{,}14)\).
Escreva a matriz de projeto para estimar \(\beta ,e\) por mínimos quadrados e calcule esses parâmetros.
Classifique a órbita pelo valor de \(e\): elipse se \(0\leq e\lt 1\), parábola se \(e=1\), hipérbole se \(e\gt 1\).
Estime \(r\) para \(\theta =4{,}6\).
Para nós reais distintos \(x_1,\ldots ,x_N\) e \(k\lt N\), defina em \(\mathbb {R}_k[t]\) o produto \(\langle p,q\rangle =\sum _{i=1}^Np(x_i)q(x_i)\).
Prove que esse produto é definido positivo e explique por que a condição sobre o número de nós é necessária.
Aplique Gram–Schmidt a \(1,t,t^2\) usando os nós \(-2,-1,0,1,2\); calcule as normas dos polinômios ortogonais.
Para uma base ortogonal \(p_0,\ldots ,p_k\), mostre que o polinômio de mínimos quadrados para os dados \((x_i,y_i)\) é \(\sum _jc_jp_j\), onde \(c_j=\sum _i y_ip_j(x_i)/\| p_j\| ^2\). É preciso conhecer previamente um polinômio interpolador?
Ajuste tendências linear e quadrática a \((-2,3),(-1,5),(0,5),(1,4),(2,3)\).
7.7 Espaços de Hilbert
Para uma introdução mais ampla à teoria de espaços de Hilbert e operadores, veja Kreyszig (1978); Kubrusly (2011).
Leitura opcional.
Esta seção pode ser omitida numa primeira leitura voltada a espaços de dimensão finita. Em dimensão infinita, a completeza requer uma hipótese adicional: uma sequência de Cauchy pode não ter limite no espaço considerado.
Seja \(V\) um espaço com produto interno. A norma induz a métrica \(d(\bm {u},\bm {v})=\lVert \bm {u}-\bm {v}\rVert \). Dizemos que uma sequência \((\bm {v}^n)\) converge para \(\bm {v}\in V\) quando
Todo espaço com produto interno de dimensão finita é completo; seus subespaços são fechados e suas transformações lineares são contínuas. Em dimensão infinita, nenhuma dessas conclusões é automática. O exemplo central é o espaço das sequências quadrado somáveis.
A completeza de \(\mathbb {R}^n\) e \(\mathbb {C}^n\) segue da completeza do corpo coordenada a coordenada. Provaremos o caso de \(\ell ^2\).
Seja \((\bm {x}^k)\) uma sequência de Cauchy em \(\ell ^2\), com
Para cada índice fixo \(n\),
logo \((x_n^k)_k\) é de Cauchy em \(\mathbb {K}\). Denote seu limite por \(a_n\) e ponha \(\vec{a}=(a_n)_{n\geq 1}\); resta provar que \(\vec{a}\in \ell ^2\) e que \(\bm {x}^k\to \vec{a}\).
Dado \(\epsilon \gt 0\), escolha \(k_0\) tal que \(\lVert \bm {x}^k-\bm {x}^l\rVert \lt \epsilon \) sempre que \(k,l\geq k_0\). Para todo \(N\) e todo \(k,l\geq k_0\),
Fazendo \(l\to \infty \) nessa soma finita, obtemos
Como isso vale para todo \(N\), segue que
Em particular, \(\bm {x}^{k_0}-\vec{a}\in \ell ^2\) e, portanto, \(\vec{a}=\bm {x}^{k_0}-(\bm {x}^{k_0}-\vec{a})\in \ell ^2\). A mesma desigualdade mostra que \(\lVert \bm {x}^k-\vec{a}\rVert \leq \epsilon \) para \(k\geq k_0\). Assim, \(\bm {x}^k\to \vec{a}\), e \(\ell ^2\) é completo.
O teorema de projeção finito-dimensional admite agora sua forma completa. A hipótese de que o subespaço seja fechado substitui a hipótese de dimensão finita.
Fixe \(\bm {x}\in V\) e ponha
Escolha \((\bm {s}_n)\) em \(S\) de modo que \(\lVert \bm {x}-\bm {s}_n\rVert ^2\lt d^2+1/n\). Pela regra do paralelogramo,
pois \((\bm {s}_n+\bm {s}_m)/2\in S\). Logo \((\bm {s}_n)\) é de Cauchy. A completeza de \(V\) e o fato de \(S\) ser fechado fornecem \(\bm {s}_n\to \bm {s}\in S\), e então \(\lVert \bm {x}-\bm {s}\rVert =d\).
Escreva \(\vec{r}=\bm {x}-\bm {s}\). Se existisse \(\bm {u}\in S\) com \(\langle \vec{r},\bm {u}\rangle \neq 0\), tomando \(\lambda =\langle \vec{r},\bm {u}\rangle /\lVert \bm {u}\rVert ^2\) teríamos
contradizendo a minimalidade de \(\bm {s}\). Portanto, \(\vec{r}\in S^\perp \). A decomposição é única porque \(S\cap S^\perp =\{ \vec0\} \).
Podemos agora caracterizar os sistemas ortonormais maximais: em um espaço de Hilbert, são exatamente aqueles cujo espaço gerado é denso.
Se \(\overline{\langle A\rangle }=V\), então \(A\) é ortonormal maximal.
Se \(V\) é um espaço de Hilbert e \(A\) é ortonormal maximal, então \(\overline{\langle A\rangle }=V\).
Temos \(A^\perp =(\langle A\rangle )^\perp =(\overline{\langle A\rangle })^\perp \); a segunda igualdade segue da continuidade do produto interno. Se \(\overline{\langle A\rangle }=V\), então \(A^\perp =\{ \vec0\} \), e nenhum vetor unitário pode ser acrescentado a \(A\) preservando a ortonormalidade. Logo \(A\) é maximal.
Reciprocamente, suponha que \(V\) seja de Hilbert e que \(A\) seja maximal. O Teorema 7.57, aplicado ao subespaço fechado \(\overline{\langle A\rangle }\), fornece
A maximalidade implica \(A^\perp =\{ \vec0\} \); portanto, o segundo somando é nulo e \(\overline{\langle A\rangle }=V\).
Uma base de Hilbert não deve ser confundida com uma base vetorial, também chamada de base de Hamel. A primeira permite recuperar vetores por limites de somas; a segunda permite apenas combinações lineares finitas.
Em \(\ell ^2\), seja \(M=\{ \vec e_1,\vec e_2,\ldots \} \), onde \(\vec e_i\) tem valor \(1\) na \(i\)-ésima coordenada e zero nas demais. O conjunto \(M\) é ortonormal. Se \(\bm {v}=(x_n)\) é ortogonal a todos os \(\vec e_i\), então
para todo \(i\); logo \(\bm {v}=\vec0\). Assim, \(M\) é maximal e, pela proposição anterior, é uma base de Hilbert de \(\ell ^2\).
Entretanto, \(\langle M\rangle \) contém apenas as sequências de suporte finito e é um subespaço próprio de \(\ell ^2\). Portanto, \(M\) não é uma base de Hamel.
7.7.1 Espaços de Hilbert Separáveis e Séries de Fourier
A demonstração será dada como consequência do teorema a seguir.
Para formular a expansão de Fourier como uma expansão em base, precisamos de uma noção que admita séries convergentes.
\(O\) é completo, isto é, \(\overline{\langle O\rangle }=V\).
Se \(x\perp e_n\) para todo \(n\geq 1\), então \(x=0\).
Todo \(x\in V\) possui a expansão de Fourier
\[ x=\sum _{n=1}^{\infty }\langle x,e_n\rangle e_n; \]em particular, \((e_n)\) é uma base de Schauder de \(V\).
Vale a identidade de Parseval
\[ \lVert x\rVert ^{2}=\sum _{n=1}^{\infty }|\langle x,e_n\rangle |^{2} \]para todo \(x\in V\).
A equivalência entre 1 e 2 segue de \((\langle O\rangle )^\perp =\{ 0\} \) se, e somente se, \(\overline{\langle O\rangle }=V\).
Suponha 2 e fixe \(x\in V\). Escreva \(a_n=\langle x,e_n\rangle \) e \(y_N=\sum _{n=1}^{N}a_ne_n\). Pela desigualdade de Bessel, as somas \(\sum _{n=1}^{N}|a_n|^2\) são crescentes e limitadas por \(\lVert x\rVert ^{2}\); portanto, a série \(\sum _n|a_n|^2\) converge. Se \(M\gt N\), a ortonormalidade fornece
Assim, \((y_N)\) é de Cauchy e converge, pela completeza de \(V\), para algum \(y\in V\). Para cada \(j\), a desigualdade de Cauchy–Schwarz permite passar ao limite e obter \(\langle y,e_j\rangle =a_j=\langle x,e_j\rangle \). Logo \(x-y\) é ortogonal a todos os \(e_j\); por 2, \(x=y\). Os coeficientes são únicos: se \(x=\sum _n b_ne_n\), tomar o produto interno com \(e_j\) fornece \(b_j=\langle x,e_j\rangle \). Isso prova 3.
Se 3 vale, então
que é 4. Finalmente, se 4 vale e \(x\perp e_n\) para todo \(n\), então \(\lVert x\rVert ^{2}=0\); logo \(x=0\) e vale 2.
Como \(V\) é separável e tem dimensão infinita, ele possui uma base de Hilbert enumerável \(\{ e_n\} _{n\geq 1}\). Defina
A identidade de Parseval mostra que \(U\) está bem definida, é linear e preserva a norma. Para \((a_n)\in \ell ^2\), as somas parciais \(\sum _{n=1}^{N}a_ne_n\) formam uma sequência de Cauchy em \(V\) e, pela completeza, convergem para algum \(x\in V\). A continuidade do produto interno dá \(\langle x,e_n\rangle =a_n\) para todo \(n\), de modo que \(U\) é sobrejetiva. Portanto, \(U\) é um isomorfismo isométrico.
\(L^2([a,b])\) é um espaço de Hilbert separável. Encerramos esta leitura opcional registrando, sem demonstração, alguns sistemas ortogonais completos clássicos.
Série de Fourier em \(L^2[-\pi ,\pi ]\):
\[ \left\{ \frac{1}{\sqrt{2\pi }},\frac{\cos (nx)}{\sqrt\pi },\frac{\sin (nx)}{\sqrt\pi }\, \mid \, n=1,2,\ldots \right\} . \]Polinômios de Legendre em \(L^2[-1,1]\). Se
\[ P_{k} (x) = \frac{1}{2^{k} k!} \frac{d^{k}}{dx^{k}} (x^{2} -1)^{k}, \qquad k=0,1,\ldots , \]então \(\left\{ \sqrt{(2k+1)/2}\, P_k\, \mid \, k\geq 0\right\} \) é ortonormal e completo.
Funções de Bessel em \(L^2[0,1]\). Para \(\nu \gt -1\), sejam \(j_{\nu ,k}\) os zeros positivos de \(J_\nu \). Então
\[ \left\{ \frac{\sqrt{2x}}{|J_{\nu +1}(j_{\nu ,k})|}J_\nu (j_{\nu ,k}x)\, \mid \, k=1,2,\ldots \right\} \]é um sistema ortonormal completo.
Polinômios de Hermite em \(L^2(\mathbb {R},e^{-x^2}dx)\),
\[ H_{k} (x) = (- 1)^{k} \displaystyle \exp \left(x^{2} \right) \frac{d^{k}}{dx^{k}} (\exp \left( -x^{2} \right)), k = 0,1, \ldots \]normalizados pelos fatores \((2^k k!\sqrt\pi )^{-1/2}\).
Polinômios de Chebyshev do primeiro tipo em \(L^2((-1,1),(1-x^2)^{-1/2}dx)\):
\[ T_k(x)=\cos (k\arccos x),\qquad k=0,1,\ldots . \]O sistema ortonormal correspondente é \(\{ T_0/\sqrt\pi \} \cup \{ \sqrt{2/\pi }\, T_k\, \mid \, k\geq 1\} \).
Seja \(T:W\rightarrow V\) uma transformação linear injetiva entre \(\mathbb {K}\)-espaços vetoriais. Suponha que \(\left\langle ,\right\rangle \), é um produto interno em \(V\). Mostre que \(\langle w_{1},w_{2}\rangle =\langle T(w_{1}),T(w_{2})\rangle \) para todos \(w_{1},w_{2}\in W\) define um produto interno em \(W\). [Em particular, se \(V\) é um espaço vetorial com produto interno \(\left\langle ,\right\rangle \) , \(W\) um subespaço de \(V\) e \(T:W\to V\) é a inclusão natural, teremos como consequência que \(\left\langle ,\right\rangle \) restrito aos elementos de \(W\) é um produto interno em \(W\).]
Dizemos que uma matriz \(A\in M_{n}(\mathbb {K})\) hermitiana (i.e. \(A^{\ast }=A\)) é positiva definida se para toda matriz coluna não nula \(\mathrm{X}\in M_{n\times 1}(\mathbb {K})\) tem-se que \(\mathrm{X}^{\ast }A\mathrm{X}\gt 0\).
Mostre que se \(V\) é um espaço vetorial sobre \(\mathbb {K}\) com produto interno \(\langle ,\rangle \) e se \(\underline{\textsc{B}}=\{ v_{1},v_{2},\dots ,v_{n}\} \) é uma base de \(V\) então \(A=(a_{ij})\in M_{n}(\mathbb {K})\) , onde \(a_{ij}=\langle v_{i},v_{j}\rangle \) para todo \(1\leq i,j\leq n\) é uma matriz positiva definida.
Mostre que se \(A=(a_{ij})\in M_{n}(\mathbb {K})\) é uma matriz positiva definida, \(\underline{\textsc{B}}\) é uma base de um espaço vetorial sobre \(\mathbb {K}\) \(V\) então
\[ \left\langle u,v\right\rangle :=[u]_{\underline{\textsc{B}}}^{\mathrm{t}}A\, \overline{[v]_{\underline{\textsc{B}}}}\quad \text{para todo }u,v\in V \]define um produto interno em \(V.\)
Seja \(V\) um espaço com produto interno \(\left\langle ,\right\rangle \) de dimensão finita \(n\). Mostre que um conjunto de vetores \(\{ v_{1},v_{2},\dots ,v_{n}\} \) é linearmente independente se, e só se, a matriz \(A=\left(\left\langle v_{i},v_{j}\right\rangle \right)\in M_{n}(\mathbb {K})\) é não singular.
Seja \(V\) um \(\mathbb {K}\)-e.v. com produto interno.
Se \(\mathbb {K}=\mathbb {R}\), mostre que \(\langle u,v\rangle =0\Leftrightarrow \Vert u+v\Vert ^{2}=\Vert u\Vert ^{2}+\Vert v\Vert ^{2}\)
Mostre que isso não é verdade se \(\mathbb {K}=\mathbb {C}.\)
Se \(\mathbb {K}=\mathbb {C}\), mostre que para \(u,v\in V\) \(\left\langle u,v\right\rangle =0\Leftrightarrow \Vert \alpha u+\beta v\Vert ^{2}=\Vert \alpha u\Vert ^{2}+\Vert \beta v\Vert ^{2}\), para todos \(\alpha ,\beta \in \mathbb {C}.\)
Seja \(V\) um \(\mathbb {K}\)-e.v. com produto interno. Sejam \(u,v\in V\), prove:
Lei do Paralelogramo: \(\Vert u+v\Vert ^{2}+\Vert u-v\Vert ^{2}=2\left(\Vert u\Vert ^{2}+\Vert v\Vert ^{2}\right)\).
Desigualdade de Bessel: seja \(\{ v_{1},\ldots ,v_{n}\} \) um conjunto ortonormal de \(V\), então\({\displaystyle \sum _{k=1}^{n}\left|\left\langle v,v_{k}\right\rangle \right|{}^{2}\leq \Vert v\Vert ^{2}}\).
Identidade de Parseval: seja \(\{ v_{1},\ldots ,v_{n}\} \) uma base ortonormal de \(V\). Mostre que \(\left\langle v,u\right\rangle =\sum _{k=1}^{n}\langle v,v_{k}\rangle \langle v_{k},u\rangle \).
Seja \(V\) um \(\mathbb {C}\)-e.v. com produto interno
Fixe vetores \(w,u\in V\). Mostre que o operador \(T:V\rightarrow V\) definido por \(T(v)=\left\langle v,w\right\rangle u\), admite adjunta e a descreva explicitamente.
Suponha \(\dim V\lt \infty \) e que \(\left\langle T(v),v\right\rangle =0\), para todo \(v\in V\). Mostre que \(T=0\). Mostre que o resultado não é necessariamente verdadeiro se \(V\) é um \(\mathbb {R}\)-e.v.
Seja \(V\) um \(\mathbb {R}\)-espaço vetorial de dimensão finita com um produto interno. Seja \(W\subseteq V\) um subespaço, mostre que cada classe de equivalência do quociente \(V/W\) possui exatamente um vetor ortogonal a \(W\).
Determine o mínimo do conjunto : \(\left\{ \displaystyle \int _{0}^{1}(t^{2}-at-b)^{2}\mathrm{d}t:a,b\in \mathbb {R}\right\} \).
Seja \(V=C([0,1],\mathbb {R})\) o espaço das funções contínuas no intervalo \([0,1]\) com o produto interno \(\langle f,g\rangle ={\displaystyle \displaystyle \int _{0}^{1}f(t)g(t)dt.}\)
Exiba uma base ortonormal do subespaço de \(V\) gerado pelos polinômios \(1\), \(t\) e \(t^{2}.\)
Encontre o polinômio de grau menor ou igual a \(2\) que melhor aproxima \(f(t)=\cos t\) no intervalo \([0,1].\)
Seja \(V\) um \(\mathbb {K}\)-e.v. com produto interno. Suponha que \(U\) e \(W\) sejam subespaços de \(V\). Mostre que:
\(W\subseteq (W^{\perp })^{\perp }\) e se \(V=W\oplus W^{\perp }\) então \(W=(W^{\perp })^{\perp }\).
\((U+W)^{\perp }=U^{\perp }\cap W^{\perp }\).
\(U^{\perp }+W^{\perp }\subseteq (U\cap W)^{\perp }\).
Se \(V=U\oplus U^{\perp }=W\oplus W^{\perp }\), então \(U^{\perp }+W^{\perp }=(U\cap W)^{\perp }\).
Considere \(\mathbb {R}[x]\) com o produto interno \(\left\langle p,q\right\rangle ={\displaystyle \displaystyle \int _{0}^{1}p(x)q(x)dx}\) e seja \(W\) o subespaço constituído por todos os polinômios com termo constante igual a zero. Mostre que \(W^{\perp }=\{ 0\} \) e então \(W^{\perp \perp }=\mathbb {R}[x]\neq W\). Também \(\mathbb {R}[x]\neq W\oplus W^{\perp }\).
Seja \(W\) um subespaço de dimensão finita de \(V\). Existem, em geral, vários operadores projeções cuja imagem é \(W\). Prove que se \(E\in \operatorname {Hom}(V,V)\) é uma projeção cuja imagem é \(W\) e \(\Vert E(v)\Vert \leq \Vert v\Vert \), para todo \(v\in V\), então \(E\) é a projeção ortogonal em \(W\), i.e. \(E=E_{W}\).
Seja \(W\) um subespaço vetorial de dimensão finita de um espaço \(V\) com produto interno. Seja \(E_{W}\) a projeção ortogonal de \(V\) em \(W\). Mostre que \(\operatorname {I}-E_{W}\) é a projeção ortogonal de \(V\) em \(W^{\perp }\), é um operador projeção e \(\ker (\operatorname {I}-E_{W})=W\). (Obs: \(W^{\perp }\) não necessariamente terá dimensão finita).
Seja \(V\) um \(\mathbb {K}\)-e.v. com produto interno \(\left\langle ,\right\rangle \), \(\alpha \in \mathbb {K}\) e sejam \(T,S\in \operatorname {Hom}(V,V)\) que admitem adjuntos. Mostre que os seguintes operadores admitem adjuntos:
\(T+S\) e \((T+S)^{\ast }=T^{\ast }+S^{\ast }\).
\(\alpha T\) e \((\alpha T)^{\ast }=\overline{\alpha }T^{\ast }\).
\(T\circ S\) e \((T\circ S)^{\ast }=S^{\ast }\circ T^{\ast }\).
\(T^{\ast }\) e \((T^{\ast })^{\ast }=T\).
Se \(T,S\in \operatorname {Hom}(V,V)\) são operadores normais então é verdade que \(\alpha T\), \(T+S\) e \(T\circ S\) são normais?
Seja \(T\) um operador linear em \(V\) que possui um adjunto \(T^{\ast }.\) Mostre que:
\(\ker T^{\ast }=(\operatorname {im}T)^{\perp }\) e que \(\operatorname {im}T^{\ast }\subset (\ker T)^{\perp }.\)
Se \(\dim V\lt \infty \), então \(\operatorname {im}T^{\ast }=(\ker T)^{\perp }.\)
Se \(\dim V\lt \infty \), \(T\) é injetiva se, e somente se, \(T^{\ast }\)é sobrejetiva e vice-versa.
Seja \(V=C([0,1],\mathbb {R})\) , com o produto interno \(\left\langle f,g\right\rangle ={\displaystyle \displaystyle \int _{0}^{1}f(t)g(t)dt}\), e considere o operador
\begin{align*} T:V & \to V\\ f & \mapsto T(f):[0,1]\mapsto \mathbb {R}\\ & \hspace{2.35cm}t\mapsto tf(t) \end{align*}Determine \(T^{\ast }\) e mostre que \(\operatorname {im}T^{\ast }\neq (\ker T)^{\perp }\).
Seja \(T\in L(V)\). Prove que se \(T\) é invertível, então \(T^{\ast }\) é invertível e \((T^{\ast })^{-1}=(T^{-1})^{\ast }\).
Seja \(\mathbb {R}_2[x]\) com o produto interno dado por \(\left\langle f,g\right\rangle =\displaystyle \int _{0}^{1}f(x)g(x)\operatorname {dx}\). Considere o operador \(T:\mathbb {R}_2[x]\to \mathbb {R}_2[x]\) dado por \(T(ax^{2}+bx+c)=bx\).
Mostre que \(T\) não é autoadjunto.
A matriz de \(T\) na base canônica é
\[ \left[\begin{array}{ccc} 0 & 0 & 0\\ 0 & 1 & 0\\ 0 & 0 & 0 \end{array}\right] \]que é simétrica. Explique por que isso não contradiz o item 1..
Sejam \(V\) um \(\mathbb {C}\)-e.v. com produto interno de dimensão finita e \(T\in \operatorname {Hom}(V,V)\) um operador normal. Mostre que:
\(T=\lambda _{1}P_{1}+\ldots +\lambda _{k}P_{k}\) onde \(\operatorname {I}=P_{1}+\ldots +P_{k}\) , \(P_{i}P_{j}=0\) se \(i\neq j\) e \(P_{i}^{2}=P_{i}=P_{i}^{\ast }\).
Existe \(g\in \mathbb {C}[x]\) tal que \(T^{\ast }=g(T)\).
Todo subespaço de \(V\) \(T\)-invariante é também \(T^{\ast }\)-invariante.
Seja \(V\) um \(\mathbb {C}\)-espaço vetorial com produto de interno complexo de dimensão finita. Considere \(T\in \operatorname {Hom}(V,V)\) um operador qualquer e \(\lambda _{1},\dots ,\lambda _{n}\) os autovalores de \(T\) (aparecendo tantas vezes quanto sua multiplicidade algébrica). Mostre que:
\(\sum _{i=1}^{n}\left|\lambda _{i}\right|^{2}\leq \operatorname {tr}(T^{\ast }\circ T)\)
A igualdade vale se, e somente se, \(T\) é normal.
Seja
Ache uma matriz ortogonal \(P\in M_{3}(\mathbb {R})\) tal que \(P^{T}AP\) é diagonal.
Considere um \(\mathbb {C}\)-espaço vetorial \(V\) com o produto interno e dimensão finita. Dizemos que um operador \(T:V\to V\) é anti-hermitiano ou anti-autoadjunto se para quaisquer vetores \(u,v\in V\) tem-se que \(\left\langle T(u),v\right\rangle =-\left\langle u,T(v)\right\rangle \). Assuma que \(T\) é anti-hermitiano e mostre que:
Os autovalores de \(T\) são imaginários puros.
Se \(v_{1},v_{2}\in V\) são autovetores associados a autovalores distintos \(\lambda _{1},\lambda _{2}\in \mathbb {C}\) então eles são ortogonais.
Existe uma base ortonormal de \(V\) formada por autovetores de \(T\).
Determine a forma polar da matriz
Em um espaço real com produto interno, defina \(\mathfrak g(v_1,\ldots ,v_r)=\det (\langle v_i,v_j\rangle )\). Prove que esse número é positivo exatamente quando os vetores são independentes. Se \(w\) é a projeção de \(v_1\) sobre o espaço gerado pelos demais e \(h=v_1-w\), mostre
Deduza que o volume do paralelepípedo gerado é \(\sqrt{\mathfrak g}\). No caso \(r=n=\dim V\), se as colunas de \(A\) são os vetores em uma base ortonormal, prove que esse volume é \(|\det A|\).
Prove que toda matriz unitária triangular superior é diagonal e que seus elementos diagonais têm módulo \(1\). Conclua que, se esses elementos forem reais e positivos, a matriz é a identidade.