Convergência
Passaremos do estudo de uma variável ou de um vetor ao comportamento de sequências de variáveis aleatórias \(X_1,X_2,\ldots \). Nesse contexto, a aproximação a um limite pode ser formulada de maneiras distintas.
Podemos exigir que a probabilidade de um erro grande tenda a zero, acompanhar cada realização \(\omega \) e estudar a convergência ao longo da trajetória, ou comparar apenas as distribuições. Essas noções expressam aspectos diferentes da aproximação, e suas relações serão desenvolvidas neste capítulo.
Começaremos pelas desigualdades de Markov e Chebyshev, que usam informação sobre médias e variâncias para limitar probabilidades. Em seguida, estudaremos as leis dos grandes números, os lemas de Borel–Cantelli e a convergência quase certa. Por fim, o Teorema do Limite Central descreverá as flutuações da média em torno de seu limite.
9.1 Desigualdades de Markov e Chebyshev
Mesmo sem conhecer toda a distribuição de \(X\), é possível obter limites para certas probabilidades. A desigualdade de Markov usa a não negatividade e a esperança; a de Chebyshev usa a variância para controlar desvios em torno da média. Esses limites são gerais, mas podem ser pouco precisos em problemas numéricos, como mostram os exemplos desta seção.
Para \(a\gt 0\), suponha
e note que, como \(X \geq 0\),
Calculando as esperanças da última desigualdade, obtemos
o que, como \(\mathbf{E}[I]=\P (X \geq a)\), demonstra o resultado.
Como um corolário, obtemos
Como \((X-\mu )^{2}\) é uma variável aleatória não negativa, podemos aplicar a desigualdade de Markov \(\left(\operatorname {com} a=k^{2}\right.\) ) para obter
Mas como \((X-\mu )^{2} \geq k^{2}\) se e somente se \(|X-\mu | \geq k\), a Equação 9.1 é equivalente a
e a demonstração está completa.
As desigualdades de Markov e Chebyshev são úteis quando dispomos apenas da média, ou da média e da variância, da distribuição. Fornecem então limites para probabilidades que não podem ser calculadas diretamente com a informação disponível. O exemplo seguinte ilustra a aplicação de Markov e a possível diferença entre o limite obtido e a probabilidade exata.
Uma moeda é enviesada de tal forma que a probabilidade de sair cara em um único lançamento é de \(25\% \), independentemente dos outros lançamentos. Suponha que a moeda seja lançada \(20\) vezes. Use a desigualdade de Markov para obter um limite superior para a probabilidade de obter pelo menos \(16\) caras.
Sol O número de caras, \(X\), tem distribuição \(\operatorname {Bin}(20,0{,}25)\), logo:
Aplicando a desigualdade de Markov, que afirma que para qualquer variável aleatória não negativa \(X\) e qualquer \(a \gt 0\), temos \(\P (X \geq a) \leq \frac{\mathbf{E}[X]}{a}\). Portanto:
Para comparar esse limite com a probabilidade real, calculamos:
Observamos que o limite fornecido pela desigualdade de Markov é muito maior do que a probabilidade real. Isso ocorre porque a desigualdade de Markov utiliza apenas o valor esperado de \(X\) e não considera a dispersão ou a forma da distribuição. Em casos onde o evento é altamente improvável em relação ao valor esperado, como neste exemplo, a desigualdade de Markov produz um limite superior pouco preciso.
Suponha que se saiba que o número de expressos vendidos por uma cafeteria durante um dia seja uma variável aleatória com média 70.
O que se pode dizer sobre a probabilidade de que as vendas de hoje sejam superiores a 100 expressos?
Se é conhecido que a variância das vendas diárias é igual a 100, então o que se pode dizer sobre a probabilidade de que as vendas de hoje estejam entre 50 e 90?
Sol Seja \(X\) o número de expressos vendidos em um dia.
a Pela desigualdade de Markov,
b Pela desigualdade de Chebyshev,
Portanto,
Assim, a probabilidade de que as vendas de hoje estejam entre 50 e 90 é de pelo menos \(0,75.\)
A generalidade da desigualdade de Chebyshev limita sua precisão numérica: o limite obtido pode ficar distante da probabilidade que se deseja estimar. Os Exemplos 9.3 e 9.4 ilustram essa diferença.
Se \(X\) é uniformemente distribuída ao longo do intervalo \((0,10)\), então, como \(\mathbf{E}[X]=5\) e \(\operatorname {Var}(X)=\frac{25}{3}\), resulta da desigualdade de Chebyshev que
enquanto o resultado exato é
Assim, embora a desigualdade de Chebyshev esteja correta, o limite superior que ela fornece não está particularmente próximo da probabilidade real.
A desigualdade de Chebyshev é frequentemente utilizada como uma ferramenta teórica para demonstrar resultados.
Em outras palavras, as únicas variáveis aleatórias com variâncias iguais a \(0 \)são aquelas que são constantes com probabilidade \(1\).
Pela desigualdade de Chebyshev, temos, para qualquer \(n\) \(\geq 1\),
Fazendo \(n \rightarrow \infty \) e usando a propriedade da continuidade das probabilidades, obtemos
e o resultado está demonstrado.
9.2 Convergência em probabilidade e Lei Fraca dos Grandes Números
Suponha que \(X_n\) seja o número de caras em \(n\) lançamentos de uma moeda com probabilidade \(p\) de cara. A aproximação de \(X_n/n\) a \(p\) será formulada em termos da probabilidade de um desvio.
Fixamos uma tolerância \(\varepsilon \gt 0\) e consideramos a probabilidade de o erro exceder essa tolerância. A convergência em probabilidade exige que essa probabilidade tenda a zero. O conjunto de realizações em que o erro é grande pode mudar com \(n\); o controle recai sobre sua probabilidade.
A média amostral é o exemplo mais importante desse mecanismo. Se repetimos uma medição sob as mesmas condições, cada observação ainda flutua, mas a média de muitas observações tende a ser mais estável. A Lei Fraca dos Grandes Números transforma essa ideia em uma afirmação precisa: para uma amostra i.i.d., a probabilidade de a média se afastar da média populacional por mais de uma tolerância fixa tende a zero.
Esse resultado descreve a aproximação da média ao valor esperado, mas não informa a forma nem a escala das flutuações para uma amostra grande e finita. Esses aspectos serão estudados por meio do Teorema do Limite Central.
Como
resulta da desigualdade de Chebyshev que
e o resultado está demonstrado.
A Lei Fraca fornece, portanto, uma noção de consistência: médias de observações independentes tendem ao valor esperado. Comecemos pelo exemplo que motivou a seção.
Seja \(X_n\) uma variável aleatória binomial com probabilidade de sucesso \(p\) e número de tentativas \(n\). Mostre que \(X_n / n\) converge em probabilidade para \(p\).
Sol Vimos que podemos escrever \(X_n\) como \(\sum _{i=1}^{n} Y_{i}\), onde \(Y_{i}=1\) se a \(i\)-ésima tentativa resulta em sucesso, e \(Y_{i}=0\) caso contrário. Então
Além disso, \(\mathbf{E}\left(Y_{i}\right)=p\) e \(\operatorname {Var}\left(Y_{i}\right)=p(1-p)\). As condições do Teorema 9.4 são então cumpridas com \(\mu =p\) e concluímos que, para qualquer \(\varepsilon \gt 0\),
O argumento anterior também se estende a vetores aleatórios. Registramos a seguir outras propriedades da convergência em probabilidade.
Suponha que \(X_{n}\) converge em probabilidade para \(\mu _{1}\) e \(Y_{n}\) converge em probabilidade para \(\mu _{2}\). Então, as seguintes afirmações também são verdadeiras.
\(X_{n}+Y_{n}\) converge em probabilidade para \(\mu _{1}+\mu _{2}\).
\(X_{n} Y_{n}\) converge em probabilidade para \(\mu _{1} \mu _{2}\).
\(X_{n} / Y_{n}\) converge em probabilidade para \(\mu _{1} / \mu _{2}\), desde que \(\mu _{2} \neq 0\).
\(\sqrt{X_{n}}\) converge em probabilidade para \(\sqrt{\mu _{1}}\), desde que \(\P \left(X_{n} \geq 0\right)=1\).
Suponha que \(X_1,X_2,\ldots \) sejam variáveis aleatórias independentes e identicamente distribuídas, com \(\mathbf{E}[X_i]=\mu \) e \(\mathbf{E}[X_i^4]\lt \infty \). Seja
a variância amostral. Mostre que \(S_n^2\) converge em probabilidade para \(\operatorname {Var}(X_1)\).
Sol A identidade
isola duas médias amostrais. Pela Lei Fraca,
Na segunda convergência usamos \(\mathbf{E}[X_1^4]\lt \infty \), que garante variância finita para \(X_1^2\). Como \(n/(n-1)\to 1\), as propriedades da convergência em probabilidade dão
Assim, a variância amostral também é um estimador consistente.
9.3 Lema de Borel-Cantelli
O controle da probabilidade de um erro para cada \(n\) não determina, por si só, se esses erros ocorrem infinitas vezes ao longo de uma realização. Os lemas de Borel–Cantelli relacionam somas de probabilidades à ocorrência de infinitos eventos, permitindo estudar esse segundo aspecto.
Se \(\sum _{n=1}^\infty \P (A_n) \lt \infty \), então \(\P (A_n \text{ i.v.}) = 0\).
Se \(\sum _{n=1}^\infty \P (A_n) = \infty \) e os eventos \((A_n)_n\) são independentes, então \(\P (A_n \text{ i.v.}) = 1\).
Para a primeira parte, observe inicialmente que \(\bigcup _{k=n}^\infty A_k \downarrow \{ A_n \text{ i.v.} \} \). Portanto,
Assim,
Pela desigualdade da soma:
Como \(\sum _{n=1}^\infty \P (A_n) \lt \infty \), segue que o limite é zero. Assim, \(\P (\{ A_n \text{ i.v.} \} ) = 0\).
Para a segunda parte, consideremos o evento \(\{ A_n \text{ i.v.} \} ^c\). Pela Lei de De Morgan, temos:
Note que \(\bigcap _{k=n}^\infty A_k^c \uparrow \{ A_n \text{ i.v.} \} ^c\) conforme \(n \to \infty \). Logo:
Devido à independência dos eventos \((A_n)_n\):
Utilizando a cota superior \(1 - x \leq e^{-x}\) para todo \(x \in \mathbb {R}\), temos:
Como \(\sum _{n=1}^\infty \P (A_n) = +\infty \), o termo \(\exp (-\sum _{k=n}^\infty \P (A_k)) \to 0\). Portanto, \(\P (\{ A_n \text{ i.v.} \} ^c) = 0\), o que implica que \(\P (\{ A_n \text{ i.v.} \} ) = 1\).
Se pensarmos em \(n\) como tempo ou algo análogo, o que o resultado acima nos diz é que se uma sequência de eventos tem probabilidade decaindo muito rápido, então eventualmente deixaremos de observar essa sequência de eventos. De fato, note que
de modo que se \(\P (A_n \text{ i.v.})=0\), então \(\P (A_n^c \text{ q.s.})=1 .\)
Podemos aplicar o Lema de Borel-Cantelli a uma situação interessante em que se pode lucrar com uma série de jogos que, individualmente, têm valor esperado \(0\). Esse fato é contra-intuitivo
Considere uma sequência infinita de jogos, onde no \(n\)-ésimo jogo se perde \(2^{n}\) dólares com probabilidade \(\frac{1}{2^{n}+1}\) e se ganha um dólar com probabilidade \(\frac{2^{n}}{2^{n}+1}\). Logo pode-se perder uma grande quantia de dinheiro ás vezes, e ganhar um pouco de dinheiro a maior parte do tempo. Podemos ver que a esperança de qualquer jogo individual é
Aqui é onde o Lema de Borel-Cantelli torna as coisas interessantes. Seja \(E_n\) o evento de perder no \(n\)-ésimo jogo.
Temos que
e, consequentemente, é finita.
Como a soma das probabilidades é finita, pelo Lema de Borel-Cantelli. temos que com probabilidade \(1\) a pessoa só perderá um número finito de vezes. Portanto, a quantidade de dinheiro ganha pelo jogador vai para o infinito, já que ele ganha infinitas vezes e perde apenas um número finito de vezes!
Considere um processo aleatório em \(\mathbb {Z}\) onde uma partícula inicia em \(x=0\) e a cada instante \(n\) salta uma unidade para a direita com probabilidade \(p\in (0,1)\) ou uma unidade para a esquerda com probabilidade \(1-p .\) Denote por \(S_n\in \mathbb {Z}\) a posição da partícula no instante \(n\geq 0 .\)
O processo \(S_n\) é conhecido na literatura como passeio aleatório simples, e no caso em que \(p\neq 1/2\), dizemos que o passeio é assimétrico.
Sejam \(Y_1,Y_2,\ldots \) incrementos independentes, com \(\P (Y_k=1)=p\) e \(\P (Y_k=-1)=1-p\). Definimos \(S_0=0\) e \(S_n=Y_1+\cdots +Y_n\).
Assim para cada \(n\geq 1\)
enquanto
como gostaríamos.
Estamos interessados agora em estudar o retorno de tal processo à origem do espaço. Mais especificamente, queremos saber com que frequência o processo retorna para o ponto onde começou o passeio. Em outras palavras, estamos interessados na sequência de eventos \(\{ S_n=0\} :=\{ \omega :S_n(\omega )=0\} .\)
Para que tenhamos \(S_n=0\) é necessário que o total de passos para a direita até o instante \(n\) seja igual ao total de passos para a esquerda. Com isso concluímos, antes de mais nada, que \(n\) deve ser par.
Fica como exercício para o leitor justificar agora que
Usando a fórmula de Stirling, 2 encontramos que
Note agora que se \(p\neq 1/2\) então \(r:= 4p(1-p)\lt 1\) e portanto
pois, para \(n\) suficientemente grande, esses termos são limitados por uma série geométrica de razão estritamente menor que 1.
E portanto \(\P (S_{2n}=0 \text{ i.v.})=0\), mostrando que eventualmente o processo visita a origem do espaço uma última vez, para nunca mais retornar.
Considere o exemplo de infinitos lançamentos independentes de uma moeda não-viciada.
Intuitivamente, esperamos que o total de caras observados, assim como o total de coroas, sejam infinitos. Para mostrar isso, tome o evento
Já sabemos que os eventos \(A_n, n\geq 1\) são independentes e que \(\P (A_n)=1/2 .\) Segue então que
e pelo Lema de Borel-Cantelli, \(\P (A_n \text{ i.v.})=1 .\) Ou seja, observaremos infinitas caras com probabilidade 1.
De modo análogo podemos mostrar que \(\P (A_n^c \text{ i.v.})=1 .\)
O teorema do macaco infinito afirma que um macaco pressionando teclas aleatoriamente em uma máquina de escrever por uma quantidade infinita de tempo quase certamente digitará qualquer texto dado, incluindo as obras completas de William Shakespeare. Na verdade, o macaco quase certamente digitaria qualquer texto finito possível um número infinito de vezes.
Sol Considere uma sequência infinita de caracteres produzida a partir de um alfabeto finito de \( n \) letras, onde cada letra é escolhida de forma independente e uniformemente distribuída. Seja \( S \) uma cadeia fixa de comprimento \( m \) pertencente ao mesmo alfabeto. Defina \( E_k \) como o evento em que a substring de comprimento \( m \) que começa na posição \( k \) é exatamente a cadeia \( S \). Então, com probabilidade 1, ocorrerão infinitos eventos \( E_k \) ao longo da sequência.
A probabilidade de que a substring iniciando na posição \( k \) seja exatamente \( S \) é:
pois cada uma das \( m \) posições deve corresponder à letra específica de \( S \).
Os eventos \( E_k \) são independentes porque a escolha de cada letra na sequência é feita de forma independente. Para aplicar o Segundo Lema de Borel-Cantelli, consideremos os eventos \( E_{mj+1} \) para \( j = 0, 1, 2, \ldots \). Esses eventos são independentes entre si, já que estão separados por \( m \) posições e não compartilham letras em comum.
Calculamos a soma das probabilidades desses eventos:
pois estamos somando infinitas vezes um valor positivo constante.
Pelo Segundo Lema de Borel-Cantelli, se a soma das probabilidades de eventos independentes diverge, então a probabilidade de que ocorram infinitamente muitos desses eventos é 1.
Isso implica que ocorrerão infinitos eventos \( E_{mj+1} \) com probabilidade 1. Como os eventos \( E_k \) incluem todos os \( E_{mj+1} \), concluímos que infinitos \( E_k \) ocorrerão quase certamente.
9.4 Convergência quase certa e Lei Forte dos Grandes Números
Na convergência em probabilidade, o conjunto de realizações com erro grande pode mudar com \(n\). A convergência quase certa impõe uma condição sobre cada trajetória, fora de um conjunto de probabilidade zero: a sequência deve convergir para o limite ao longo dessa realização.
Em outras palavras, o conjunto de resultados para os quais a sequência \((X_n)\) não converge para \(X\) tem probabilidade zero.
Esse tipo de convergência é mais forte do que a convergência em probabilidade. Enquanto a convergência em probabilidade exige que a probabilidade de \(|X_n - X| \gt \varepsilon \) tenda a zero para qualquer \(\varepsilon \gt 0\), a convergência quase certa implica que, para quase todos os resultados possíveis, a sequência efetivamente converge ponto a ponto.
A convergência quase certa implica convergência em probabilidade.
Se, para todo \(m=1,2,\ldots \),
\[ \sum _{n=1}^\infty \P \left(|X_n-X|\gt \frac1m\right)\lt \infty , \]então \( X_n \xrightarrow {\text{q.c.}} X \).
Reciprocamente, para um \(\epsilon \gt 0\), se
\[ \sum _{n=1}^\infty \P (A_n(\epsilon )) = \sum _{n=1}^\infty \P (|X_n - X| \gt \epsilon ) = \infty , \]e os eventos \(A_n(\epsilon )\) forem independentes, então esses desvios ocorrem infinitas vezes com probabilidade 1. Logo \(X_n\) não converge quase certamente para \(X\).
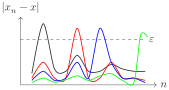
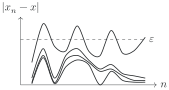
Na Fig. 9.1, plotamos a diferença \(|x_n - x|\) como uma função de \(n\), onde, para simplicidade, as sequências são representadas como curvas. Cada curva representa, assim, uma sequência particular \(|x_n(t) - x(t)|\). A convergência em probabilidade significa que, para um \(n \gt n_0\) específico, apenas uma pequena porcentagem dessas curvas terá ordenadas que excedem \(\varepsilon \) (Fig 9.1a). É claro que é possível que nem uma dessas curvas permaneça menor que \(\varepsilon \) para cada \(n \gt n_0\). A convergência quase certamente, por outro lado, exige que quase todas as curvas estejam abaixo de \(\varepsilon \) para todo \(n \gt n_0\) (Fig. 9.1b).
Considere \( X_1, X_2, \ldots \) variáveis aleatória independentes e identicamente distribuídas com esperança finita \( \mu .\) Seja \( S_n: = X_1 + \cdots + X_n .\) A Lei Fraca dos Grandes Números afirma que
Por outro lado, a Lei Forte dos Grandes Números que provaremos a seguir afirma que
Apresentaremos uma demonstração simples da Lei Forte dos Grandes Números sob o pressuposto de que o quarto momento é finito.
Primeiro assumimos que a esperança \( \mu = 0 .\)
De fato, fazendo \( X_k '= X_k - \mu \), temos
e assim o resultado geral segue do caso \(\mu =0 .\)
Lembrando, nosso objetivo agora é mostrar que para qualquer \( \varepsilon \gt 0 \),
Isso será feito a partir da desigualdade de Markov aplicada à quarta potência, usando o fato de que as variáveis \(X_k\) possuem quarto momento finito.
Para começar, calculemos primeiro o quarto momento de \( S_n .\)
Observe que se \( i, j\) são distintos, então, pela independência, \(\mathbb {E}\! \left[ X_i ^3 X_j\right] = \mathbb {E}\! \left[ X_i ^3\right] \mathbf{E}[ X_j] = 0\) (lembre que \(\mu =0\)) . Da mesma forma, temos \(\mathbb {E}\! \left[ X_i ^2 X_j\right] = 0\) e \(\mathbb {E}\! \left[ X_i X_j X_k X_\ell \right]= 0\), se \( i, j, k, \ell \) forem diferentes.
Desta forma os únicos termos que não são zero são da forma:
Agora uma contagem simples nos mostra que existem \(n\) termos da forma \(\mathbf{E}[X_k^4]\), e outros \(\binom {n} {2} \binom 42 = 3n (n-1)\) termos da forma \(\mathbb {E}\! \left[ X_j ^2 X_k ^2\right] .\)
Como as variáveis envolvidas são identicamente distribuídas, então
Assim, se \(C=\max \{ \mathbb {E}\! \left[ X_1 ^2 X_2 ^2\right], \mathbb {E}\! \left[ X_1 ^4\right]\} \), então
Pela desigualdade de Markov, temos então que
E como a série \(\displaystyle \sum _{n = 1} ^\infty \dfrac {3C} {\varepsilon ^4 n ^2}\) converge, segue do Lema de Borel-Cantelli que
E logo temos a convergência quase certa.
9.5 Convergência em distribuição e Teorema do Limite Central
As noções anteriores comparam variáveis definidas no mesmo espaço de probabilidade. Para estudar as flutuações de uma média, consideraremos agora sua distribuição após uma mudança de escala. A Lei dos Grandes Números afirma que \(\overline X_n-\mu \) tende a zero; multiplicar esse erro por \(\sqrt n\) permite investigar uma distribuição limite não trivial para as flutuações.
A convergência em distribuição expressa essa aproximação sem comparar as variáveis realização por realização. Estudamos se as funções de distribuição de \(X_n\) convergem para a função de distribuição de uma variável \(X\), no sentido que será definido a seguir.
O requisito de continuidade, mencionado na definição acima, se justifica para evitar algumas anomalias. Por exemplo, para \(n \geq 1\), seja \(X_n = \frac{1}{n}\) e \(X = 0\), para todo \(\Omega \). Parece aceitável que deveríamos ter convergência de \(X_n\) para \(X\), qualquer que fosse o modo de convergência. Observe que
e
Portanto, como \(\lim _{n \to \infty } F_n(0) = 0 \neq F(0) = 1\), não temos \(\lim _{n \to \infty } F_n(x) = F(x)\) para todo \(x \in \mathbb {R}\). Dessa forma, se houvesse a exigência de convergência em todos os pontos, não teríamos convergência em distribuição. Entretanto, note que para \(x \neq 0\), temos \(\lim _{n \to \infty } F_n(x) = F(x)\) e, como o ponto \(0\) não é de continuidade de \(F\), concluímos que \(X_n \xrightarrow {d} X\).
Muitas vezes, é mais fácil encontrar distribuições limite trabalhando com as funções geradoras de momentos. O Teorema 9.10 fornece a relação entre a convergência das funções de distribuição e a convergência das funções geradoras de momentos.
Sejam \(X_n\) e \(X\) variáveis aleatórias cujas funções geradoras de momentos \(M_n(t)\) e \(M(t)\) são finitas em um mesmo intervalo aberto ao redor de \(0\). Se
para todo \(t\) nesse intervalo, então \(X_n\) converge em distribuição para \(X\).
A prova do Teorema 9.10 está além do escopo deste texto.
Seja \(X_{n}\) uma variável aleatória binomial com \(n\) ensaios e probabilidade \(p\) de sucesso em cada ensaio. Se \(n\) tende ao infinito e \(p\) tende a zero com \(n p\) permanecendo fixo, mostre que \(X_{n}\) converge em distribuição para uma variável aleatória de Poisson.
Sol Resolveremos usando funções geradoras de momentos e o Teorema 9.10.
Sabemos que a função geradora de momentos de \(X_{n}\) - ou seja, \(\mathrm{M}_{n}(t)\) - é dada por
onde \(q=1-p\). Isso pode ser reescrito como
Fazendo \(n p=\lambda \) e substituindo em \(\mathrm{M}_{n}(t)\), obtemos
Agora, vamos tomar o limite dessa expressão conforme \(n\) tende ao infinito.
Finalmente fazendo \(k=\lambda \left(e^{t}-1\right)\), temos
Reconhecemos a expressão do lado direito como a função geradora de momentos para a variável aleatória de Poisson. Portanto, segue do Teorema 9.10 que \(X_{n}\) converge em distribuição para uma variável aleatória de Poisson.
No monitoramento da poluição, um experimentador coleta um pequeno volume de água e conta o número de bactérias na amostra. Diferentemente dos casos anteriores, aqui dispomos de apenas uma única observação. Para aproximar a distribuição de probabilidade das contagens, podemos considerar o volume como uma grandeza crescente, o que nos permite tratar situações em que a média do número de bactérias (a intensidade do processo) é elevada.
Seja \(X\) a variável aleatória que representa a contagem de bactérias por centímetro cúbico de água, supondo que \(X\) siga uma distribuição de Poisson com média \(\lambda \). Nosso objetivo é aproximar a distribuição de \(X\) quando \(\lambda \) é grande, mostrando que
converge em distribuição para uma variável aleatória normal padrão conforme \(\lambda \to \infty \).
Especificamente, suponha que a contagem máxima aceitável de bactérias por centímetro cúbico em um determinado suprimento de água seja 110, e que \(\lambda =100\). Queremos aproximar \(\P (X \leq 110)\).
Sol Consideramos inicialmente a função geradora de momentos de \(Y\) e estudamos seu comportamento à medida que \(\lambda \to \infty \), aplicando o Teorema 9.10. A função geradora de momentos de \(X\), denotada por \(\mathrm{M}_X(t)\), é
Desta forma, a função geradora de momentos de \(Y\) é
Expandindo \(e^{t/\sqrt{\lambda }}\), obtemos
Substituindo na função geradora de momentos de \(Y\):
À medida que \(\lambda \to \infty \), os termos após \(\frac{t^2}{2}\) tendem a zero, de modo que
a função geradora de momentos de uma variável aleatória normal padrão.
Dessa forma, para \(\lambda =100\):
onde \(110{,}5\) é a correção de continuidade. Assim, \(\P (X\leq 110)\approx 0{,}8531\).
O exemplo anterior apresenta uma aproximação normal. O Teorema do Limite Central estende esse fenômeno e complementa a Lei dos Grandes Números. Para uma amostra i.i.d. com média \(\mu \) e variância \(\sigma ^2\),
expressa a estabilização da média. Para descrever suas flutuações, ampliamos o erro pela escala \(\sqrt n\). O Teorema do Limite Central afirma que
tem distribuição aproximadamente normal padrão para \(n\) grande.
A Lei dos Grandes Números descreve onde a média se concentra; o Teorema do Limite Central descreve como ela flutua em torno desse valor. A escala do erro típico é \(1/\sqrt n\), o que permite aproximar probabilidades, avaliar o erro em métodos de Monte Carlo e construir intervalos de confiança.
Dizemos também que a média padronizada é assintoticamente normal. A versão abaixo é formulada para variáveis i.i.d. com variância finita; existem extensões para situações mais gerais.
Seja \(X_{1}, X_{2}\),... uma sequência de variáveis aleatórias independentes e identicamente distribuídas, cada uma com média \(\mu \) e variância \(\sigma ^{2}\). Então, a distribuição de
tende à distribuição normal padrão quando \(n \rightarrow \infty \). Isto é, para \(-\infty \lt a\lt \infty \),
Esboçamos a demonstração no caso em que a função geradora de momentos de \(X_1\) existe em uma vizinhança de \(0\). Defina
Então \(\mathbf{E}[Z_i]=0\) e \(\operatorname {Var}(Z_i)=1\). Se \(M_Z\) é a função geradora de momentos de \(Z_i\), sua expansão em torno de \(0\) fornece
Para
a independência implica
Logo,
que é a função geradora de momentos da normal padrão. Pelo Teorema 9.10, \(Y_n\) converge em distribuição para \(N(0,1)\).
Voltemos ao estimador de Monte Carlo do Exemplo 9.6. Se \(p=\pi /4\), então \(I_i\) é Bernoulli com variância \(p(1-p)\) e
A Lei dos Grandes Números garantiu que \(\widehat\pi _n\) converge para \(\pi \). O Teorema do Limite Central diz mais:
Portanto, para \(n\) grande, o erro de Monte Carlo é aproximadamente normal e tem desvio padrão
A escala \(n^{-1/2}\) tem uma consequência prática importante: para reduzir pela metade o erro típico, precisamos aproximadamente quadruplicar o número de simulações.
Um corolário do teorema anterior é:
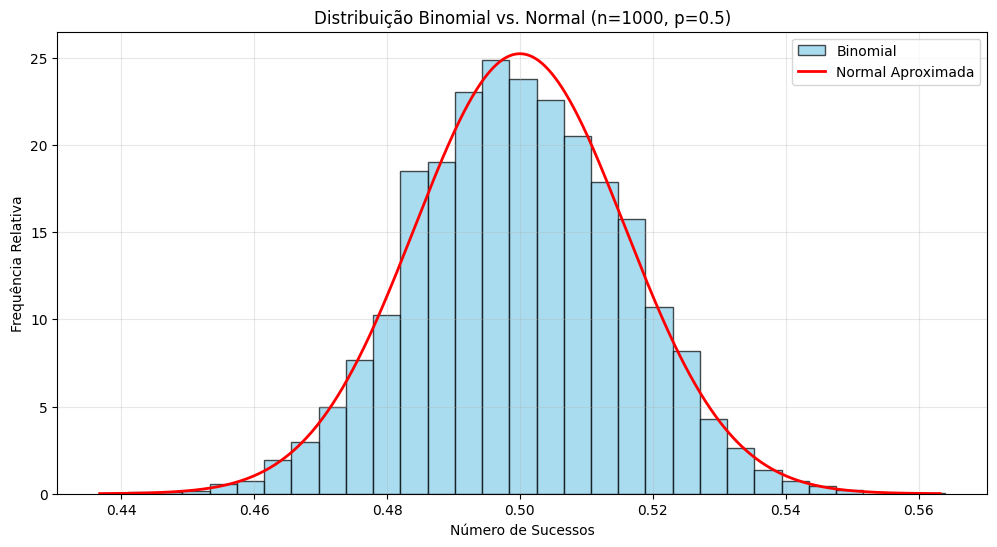
Considere a variável aleatória \( X_i \) que representa se um indivíduo selecionado aleatoriamente aprova (\( X_i = 1 \)) ou não aprova (\( X_i = 0 \)) o trabalho que o presidente está fazendo. Sabendo disso, calcule a probabilidade de que uma pesquisa eleitoral com \( n = 1000 \) pessoas encontre uma taxa de aprovação entre 45% e 55% dado que a aprovação do presidente é de 50
Sol A variável \(X=X_1+\cdots +X_{1000}\) é uma binomial de parâmetros 1000 e 0.5. Para resolver este problema, utilizamos a aproximação normal à distribuição binomial. Primeiro, calculamos a média e o desvio padrão da distribuição binomial:
Aplicando a correção de continuidade, consideramos o intervalo \(449{,}5 \leq X \leq 550{,}5\). A probabilidade desejada é então calculada através da função de distribuição cumulativa da normal padrão \( \Phi (z) \):
Calculando os valores de \( Z \):
A probabilidade é então:
Portanto, há aproximadamente 99,86% de probabilidade de que uma pesquisa eleitoral com 1000 pessoas encontre uma taxa de aprovação entre 45% e 55%.
Se 100 dados honestos são rolados, determine a probabilidade aproximada de que a soma obtida esteja entre \(300\) e \(400\), inclusive.
Sol
Suponha que \(X_{i}\) represente o valor do \(i\)-ésimo dado, \(i=1,2, \ldots , 100\). Já que
então
o Teorema do Limite Central resulta em
O número de atendimentos realizados por um centro de suporte psicológico em um dia é uma variável aleatória de Poisson com média 60. A coordenação do centro decidiu que, se o número de atendimentos exceder 70, será necessário alocar uma equipe extra para lidar com a demanda. Por outro lado, se esse número for menor ou igual a 70, a equipe padrão será suficiente para atender a todos os casos. Qual é a probabilidade de que a coordenação precise alocar uma equipe extra?
Sol A solução exata
não fornece diretamente uma resposta numérica. Entretanto, lembrando que uma variável aleatória de Poisson com média 60 é a soma de 60 variáveis aleatórias independentes, cada uma com média 1, podemos usar o Teorema do Limite Central para obter uma solução aproximada. Se \(X\) representa o número de atendimentos realizados no centro, temos
onde usamos o fato de que a variância de uma variável aleatória de Poisson é igual à sua média.
9.6 Intervalo de confiança
Os teoremas-limite permitem aproximar a distribuição de somas e médias a partir das hipóteses sobre as observações. Na inferência estatística, essas aproximações são usadas para estudar parâmetros desconhecidos: a amostra fornece estatísticas, como a média, que permitem estimá-los e quantificar a incerteza da estimação.
A Lei dos Grandes Números fornece a primeira garantia: o estimador se estabiliza no parâmetro. O Teorema do Limite Central acrescenta a escala e a forma aproximada do erro. Para a média amostral, por exemplo,
A primeira relação expressa a consistência; a segunda permite quantificar a incerteza para amostras grandes. Para representar essa incerteza, construiremos a partir da amostra um intervalo aleatório cuja probabilidade de conter o parâmetro fixo possa ser controlada.
Suponha que \(X_1,\ldots ,X_n\) seja uma amostra cuja distribuição depende de um parâmetro desconhecido \(\theta \). Um estimador é uma estatística
Antes de observar a amostra, \(\widehat\Theta \) é uma variável aleatória; depois de observar os dados, obtemos um valor numérico, a estimativa. Por exemplo, a média amostral \(\overline X\) é um estimador da média populacional.
Uma estimativa pontual não informa, sozinha, o tamanho de sua incerteza. Um intervalo de confiança é uma regra que usa a amostra para produzir limites aleatórios
O parâmetro \(\theta \) é fixo; o intervalo é que é aleatório. Dizemos que o procedimento tem nível de confiança pelo menos \(1-\alpha \) quando, para todo valor admissível de \(\theta \),
Essa probabilidade é chamada de probabilidade de cobertura. No caso normal com variância conhecida, estudado abaixo, ela será exatamente \(1-\alpha \).
Em um intervalo simétrico
o evento de cobertura é
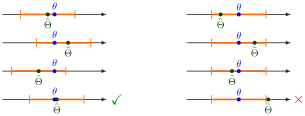
A figura enfatiza essa distinção: o parâmetro permanece fixo, enquanto os intervalos mudam de amostra para amostra.
Para construir um intervalo concreto, precisamos conhecer ou aproximar a distribuição do estimador. Começamos pelo caso em que a média amostral tem distribuição normal exata.
Intervalo de confiança para a média de uma população normal com variância conhecida
A seguir, obteremos o intervalo de confiança para a média de uma população normal com variância conhecida. O ponto de partida é o resultado
Usaremos a seguinte notação: dado o número \(\alpha \) entre 0 e \(1, z_{\alpha / 2}\) denota o número real que deixa uma probabilidade de \(\alpha / 2\) à sua direita em uma distribuição normal padrão, ou seja, \(z_{\alpha / 2}\) é o número real que resolve a equação: \(\P \left(Z\gt z_{\alpha / 2}\right)=\alpha / 2\), onde \(Z \sim N(0,1)\).
Considere a variável padronizada
Seja \(X \sim N(\mu ,\sigma ^{2})\). Então, a média amostral \(\overline{X}\) é tal que \(\overline{X} \sim N(\mu , \sigma ^{2}/n)\), o que implica
Portanto,
Multiplicando cada termo da desigualdade por \(\frac{\sigma }{\sqrt{n}}\), obtemos
Rearranjando em termos de \(\mu \), temos
Assim, o intervalo de confiança de nível \(100(1-\alpha )\% \) para \(\mu \) é
Por exemplo, se \(\alpha = 0,05\), então \(z_{\alpha /2} = z_{0,025} \approx 1,96\) e o intervalo de confiança de 95% é
Dado \(\left(\overline{X}-z_{\alpha / 2} \frac{\sigma }{\sqrt{n}}, \overline{X}+z_{\alpha / 2} \frac{\sigma }{\sqrt{n}}\right)\), em um intervalo de confiança de nível \(100(1-\alpha ) \% \) para a média populacional \(\mu \), a largura do intervalo é \(2 z_{\alpha / 2} \frac{\sigma }{\sqrt{n}}\) e metade dessa largura é denominada margem de erro, que é \(\epsilon =z_{\alpha / 2} \frac{\sigma }{\sqrt{n}}\).
Observe que:
quanto menor a largura do intervalo, mais informativo ele é.
os fatores que determinam a largura do intervalo são \(\sigma , n\) e nível de confiança
a largura do intervalo diminui à medida que \(n\) aumenta. Intuição: à medida que o número de observações aumenta, o intervalo se torna mais informativo.
a largura do intervalo aumenta com o nível de confiança: exigir maior probabilidade de cobertura aumenta o valor crítico e, portanto, alarga o intervalo.
O tempo (em minutos) que leva para consertar um dispositivo específico é uma variável aleatória com distribuição \(N\left(\mu , \sigma ^{2}\right)\), com \(\sigma =1,5\). Queremos obter um intervalo de confiança para \(\mu \) com nível de confiança de \(95 \% \) a partir de uma amostra com 25 observações de \(X\).
Sol Neste caso, temos que \(z_{0,025}=1,96\), então a expressão para o intervalo de confiança é:
Observe que, como \(\sigma \) é assumido como conhecido, a única informação da amostra necessária para obter este intervalo é \(\overline{X}\). Se \(\overline{X}=20\) minutos, o intervalo que obtemos é:
A largura deste intervalo é o dobro da margem de erro, que é \(2 \times 0,588=1,176\). Se quisermos obter o intervalo de confiança para \(\mu \) com um nível de confiança de \(99 \% \) com a mesma amostra, desde que \(z_{0,005}=2,58\), o intervalo que obtemos é:
Portanto, como a média da amostra é de 20 minutos, obtemos o seguinte intervalo de confiança:
A largura deste intervalo, \(2\times 0{,}773=1{,}546\), é maior do que no caso anterior; esse é o custo de aumentar o nível de confiança mantendo o mesmo tamanho de amostra.
Por fim, suponha que queremos fixar o nível de confiança em \(99 \% \) mas obtemos uma amostra de \(X\) com mais observações, por exemplo 100 observações. Neste caso, a expressão para o intervalo de confiança de nível \( 99 \% \) é:
Se a média da amostra também fosse de 20 minutos, o intervalo de confiança seria:
A largura deste intervalo é \(2 \times 0,387=0,774\); logicamente, este intervalo de nível \(99 \% \) construído com 100 observações tem uma largura menor (e, portanto, é mais informativo) do que o intervalo de nível \(99 \% \) construído com 25 observações.
Intervalo de confiança para uma proporção
Considere variáveis independentes \(X_1,\ldots ,X_n\sim \operatorname {Bernoulli}(p)\), com \(0\lt p\lt 1\), e seja
Então
Pelo Teorema do Limite Central,
Como \(\widehat p\to p\) em probabilidade, o erro-padrão estimado
é assintoticamente equivalente ao erro-padrão verdadeiro. Substituí-lo produz o intervalo de Wald. A aproximação pode ser ruim em amostras pequenas ou quando \(p\) está muito perto de \(0\) ou \(1\).
Pelo Teorema do Limite Central,
Além disso, \(\widehat p\to p\) em probabilidade, de modo que
Pelo teorema de Slutsky, substituir o erro-padrão verdadeiro pelo estimado não altera o limite normal. Portanto, a probabilidade de cobertura do intervalo acima converge para \(1-\alpha \).
A largura desse intervalo é
e a metade dessa largura, conhecida como margem de erro, é
De uma amostra aleatória de 100 estudantes em uma universidade, 82 afirmaram participar de atividades extracurriculares. Com base nisso, construa o intervalo de Wald de nível nominal 99% para \(p\), a proporção de todos os estudantes na universidade que participam de atividades extracurriculares.
Sol Para calcular o intervalo de confiança de 99%, primeiro identificamos os parâmetros necessários:
Nível de significância: \(\alpha = 1 - 0{,}99 = 0{,}01\).
Valor crítico: \(z_{\alpha /2} = z_{0{,}005} = 2{,}576\) (obtido da tabela da distribuição normal padrão).
A estimativa pontual da proporção é:
O erro-padrão estimado da proporção amostral é:
A margem de erro é:
Portanto, o intervalo de Wald de nível nominal \(99\% \) para \(p\) é:
Em termos percentuais, entre \(72,1\% \) e \(91,9\% \).
A margem de erro do intervalo aproximado acima é
onde \(\hat{p}\) é a proporção da amostra que possui a característica. Como \(\hat p(1-\hat p)\leq 1/4\), obtemos o limite conservador
O limite precedente pode ser usado para escolher o tamanho da amostra de modo que a meia-largura do intervalo de Wald não ultrapasse um valor fixado \(b\), qualquer que seja o valor observado de \(\widehat p\). Para isso, basta escolher \(n\) de modo que
será suficiente. Ou seja, \(n\) deve ser escolhido de forma que
Ao elevar ambos os lados ao quadrado, vemos que \(n\) deve ser tal que
Qual tamanho de amostra é suficiente para que a meia-largura conservadora do intervalo de Wald de nível nominal 95% não ultrapasse 2%?
Sol Precisamos escolher \(n\) de modo que o limite conservador para a margem de erro seja no máximo \(0,02\); isto é,
Como \(z_{0{,}025}=1{,}96\), isso resulta em
Ou seja, \(n=2401\) é suficiente para que a meia-largura conservadora do intervalo de Wald de nível nominal \(95\% \) seja, no máximo, \(2\% \). Isso não transforma a cobertura assintótica do método de Wald em uma garantia exata de \(95\% \) para amostras finitas.
Duas conexões antes de encerrar
O Teorema 9.6 foi usado acima para manipular limites em probabilidade. Vale registrar sua demonstração, porque ela depende apenas de duas ideias que reaparecem muitas vezes: desigualdade triangular e união de eventos.
Para a soma, fixe \(\varepsilon \gt 0\). Pela desigualdade triangular,
Logo,
e o lado direito tende a zero.
Para o produto,
Os dois últimos termos convergem em probabilidade para zero. Para o primeiro, se \(\delta \gt 0\),
que também tende a zero. Outra aplicação da desigualdade triangular conclui que \(X_nY_n\to \mu _1\mu _2\) em probabilidade.
9.7 Exemplos integradores
Os resultados assintóticos ficam mais concretos quando uma mesma quantidade pode ser interpretada tanto como média de muitas observacaoervações quanto como aproximação numérica de um objeto determinístico.
Considere uma função \(g:[0,1]\to \mathbb R\) com segundo momento finito e a integral
Se \(U_1,U_2,\ldots \) são independentes e uniformes em \((0,1)\), então
Isso sugere o estimador
Pela Lei dos Grandes Números,
e, se
então
O Teorema do Limite Central fornece ainda
Por exemplo, podemos estimar
que não possui primitiva elementar, gerando uniformes e calculando a média de \(e^{-U_i^2}\). O método troca uma integral por uma média aleatória: a Lei dos Grandes Números explica a convergência e o TLC quantifica a escala do erro.
Como o erro típico decai como \(n^{-1/2}\), reduzi-lo por um fator \(10\) exige aproximadamente \(100\) vezes mais amostras. A taxa é lenta, mas não se deteriora diretamente com a dimensão, uma das razões para a utilidade de Monte Carlo em problemas de dimensão alta.
9.8 Exercícios