Vetores aleatórios
6.1 Vetores aleatórios e funções de distribuição
Até aqui, uma variável aleatória foi suficiente para registrar a quantidade de interesse: o tempo de vida de uma bateria, o número de chamadas recebidas ou a distância percorrida. Muitos experimentos, porém, produzem várias quantidades simultaneamente. Se escolhemos ao acaso um ponto no disco unitário, por exemplo, suas duas coordenadas precisam ser estudadas em conjunto. Se \(\omega \) é o resultado do experimento, o ponto observado é
Estudar apenas \(X\) e apenas \(Y\) não descreve a maneira como essas variáveis variam em conjunto. Duas coordenadas podem ter marginais simples e, ainda assim, apresentar forte dependência. A informação conjunta é necessária, por exemplo, ao relacionar tempo de espera e duração do atendimento, volume de vendas e lucro ou duas medições do mesmo indivíduo.
Um vetor aleatório é uma coleção ordenada de variáveis aleatórias observadas no mesmo experimento. Neste capítulo, começaremos pela distribuição conjunta, passaremos aos casos discreto e contínuo e, em seguida, estudaremos independência, somas e distribuições condicionais. Em cada etapa, a ideia central será a mesma: calcular probabilidades em regiões do espaço dos valores possíveis.
Um vetor \(X=(X_1,\ldots ,X_n)\), cujas componentes são variáveis aleatórias definidas no mesmo espaço de probabilidade, é denominado vetor aleatório.
A função de distribuição conjunta de \(X=(X_1,\ldots ,X_n)\) é
\[ F_X(x_1,\ldots ,x_n) =\P (X_1\leq x_1,\ldots ,X_n\leq x_n), \qquad (x_1,\ldots ,x_n)\in \mathbb {R}^n. \]
A função de distribuição \(F\) de um vetor aleatório \(\left(X,Y\right)\) possui as seguintes propriedades:
\(F\left(x,y\right)\) é não-decrescente em cada uma das variáveis. Por exemplo, é não-decrescente em \(x\) : se \(x_1\leq x_2\), então
\[ F\left(x_1, y\right) \leq F\left(x_{2}, y\right) . \]\(F\left(x,y\right)\) é contínua à direita em cada uma das variáveis. Ou seja, para quaisquer \(x, y\):
\[ \lim _{u \to x^+} F(u, y) = F(x, y) \]e
\[ \lim _{v \to y^+} F(x, v) = F(x, y) \]Para cada \(y\) fixado, \(\lim _{x\to -\infty }F(x,y)=0\), e, para cada \(x\) fixado, \(\lim _{y\to -\infty }F(x,y)=0\). Além disso,
\[ \lim _{x\to \infty }\lim _{y\to \infty }F(x,y)=1. \]Todo retângulo semiaberto tem incremento não negativo: se \(a_1\lt a_2\) e \(b_1\lt b_2\), então
\[ F(a_2,b_2)-F(a_1,b_2)-F(a_2,b_1)+F(a_1,b_1)\geq 0. \]
As propriedades F1 e F2 seguem, como no caso unidimensional, da inclusão de eventos e da continuidade da probabilidade. Para F3, se \(x_m\downarrow -\infty \), então \([X\leq x_m,Y\leq y]\downarrow \varnothing \); portanto, \(F(x_m,y)\to 0\). O mesmo argumento vale na segunda coordenada. Se \(x_m\uparrow \infty \) e \(y_m\uparrow \infty \), então \([X\leq x_m,Y\leq y_m]\uparrow \Omega \), e daí \(F(x_m,y_m)\to 1\).
Por fim, o incremento em F4 é exatamente
e, portanto, é não negativo.
Para recuperar a distribuição de uma única componente, fazemos as demais coordenadas tenderem a \(+\infty \). No caso bidimensional,
Essas são as distribuições marginais. Elas descrevem cada coordenada separadamente, mas não determinam, em geral, como \(X\) e \(Y\) se relacionam.
A distribuição conjunta, por sua vez, determina probabilidades de regiões. Por exemplo,
A equação anterior é um caso especial da equação a seguir:
sempre que \(a_1\lt a_2, b_1\lt b_2\). Geometricamente, a fórmula soma o retângulo até \((a_2,b_2)\), retira as duas faixas excedentes e devolve a região retirada duas vezes. Esse princípio de inclusão e exclusão reaparecerá tanto nas tabelas do caso discreto quanto nas integrais do caso contínuo.
Nos casos discretos e absolutamente contínuos, a distribuição conjunta admite descrições semelhantes às de uma variável: massas atribuídas a pontos ou uma densidade cuja integral fornece probabilidades de regiões. Estudaremos essas duas situações separadamente.
6.2 Vetores aleatórios discretos
No caso discreto, a distribuição conjunta pode ser representada por uma tabela: cada célula contém \(p(x,y)=\P (X=x,Y=y)\), e as marginais são obtidas somando linhas ou colunas. Uma função de probabilidade conjunta deve satisfazer
com soma sobre o suporte, finito ou enumerável. Reciprocamente, qualquer tabela não negativa com soma total igual a \(1\) define uma distribuição conjunta.
A função de distribuição é recuperada acumulando as massas:
Se o vetor assume valores em um conjunto enumerável, cada coordenada assume valores na projeção desse conjunto e, portanto, é discreta. Reciprocamente, se cada \(X_i\) assume valores em um conjunto enumerável \(C_i\), então o vetor assume valores no produto \(C_1\times \cdots \times C_n\), que também é enumerável.
Para obter a função de probabilidade marginal de \(X\), basta somar \(p(x,y)\) sobre todos os valores possíveis de \(y\), resultando em:
Analogamente, a função de probabilidade marginal de \(Y\) é dada pela soma de \(p(x,y)\) sobre todos os valores possíveis de \(x\):
Uma caixa contém cinco lâmpadas, duas delas defeituosas. As lâmpadas são testadas em ordem aleatória, sem reposição. Seja \(X\) a posição em que aparece a primeira defeituosa e \(Y\) a posição da segunda. Então \(1\leq X\lt Y\leq 5\).
Há apenas \(\binom {5}{2}=10\) pares possíveis de posições para as duas lâmpadas defeituosas, todos equiprováveis. Por isso, cada par \((x,y)\) com \(1\leq x\lt y\leq 5\) tem probabilidade \(1/10\). A tabela conjunta é:
Probabilidades de eventos são somas de células. Por exemplo, \(\P (X\gt 2)=3/10\). As marginais surgem somando as colunas e as linhas. Para \(X\):
De modo análogo, para \(Y\):
Duas canetas esferográficas são selecionadas aleatoriamente de uma caixa que contém 3 canetas azuis, 2 canetas vermelhas e 3 canetas verdes. Se \( X \) é o número de canetas azuis selecionadas e \( Y \) é o número de canetas vermelhas selecionadas, encontre
a função de probabilidade conjunta \( p(x, y) \),
\( \P [(X, Y) \in A] \), onde \( A \) é a região \(\{ (x, y) | x + y \leq 1\} \).
Sol Os pares possíveis de valores \((x, y)\) são \((0,0), (0,1), (1,0), (1,1), (0,2)\) e \((2,0)\).
1. Por exemplo, \(p(0,1)\) corresponde à escolha de uma caneta vermelha e uma verde. Entre as \(\binom {8}{2}=28\) duplas equiprováveis, há \(\binom {2}{1}\binom {3}{1}=6\) desse tipo; logo \(p(0,1)=3/14\). O mesmo raciocínio fornece as demais células da tabela, cuja soma total é \(1\).
2. A probabilidade de que \((X, Y)\) pertença à região \( A \) é
| \(p(x,y)\) | \(x = 0\) | \(x = 1\) | \(x = 2\) | Totais |
|---|---|---|---|---|
| \(y = 0\) | \( \frac{3}{28} \) | \( \frac{9}{28} \) | \( \frac{3}{28} \) | \(\frac{15}{28}\) |
| \(y = 1\) | \( \frac{3}{14} \) | \( \frac{3}{14} \) | \( 0 \) | \(\frac{3}{7}\) |
| \(y = 2\) | \( \frac{1}{28} \) | \( 0 \) | \( 0 \) | \(\frac{1}{28}\) |
| Totais | \( \frac{5}{14} \) | \( \frac{15}{28} \) | \( \frac{3}{28} \) | \(1\) |
Suponha que realizamos sucessivos lançamentos de uma moeda com probabilidade \(p\) de cair cara. Defina as variáveis aleatórias \(X_1\) como o número do lançamento em que ocorre a primeira cara, e \(X_2\) como o número do lançamento em que ocorre a segunda cara. O suporte da distribuição conjunta de \((X_1, X_2)\) não é finito, pois \(X_1\) e \(X_2\) podem assumir valores arbitrariamente grandes, desde que \(1 \leq X_1 \leq X_2 - 1\).
Para \(x_2 \ge x_1 + 1\) e \(x_1 \ge 1\), podemos recorrer às propriedades da distribuição geométrica para determinar que
O primeiro termo representa a probabilidade de ser necessário \(x_1\) lançamentos para obter a primeira cara, e o segundo termo corresponde à probabilidade de que sejam necessários \(x_2 - x_1\) lançamentos adicionais para aparecer a segunda cara. Essas probabilidades multiplicam-se em razão da independência dos lançamentos. Simplificando, obtemos
A normalização também pode ser verificada diretamente. Escrevendo \(q=1-p\),
Retomando o Exemplo 6.4, já identificamos que a distribuição marginal de \(X_1\) deve ser geométrica com parâmetro \(p\). Para confirmar essa afirmação de outra forma, podemos recorrer à fórmula da distribuição marginal. No caso em questão, a função de probabilidade marginal de \(X_1\) é dada por:
Essa soma é uma série geométrica de razão \( (1 - p) \) e primeiro termo \( p^2 (1 - p)^{x_1 - 1} \), cuja soma é dada por:
Isso mostra que \(X_1\) segue uma distribuição geométrica com parâmetro \( p \).
A função de probabilidade marginal de \(X_2\) é obtida somando sobre \(x_1\):
Substituindo a função de probabilidade conjunta:
O termo \( p^2 (1 - p)^{x_2 - 2} \) não depende de \( x_1 \), então a soma simplesmente conta o número de termos, que é \( x_2 - 1 \):
Modelo multinomial
A binomial conta quantas vezes ocorre um resultado em ensaios com duas categorias. Com \(m\) categorias, as contagens devem ser estudadas em conjunto. Se, em cada um de \(n\) ensaios independentes, a categoria \(i\) ocorre com probabilidade \(p_i\), \(i=1,\ldots ,m\), e \(\sum _i p_i=1\), então o vetor \(X=(X_1,\ldots ,X_m)\) das contagens tem distribuição multinomial:
6.3 Vetores aleatórios contínuos
No caso contínuo, as somas sobre pontos são substituídas por integrais sobre regiões. Antes de integrar, identificamos o suporte da densidade e a parte desse suporte correspondente ao evento de interesse. Essa descrição determina a região de integração.
No caso bidimensional, dizemos que \((X,Y)\) é contínuo quando existe uma função não negativa \(f\), com integral total igual a \(1\), tal que, para toda região \(C\) considerada,
Se \(A\) e \(B\) são quaisquer conjuntos de números reais, então, para o conjunto
obtemos da Equação 6.2 que
Interpretação da densidade
Da função de distribuição conjunta,
obtemos, nos pontos em que as derivadas existem,
O valor \(f(a,b)\) não é uma probabilidade pontual. Ele indica como a probabilidade se concentra nas proximidades de \((a,b)\). Para pequenos \(\Delta a,\Delta b\gt 0\),
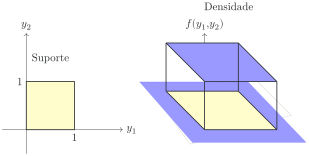
quando \(f\) é contínua em \((a,b)\). A aproximação corresponde ao volume de um paralelepípedo de base \(\Delta a\Delta b\) e altura \(f(a,b)\).
Marginais
Se \( X \) e \( Y \) são variáveis aleatórias conjuntamente contínuas, então elas também são contínuas individualmente. As funções de densidade de probabilidade marginais de \( X \) e \( Y \) podem ser determinadas da seguinte forma:
onde
Similarmente, a função densidade de probabilidade de \(Y\) é dada por
A distribuição uniforme no quadrado unitário é o exemplo bidimensional mais simples. Se \((X,Y)\) é uniforme em \((0,1)^2\), a densidade é constante no quadrado e zero fora dele. Como a área do suporte é \(1\), a constante também deve ser \(1\):
A Figura 6.3 mostra o suporte e a superfície da densidade. Como a altura é \(1\), probabilidades são simplesmente áreas. Assim, a região \(Y\gt 1/2\) ocupa metade do quadrado e tem probabilidade \(1/2\).
Para calcular \(\P (X+2Y\gt 2)\), identificamos no quadrado a região acima da reta \(x+2y=2\), mostrada na Figura 6.2.
O triângulo sombreado tem área \(1/4\); portanto \(\P (X+2Y\gt 2)=1/4\).
A função densidade conjunta de \(X\) e \(Y\) é dada por
Calcule
\(\P (X\gt 1, Y\lt 1)\)
\(\P (X\lt Y)\)
\(\P (X\lt a)\).
Sol
1
2
3
Em um processo de fabricação de chips de computadores, pode haver dois tipos de impurezas que afetam a qualidade do produto final. Para um certo lote de chips, seja \( X \) a proporção total de impurezas encontradas no lote, e seja \( Y \) a proporção das impurezas do tipo 1 em relação ao total de impurezas presentes. Suponha que, após analisar diversos lotes, a distribuição conjunta de \( X \) e \( Y \) possa ser adequadamente modelada pela função de densidade:
Sol
Desejamos calcular a probabilidade de que a proporção total de impurezas \( X \) seja inferior a 0,5 e que a proporção de impurezas do tipo 1, \( Y \), esteja entre 0,4 e 0,7.
Portanto, a probabilidade de que \( X \) seja menor que 0,5 e \( Y \) esteja entre 0,4 e 0,7 é 0,225.
Considere um círculo de raio \(R\) e suponha que um ponto em seu interior seja escolhido aleatoriamente e uniformemente distribuído no interior do círculo. Se o centro do círculo está na origem do sistema de coordenadas, e \(X\) e \(Y\) correspondem às coordenadas do ponto escolhido, então, como \((X, Y)\) tem a mesma probabilidade de estar na vizinhança de qualquer ponto no círculo, a função densidade conjunta de \(X\) e \(Y\) é dada pela uniforme:
para algum valor de K.
Determine \(K\).
Encontre as funções densidade marginais de \(X\) e \(Y\).
Calcule a probabilidade de que \(D\), a distância da origem ao ponto selecionado, seja menor ou igual a \(a\).
Determine \(\mathbf{E}[D]\), a esperança da distância \( D \).
Sol
Determinação de \( c \):
Para que \( f(x, y) \) seja uma função densidade de probabilidade, devemos ter:
\[ \int _{-\infty }^{\infty } \int _{-\infty }^{\infty } f(x, y) \, dy \, dx = 1. \]Assim, obtemos:
\[ K \iint _{x^2 + y^2 \leq R^2} dy \, dx = 1. \]Podemos calcular \( \iint _{x^2 + y^2 \leq R^2} dy \, dx \) usando coordenadas polares, ou mais diretamente, reconhecendo que essa integral representa a área do círculo de raio \( R \), que é \( \pi R^2 \). Portanto,
\[ K = \frac{1}{\pi R^2}. \]Funções densidade marginais de \( X \) e \( Y \):
Para encontrar a densidade marginal de \( X \), temos:
\[ \begin{aligned} f_X(x) & = \int _{-\infty }^{\infty } f(x, y) \, dy \\ & = \frac{1}{\pi R^2} \int _{x^2 + y^2 \leq R^2} dy \\ & = \frac{1}{\pi R^2} \int _{-\sqrt{R^2 - x^2}}^{\sqrt{R^2 - x^2}} dy \\ & = \frac{2}{\pi R^2} \sqrt{R^2 - x^2}, \quad \text{para } x^2 \leq R^2. \end{aligned} \]Para \( x^2 \gt R^2 \), temos \( f_X(x) = 0 \). Por simetria, a densidade marginal de \( Y \) é dada por:
\[ \begin{aligned} f_Y(y) & = \frac{2}{\pi R^2} \sqrt{R^2 - y^2}, \quad \text{para } y^2 \leq R^2, \\ & = 0, \quad \text{para } y^2 \gt R^2. \end{aligned} \]Probabilidade de que \( D \leq a \), onde \( D = \sqrt{X^2 + Y^2} \):
Para \(0\leq a\leq R\), a função de distribuição de \(D\) é:
\[ \begin{aligned} F_D(a) & = \P (\sqrt{X^2 + Y^2} \leq a) \\ & = \P (X^2 + Y^2 \leq a^2) \\ & = \iint _{x^2 + y^2 \leq a^2} f(x, y) \, dy \, dx \\ & = \frac{1}{\pi R^2} \iint _{x^2 + y^2 \leq a^2} dy \, dx \\ & = \frac{\pi a^2}{\pi R^2} \\ & = \frac{a^2}{R^2}, \end{aligned} \]Para \(a\lt 0\), \(F_D(a)=0\); para \(a\geq R\), \(F_D(a)=1\).
Esperança de \( D \), \( \mathbf{E}[D] \):
Do item anterior, temos que a densidade de \( D \) é:
\[ f_D(a) = \frac{2a}{R^2}, \quad 0 \leq a \leq R. \]Portanto,
\[ \mathbf{E}[D] = \frac{2}{R^2} \int _0^R a^2 \, da = \frac{2R}{3}. \]
6.4 Independência
As distribuições marginais não determinam, em geral, a distribuição conjunta. Sob a hipótese de independência, porém, a distribuição conjunta é obtida pelo produto das marginais. Essa hipótese expressa que observar uma coordenada não altera a distribuição da outra. A ausência de correlação, que será estudada adiante, não é suficiente para garantir independência. Formalmente, \(X\) e \(Y\) são independentes se, para quaisquer conjuntos borelianos \(A,B\subseteq \mathbb {R}\),
Em outras palavras, os eventos \([X\in A]\) e \([Y\in B]\) devem ser independentes para todas essas escolhas.
Os critérios mais úteis são fatorizações da distribuição conjunta. Eles permitem reconhecer independência sem voltar à definição para todos os conjuntos.
As variáveis \(X_1,\ldots ,X_n\) são independentes se, e somente se,
\[ F_{X_1,\ldots ,X_n}(x_1,\ldots ,x_n) =\prod _{i=1}^n F_{X_i}(x_i), \qquad (x_1,\ldots ,x_n)\in \mathbb {R}^n. \]Se \(X_1,\ldots ,X_n\) são discretas, elas são independentes se, e somente se,
\begin{align} p(x_1,\ldots ,x_n)=\prod _{i=1}^n p_{X_i}(x_i) \label{eq:inpdisc} \tag{6.7} \end{align}para todo \((x_1,\ldots ,x_n)\).
Suponha que \(X\) e \(Y\) tenham densidades conjunta e marginais contínuas. Então são independentes se, e somente se,
\[ f_{X,Y}(x,y)=f_X(x)f_Y(y),\qquad (x,y)\in \mathbb {R}^2. \]
Para 1, independência aplicada aos eventos \([X_i\leq x_i]\) fornece a fatorização da função de distribuição. Reciprocamente, se a função de distribuição fatora, diferenças sucessivas mostram que as probabilidades de retângulos semiabertos fatoram; como esses retângulos determinam a distribuição conjunta, segue a independência.
Para 2, no caso bidimensional, a independência aplicada aos eventos \([X=x]\) e \([Y=y]\) dá \(p(x,y)=p_X(x)p_Y(y)\). Na direção inversa, para quaisquer conjuntos \(A\) e \(B\),
O argumento em dimensão maior é o mesmo.
Para 3, se \(X\) e \(Y\) são independentes, então \(F_{X,Y}(x,y)=F_X(x)F_Y(y)\); derivando, obtemos \(f_{X,Y}(x,y)=f_X(x)f_Y(y)\). Reciprocamente, se as densidades fatoram,
e 1 conclui a prova.
Suponha que \( X \) e \( Y \) sejam variáveis aleatórias com a função de distribuição conjunta dada por
Para encontrar a função de distribuição marginal de \( X \), podemos considerar:
Isso indica que \( X \) segue uma distribuição exponencial com parâmetro \( 1 \). Um cálculo análogo mostra que \( Y \) também segue uma distribuição exponencial com o mesmo parâmetro.
Podemos verificar a independência das variáveis \( X \) e \( Y \) observando que:
o que confirma que \( X \) e \( Y \) são variáveis independentes.
Sejam \(n+m\) experimentos independentes, cada um com probabilidade de sucesso \(p\). Se \(X\) conta o número de sucessos nas primeiras \(n\) tentativas e \(Y\) nas últimas \(m\), então \(X\) e \(Y\) são variáveis aleatórias independentes. Isso ocorre porque o resultado das primeiras \(n\) tentativas não influencia o número de sucessos nas \(m\) tentativas restantes. De fato, para \(x\) e \(y\) inteiros,
Por outro lado, o número de sucessos nas primeiras \(n\) tentativas, \(X\), e o número total de sucessos, \(Z\) são dependentes.
No capítulo anterior vimos que, se \(N\sim \operatorname {Poisson}(\lambda )\) e cada ocorrência é classificada independentemente como detectada com probabilidade \(p\), o número \(X\) de detectadas é \(\operatorname {Poisson}(\lambda p)\). Seja \(Y=N-X\) o número de não detectadas. Além das marginais, o afinamento produz independência.
De fato, para \(i,j\geq 0\),
A última expressão é o produto das massas de \(\operatorname {Poisson}(\lambda p)\) e \(\operatorname {Poisson}(\lambda (1-p))\). Portanto, \(X\) e \(Y\) são independentes.
Suponha que \( X \) e \( Y \) sejam variáveis aleatórias com a seguinte função de distribuição conjunta:
Para determinar a função de distribuição marginal de \( X \), podemos calcular:
Assim, podemos concluir que \( X \) segue uma distribuição exponencial com parâmetro \( 1 \). Um cálculo semelhante revela que \( Y \) também segue uma distribuição exponencial com o mesmo parâmetro.
Além disso, podemos verificar que:
o que implica que \( X \) e \( Y \) são variáveis independentes.
Para ver a dependência geometricamente, considere \( X \) e \( Y \) como definidos no Exemplo 6.10. Para \( -R \lt x \lt R \) e \( -R \lt y \lt R \), temos:
o que não coincide com a densidade conjunta dessas variáveis e assim concluímos que \( X \) e \( Y \) são variáveis aleatórias dependentes.
Isso está de acordo com nossa intuição de dependência, pois, quando \( X \) está próximo de \( R \), \( Y \) deve estar próximo de zero. Assim, obter informações sobre \( X \) nos fornece informações sobre \( Y \).
Dois amigos planejam se encontrar na biblioteca dentro do intervalo de uma hora. Seus horários de chegada são independentes e distribuídos uniformemente ao longo do período de uma hora. Cada um concorda em esperar por 15 minutos, ou até o final da hora. Se o outro não aparecer nesse tempo, a pessoa parte. Qual é a probabilidade de os dois amigos se encontrarem?
Sol Se \(X_1\) denota o horário de chegada do primeiro amigo no intervalo (0,1), o período de uma hora, e se \(X_2\) denota o horário de chegada do segundo amigo, então \(\left(X_1, X_2\right)\) pode ser modelado como tendo uma distribuição uniforme bidimensional sobre o quadrado unitário; isto é,
O evento de os dois amigos se encontrarem depende do tempo \(Y\) entre suas chegadas, onde
Podemos resolver o problema encontrando primeiro a distribuição de \(Y\). Como
A Figura 6.5 mostra que a região quadrada sobre a qual \(\left(X_1, X_2\right)\) tem probabilidade positiva e a região definida por \(Y \leq y\). A probabilidade de \(Y \leq y\) pode ser encontrada integrando a função de densidade conjunta de \(\left(X_1, X_2\right)\) sobre a região de seis lados mostrada no centro da Figura 6.5. Isso pode ser simplificado integrando sobre os triângulos \(\left(A_1\right.\) e \(\left.A_2\right)\) e subtraindo de 1, como veremos agora.
Temos
O problema solicita a probabilidade de um encontro se cada amigo esperar até 15 minutos. Como 15 minutos é \(1/4\) de hora, isso pode ser encontrado avaliando
Há menos de 50% de chance de que os dois amigos se encontrem sob essa regra.
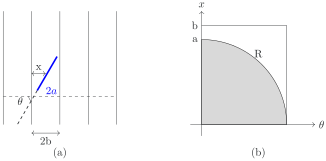
Uma agulha de comprimento \(2a\) é lançada ao acaso sobre um plano coberto por retas paralelas separadas por distância \(2b\), com \(a\lt b\). Seja \(X\) a distância do centro da agulha à reta mais próxima e \(\Theta \) o ângulo entre a agulha e a direção perpendicular às retas. Pelo modelo geométrico,
e tomamos \(X\) e \(\Theta \) independentes. Assim, no retângulo \(0\lt x\lt b\), \(0\lt \theta \lt \pi /2\), a densidade conjunta é constante:
A agulha cruza uma reta exatamente quando \(X\lt a\cos \Theta \). Portanto,
Se, em \(n\) lançamentos, ocorrerem \(n_\ell \) cruzamentos, a frequência relativa \(n_\ell /n\) sugere a aproximação
Dizemos que \((X,Y)\) tem distribuição normal bivariada com parâmetros \(\mu _1,\mu _2\), \(\sigma _1,\sigma _2\gt 0\) e \(-1\lt \rho \lt 1\) quando
A forma da densidade parece complicada, mas completar o quadrado revela sua estrutura. Escrevendo \(u=(x-\mu _1)/\sigma _1\) e \(v=(y-\mu _2)/\sigma _2\),
Por isso, para cada \(x\), a densidade pode ser vista como o produto da densidade \(N(\mu _1,\sigma _1^2)\) em \(x\) por uma densidade normal em \(y\) com média
e variância \((1-\rho ^2)\sigma _2^2\). Integrando em \(y\), obtemos \(X\sim N(\mu _1,\sigma _1^2)\); por simetria, \(Y\sim N(\mu _2,\sigma _2^2)\).
Quando \(\rho =0\), a densidade conjunta se reduz ao produto das duas marginais, e \(X\) e \(Y\) são independentes. Para \(\rho \neq 0\), a fatorização falha. Mais adiante, ao estudar correlação, veremos que o parâmetro \(\rho \) coincide com o coeficiente de correlação desse vetor.
6.5 Soma de variáveis aleatórias independentes
Somas aparecem ao acumular tempos, custos, contagens ou erros. Em geral, as distribuições de \(X\) e \(Y\) não determinam a de \(X+Y\), pois a dependência entre as parcelas também interfere. Quando \(X\) e \(Y\) são independentes, a distribuição da soma pode ser calculada a partir das marginais. No caso com densidade, o cálculo envolve as retas \(x+y=z\). Suponha inicialmente que \((X,Y)\) tenha densidade conjunta \(f_{X,Y}\). Então:
Para obter a densidade tomamos a derivada:
assim, concluímos que
Se as variáveis \(X\) e \(Y\) são independentes podemos reescrever 6.13 como
Com isso está provada a seguinte proposição.
Sejam \(X\) e \(Y\) variáveis aleatórias.
Se \(X\) e \(Y\) têm densidade conjunta \(f_{X,Y}(x, y)\), então
\[ f_{X+Y}(z)=\int _{-\infty }^{\infty } f_{X,Y}(z-t, t) d t=\int _{-\infty }^{\infty } f_{X,Y}(t, z-t) d t \]Se \(X\) e \(Y\) são independentes e possuem densidades \(f_{X}\) e \(f_{Y}\), então (por 1 \(\text{ e }\) a 3.) \(X+Y\) tem densidade
\[ f_{X+Y}(z)=\int _{-\infty }^{\infty } f_{X}(z-t) f_{Y}(t) d t=\int _{-\infty }^{\infty } f_{X}(t) f_{Y}(z-t) d t \]
O mesmo raciocínio fornece, para a diferença,
Se \(X\) e \(Y\) forem independentes, essa expressão é a convolução de \(f_X\) com a densidade de \(-Y\).
Soma de duas variáveis aleatórias uniformes independentes
A convolução já produz um exemplo geométrico importante: a soma de duas uniformes não é uniforme.
Se \(X\) e \(Y\) são variáveis aleatórias independentes, ambas uniformemente distribuídas em \((0,1)\), então a densidade de \(X+Y\) é
A densidade de \(X+Y\) toma valores diferentes de \(0\) em \((0,2).\)
Da Equação 6.14, como
obtemos
O intervalo de integração depende de \(a\): Para \(0 \leq a \leq 1\), temos que
Para \(1\lt a\lt 2\), obtemos
E assim
A variável aleatória \(U = X + Y\) tem distribuição triangular, nome que se refere ao formato de sua densidade, representado na Figura 6.7.
Variáveis aleatórias normais
A Equação 6.14 também permite demonstrar o resultado seguinte sobre somas de variáveis aleatórias normais.
Para começar, suponha que \(X\) e \(Y\) sejam variáveis aleatórias normais independentes, onde \(X\) possui média 0 e variância \(\sigma ^2\), enquanto \(Y\) possui média 0 e variância 1. Nosso objetivo é determinar a densidade de \(X + Y\) a partir da Equação \(\ref{eq:convb}\).
Primeiramente, observemos que
onde
A partir da Equação \(\ref{eq:convb}\) e completando quadrados, deduzimos que a densidade de \(X + Y\) em \(a\) é:
onde \(C\) não depende de \(a\). Conclui-se, portanto, que \(X + Y\) é normal com média 0 e variância \(\, 1 + \sigma ^2\).
Para passar ao caso geral, suponha que \(X_1\) e \(X_2\) sejam normais independentes com médias \(\mu _1\) e \(\mu _2\) e variâncias \(\sigma _1^2\) e \(\sigma _2^2\), respectivamente. Então,
A variável \(\tfrac {X_1 - \mu _1}{\sigma _2}\) é normal com média 0 e variância \(\tfrac {\sigma _1^2}{\sigma _2^2}\), enquanto \(\tfrac {X_2 - \mu _2}{\sigma _2}\) é normal com média 0 e variância 1. Com base no resultado anterior, a soma
é normal com média 0 e variância \(1 + \tfrac {\sigma _1^2}{\sigma _2^2}\). Dessa forma, \(X_1 + X_2\) é normal com média \(\mu _1 + \mu _2\) e variância
Assim, comprova-se a Proposição \(\ref{prop:somadenormais}\) para \(n = 2\). O caso geral segue por indução.
Um time de futebol jogará uma temporada com 40 partidas. Vinte e seis dessas partidas serão contra times da divisão \(\mathrm{A}\), e 14 contra times da divisão \(\mathrm{B}\). Suponha que o time ganhe cada partida disputada contra um adversário da divisão A com probabilidade 0,4, e ganhe cada partida disputada contra um adversário da divisão B com probabilidade 0,8. Suponha também que os resultados das diferentes partidas sejam independentes. Obtenha um valor aproximado para a probabilidade de que
o time vença 25 partidas ou mais;
o time vença mais partidas contra times da divisão A do que contra times da divisão \(B\).
Sol 1 Sejam \(X_{A}\) e \(X_{B}\) variáveis aleatórias que representam, respectivamente, o número de partidas que o time vence contra equipes da divisão A e B. \(X_{A}\) e \(X_{B}\) são binomiais independentes com
Pela aproximação normal para a distribuição binomial, \(X_{A}\) e \(X_{B}\) têm aproximadamente a mesma distribuição que teriam variáveis aleatórias normais independentes com os valores esperados e as variâncias acima. Portanto, pela Proposição 6.6, \(X_{A}+X_{B}\) terá aproximadamente uma distribuição normal com média \(\mu = 21,6\) e variância \(\sigma ^2 = 8,48\). Assim, fazendo com que \(Z\) represente uma variável aleatória normal padrão, temos: 1
onde \(\Phi \) é a função de distribuição da normal padrão.
2 Notamos que \(X_{A}-X_{B}\) tem aproximadamente uma distribuição normal com média \(\mu = -0,8\) e variância \(\sigma ^2 = 8,48\). Com isso,
Assim, há aproximadamente \(16,00\% \) de chances de que o time ganhe pelo menos 25 partidas, e aproximadamente \(32,74\% \) de chances de que o time ganhe mais partidas contra times da divisão \(A\) do que contra times da divisão \(B\).
Soma de variáveis aleatórias gama
Recordemos a definição da variável aleatória gama de parâmetros \((t,\lambda )\), cuja função densidade de probabilidade tem a forma:
onde \(\Gamma (t) = \int _0^{\infty } x^{t-1}e^{-x}dx\) é a função gama. Esta função é uma extensão do fatorial para os reais positivos; para um inteiro positivo \(n\), temos \(\Gamma (n+1) = n!\).
Utilizando a fórmula de convolução (Equação 6.14), obtemos:
onde \(K\) e \(C\) são constantes que não dependem de \(a\).
Como \(f_{X+Y}(a)\) é uma função densidade de probabilidade, sua integral em todo o domínio deve ser igual a 1, o que nos permite determinar o valor de \(C\). Consequentemente, temos:
Isto conclui a demonstração, mostrando que \(X+Y\) segue uma distribuição gama com parâmetros \((s+t, \lambda )\).
Pode-se demonstrar por indução, utilizando a Proposição 6.7, que para variáveis aleatórias gama \(X_i\), \(i = 1, \ldots , n\), com parâmetros respectivos \((t_i, \lambda )\), \(i = 1, \ldots , n\), a soma \(\sum _{i=1}^n X_i\) segue uma distribuição gama com parâmetros \((\sum _{i=1}^n t_i, \lambda )\). A prova formal deste resultado fica como exercício para o leitor.
Somas de variáveis aleatórias de Poisson independentes
Como o evento \([X+Y=n]\) pode ser expresso como a união dos eventos disjuntos \([X=k, Y=n-k]\), para \(0 \leq k \leq n\), temos:
Logo, \(X+Y\) segue uma distribuição de Poisson com parâmetro \(\lambda _{1}+\lambda _{2}\).
Somas de variáveis aleatórias binomiais independentes
Sejam \(X\) e \(Y\) variáveis aleatórias binomiais independentes com respectivos parâmetros \((n, p)\) e \((m, p)\). Então \(X+Y\) é binomial com parâmetros \((n+m, p)\).
A partir da interpretação de uma variável aleatória binomial, e sem necessidade de cálculos, podemos concluir diretamente que \(X+Y\) é binomial com parâmetros \((n+m, p)\). Isso se deve ao fato de que \(X\) representa o número de sucessos em \(n\) tentativas independentes, cada uma com probabilidade de sucesso \(p\), e \(Y\) representa o número de sucessos em \(m\) tentativas independentes, também com probabilidade de sucesso \(p\). Assim, pela independência de \(X\) e \(Y\), \(X+Y\) corresponde ao número de sucessos em um total de \(n+m\) tentativas independentes, cada uma com probabilidade \(p\) de sucesso. Portanto, \(X+Y\) é uma variável aleatória binomial com parâmetros \((n+m, p)\).
Para verificar essa conclusão analiticamente, note que
onde \(q=1-p\) e adotamos \(\binom {r}{j}=0\) quando \(j\lt 0\) ou \(j\gt r\). Assim,
e a conclusão segue da identidade combinatória:
6.6 Distribuição condicional
A distribuição conjunta contém a informação necessária para estudar como a distribuição de \(X\) se altera quando obtemos informação sobre \(Y\). A probabilidade condicional, apresentada para eventos em um capítulo anterior, será agora usada para definir distribuições condicionais de variáveis aleatórias. No caso discreto, fixamos um evento \(Y=y\) com probabilidade positiva e renormalizamos. No caso contínuo, \(\P (Y=y)=0\), portanto não dividimos por essa probabilidade. Condicionamos primeiro numa faixa \(y\lt Y\leq y+h\) e deixamos \(h\downarrow 0\). Sob as hipóteses usuais,
Sob essas hipóteses, o limite motiva a definição no caso contínuo. As fórmulas nos dois casos têm formas análogas:
Para cada valor admissível de \(y\), elas definem uma distribuição em \(x\).
Antes de fixar um valor, vale registrar a versão para uma faixa. Se \(\P (y_1\lt Y\leq y_2)\gt 0\), definimos
6.6.1 Variáveis aleatórias discretas
Se \(Y\) é discreta e \(\P (Y=y)\gt 0\), a definição usual de probabilidade condicional pode ser aplicada diretamente. Para qualquer \(X\),
A lei da probabilidade total recupera a distribuição marginal:
Se \(X\) também é discreta, podemos trabalhar diretamente com as massas pontuais.
Se \(X\) e \(Y\) são ambas variáveis aleatórias discretas
A função de probabilidade condicional de \(X\) dado \(Y=y\) é definida, para todo \(y\) com \(p_Y(y) \gt 0\), como
\[ \begin{aligned} p_{X \mid Y}(x \mid y) & \coloneqq \P ( X=x \mid Y=y ) \\ & =\frac{\P ( X=x, Y=y )}{\P ( Y=y )} \\ & =\frac{p(x, y)}{p_Y(y)} \end{aligned} \]para todos os valores de \(y\) tais que \(p_Y(y)\gt 0\).
a função de distribuição condicional de \(X\) dado \(Y=y\) é definida, para todo \(y\) com \(p_Y(y) \gt 0\), como
\[ \begin{aligned} F_{X \mid Y}(x \mid y) & \coloneqq \P ( X \leq x \mid Y=y ) \\ & =\sum _{a \leq x} p_{X \mid Y}(a \mid y) \end{aligned}. \]
Em outras palavras, essas definições são análogas ao caso incondicional de \(X\), mas agora tudo é condicionado no evento \(Y = y\). Se \(X\) for independente de \(Y\), então as funções de probabilidade e de distribuição condicionais coincidem com as respectivas funções incondicionais. Isso ocorre pois, nesse caso,
Se \(X\) e \(Y\) são variáveis aleatórias de Poisson independentes com respectivos parâmetros \(\lambda _1\) e \(\lambda _2\), calcule a distribuição condicional de \(X\) dado que \(X+Y=n\).
Sol
A função de probabilidade condicional de \(X\) dado \(X+Y=n\) é
onde a última igualdade é consequência da hipótese de independência de \(X\) e \(Y\). Na Proposição 6.8 mostramos que \(X+Y\) tem uma distribuição de Poisson com parâmetro \(\lambda _1+\lambda _2\), e assim temos
Logo a distribuição condicional de \(X\) dado que \(X+Y=n\) é uma binomial com parâmetros \(n\) e \(\lambda _1 /\left(\lambda _1+\lambda _2\right)\).
6.6.2 Variáveis aleatórias contínuas
Se \(Y\) é contínua, em geral \(\P (Y=y)=0\), de modo que não podemos dividir por essa probabilidade. Em vez disso, condicionamos em uma faixa estreita \(y\lt Y\leq y+\Delta y\). Para \(\Delta y\gt 0\),
Quando \(\Delta y\to 0\), numerador e denominador são, em primeira ordem, \(f_{XY}(x,y)\Delta y\) e \(f_Y(y)\Delta y\). Isso motiva a definição seguinte.
De modo análogo,
Se \(X\) e \(Y\) são independentes, \(f_{XY}(x,y)=f_X(x)f_Y(y)\), e portanto
Ou seja, condicionar não altera a distribuição quando as variáveis são independentes.
A função de distribuição condicional é obtida integrando a densidade condicional:
Como consequência, as seguintes fórmulas são válidas:
Dado
determine \(f_{X \mid Y}(x \mid y)\) e \(f_{Y \mid X}(y \mid x)\).
Sol
A densidade conjunta é constante na região triangular sombreada da Figura 6.8. Podemos determinar \(k\) lembrando que a densidade deve integrar \(1\):
E agora podemos calcular as marginais:
e
E assim
e
As variáveis \(X\) e \(Y\) têm densidade dada por
Calculemos a densidade condicional \(f_{X \mid Y}\). Inicialmente, calculamos a marginal de \(Y\). Temos
Então, para qualquer \(y\) fixado com \(0 \leq y \leq 1\),
Fora desse intervalo, \(f_{X \mid Y}(x \mid y)\) é zero.
A função de distribuição condicional pode ser obtida a partir da integração da densidade condicional. Assim, para qualquer \(y\) fixado com \(0 \leq y \leq 1\) e \(0 \leq x \leq 1\), vem:
e, portanto,
A função de distribuição conjunta pode ser obtida a partir da condicional, da seguinte forma:
Deixamos ao leitor a tarefa de verificar se essa expressão está correta, o que pode ser feito calculando seu valor diretamente pela densidade conjunta.
6.6.3 Variáveis aleatórias mistas
Também é possível combinar uma variável contínua e outra discreta. Se \(X\) tem densidade \(f_X\) e \(N\) é discreta, escrevemos \(p_{N\mid X}(n\mid x)\) para a probabilidade condicional de \(N=n\) quando o valor de \(X\) é \(x\). A forma mista da regra de Bayes é
A estrutura é a da fórmula de Bayes: verossimilhança \(\times \) densidade inicial, divididas pela constante de normalização.
Suponha que realizemos \(n+m\) tentativas de Bernoulli e observemos \(n\) sucessos e \(m\) fracassos. A probabilidade de sucesso é desconhecida. Para ilustrar o condicionamento misto, tratemos essa probabilidade como uma variável aleatória \(\Theta \in (0,1)\) e adotemos, por simplicidade, uma priori uniforme:
Essa é uma escolha de modelagem, não uma afirmação de ausência absoluta de informação.
Se \(N\) é o número de sucessos, então, dado \(\Theta =\theta \),
Logo, pela forma mista da regra de Bayes,
Normalizando,
portanto
A conta mostra por que a família beta é natural para modelar probabilidades de sucesso: depois de observar dados de Bernoulli, permanecemos na mesma família.
Considere \(X\in \{ 1,2,3\} \) discreta e \(Y\in [0,1]\) contínua. A lei conjunta é mista: para cada \(x\), o valor \(g(x,y)\, dy\) representa aproximadamente a probabilidade de \(X=x\) e \(Y\in [y,y+dy]\), onde
Integrando em \(y\), obtemos \(p_X(x)=1/3\) para \(x=1,2,3\). Somando em \(x\),
Se fixamos \(X=2\), a distribuição condicional de \(Y\) é contínua:
Por outro lado, se fixamos \(Y=1/2\), a distribuição condicional de \(X\) é discreta. Como \(f_Y(1/2)=11/12\),
Assim,
e
Esse exemplo mostra por que, em modelos mistos, é importante distinguir massa condicional de densidade condicional.
Distribuições conjuntas permitem responder três perguntas diferentes: como as coordenadas variam juntas, quando podem ser separadas por independência e como a informação sobre uma delas altera a distribuição da outra. Essas três ideias serão usadas repetidamente nos capítulos seguintes.
6.7 Exemplos integradores
Os modelos deste capítulo começam a ficar especialmente úteis quando o vetor aleatório não é apenas um par de números, mas registra a configuração inteira de um sistema. Os exemplos a seguir mostram três maneiras de explorar essa ideia: representar um objeto combinatório por indicadores, transformar contagens multinomiais em uma quantidade operacional e reconhecer dependência entre coordenadas que têm marginais simples.
Considere o grafo aleatório de Erdős–Rényi \(G(n,p)\). Para cada par \(e=\{ i,j\} \) de vértices, seja \(I_e\) a indicadora do evento “a aresta \(e\) está presente”. O vetor
é um vetor aleatório discreto com \(\binom n2\) coordenadas. Como as arestas são escolhidas independentemente,
Um objeto combinatório inteiro passa, assim, a ser uma única observacaoervação vetorial. Graus, número de arestas e número de triângulos são funções desse vetor; voltaremos a elas nos capítulos de transformações e esperança.
Suponha que \(n\) requisições sejam enviadas, independentemente e com a mesma probabilidade, para \(m\) servidores. Se \(N_j\) é o número de requisições que chegam ao servidor \(j\), então
tem distribuição multinomial com parâmetros \(n\) e \(p_1=\cdots =p_m=1/m\).
Uma pergunta natural é quantos servidores serão efetivamente utilizados. Defina
Como um servidor fica vazio somente quando nenhuma das \(n\) requisições o escolhe,
Logo,
A mesma conta descreve bolas lançadas em caixas, chaves distribuídas numa tabela de hash ou usuários distribuídos entre máquinas. O vetor multinomial guarda a carga completa; a função \(A\) extrai uma característica operacional do sistema.
6.8 Exercícios