Funções de variáveis aleatórias
Estudaremos agora transformações de vetores aleatórios. Dois casos receberão atenção: as mudanças de coordenadas e a ordenação das observações de uma amostra. Em ambos, procuramos determinar a distribuição das novas variáveis a partir da distribuição do vetor original.
Nas mudanças suaves de coordenadas, o jacobiano corrige a alteração de áreas provocada pela transformação. Na ordenação, usamos as propriedades de mínimos, máximos e posições intermediárias da amostra. Cada caso exige um método próprio, que será desenvolvido ao longo do capítulo.
7.1 Funções de variáveis aleatórias contínuas
Dadas duas variáveis aleatórias \(X\) e \(Y\), considere
Se \(f_{XY}\) é conhecida, a função de distribuição de \(Z\) é obtida integrando sobre a região em que \(g(x,y)\leq z\):
onde \(D_z=\{ (x,y):g(x,y)\leq z\} \). Depois de determinar \(F_Z\), derivamos para obter \(f_Z\), quando a derivada existe. O suporte merece atenção especial: ele determina os limites de integração e, muitas vezes, obriga a separar o cálculo em casos. O primeiro exemplo mostra o método em uma transformação unidimensional.
Se \( X \sim U[0,1] \), qual é a distribuição de \( Y = -\log (X) \)?
Sol Como
e \( \P (0 \lt X \lt 1) = 1 \), temos que \( F_Y(y) = 0 \) para \( y \leq 0 \). Se \( y \gt 0 \), então
Portanto, \( Y \sim \exp (1) \), ou seja, \( Y \) tem uma distribuição exponencial com parâmetro 1.
Dado \( Z = X - Y \), determine \( f_Z(z) \).
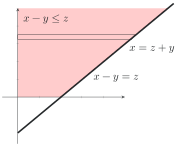
Sol Utilizando a expressão derivada anteriormente e a Figura 7.1, temos
onde a região de integração \( x - y \leq z \) é ilustrada na Figura 7.1.
Assim, obtemos
Quando as variáveis \( X \) e \( Y \) são independentes, a Equação 7.1 se reduz a
em que \(f_{-Y}(u)=f_Y(-u)\). Portanto, a densidade de uma diferença é a convolução da densidade de \(X\) com a densidade de \(-Y\).
Como um caso especial, suponha que
Nesse caso, \( z \) pode ser positivo ou negativo, o que requer uma análise separada para \( z \geq 0 \) e \( z \lt 0 \), pois as regiões de integração para esses casos diferem significativamente. Para \( z \geq 0 \), conforme mostrado na Figura 7.3a, temos
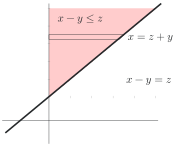
e para \(z\lt 0 \), da Fig. 7.3b
Após a diferenciação, temos
Para antecipar o exemplo do quociente, se \(X\) e \(Y\) são não negativas, a região \(\{ X/Y\leq z\} \), para \(z\geq 0\), é a mostrada na Figura 7.4. Nesse caso,
ou
Seja \( Z = \frac{X}{Y} \) e suponha que \(\P (Y=0)=0\). Vamos determinar a função de densidade \( f_{Z}(z) \).
Sol Iniciaremos pela distribuição acumulada:
A desigualdade \( \frac{X}{Y} \leq z \) pode ser reescrita como \( X \leq Yz \) quando \( Y \gt 0 \), e \( X \geq Yz \) quando \( Y \lt 0 \). Particionamos, então, o cálculo nos eventos \(\{ Y\gt 0\} \) e \(\{ Y\lt 0\} \); a hipótese \(\P (Y=0)=0\) assegura que nenhum caso com probabilidade positiva foi omitido. Assim,
Podemos expressar as probabilidades anteriores como integrais sobre duas regiões, obtendo:
Finalmente derivando a Equação 7.2, obtemos:
Observe que, se \( X \) e \( Y \) são variáveis aleatórias não negativas, a expressão anterior se reduz a:
Sejam \( X \) e \( Y \) variáveis aleatórias conjuntamente normais com média zero, cuja função de densidade conjunta é dada por:
Mostre que o quociente \( Z = \frac{X}{Y} \) tem uma densidade de Cauchy centrada em \( \frac{r \sigma _{1}}{\sigma _{2}} \).
Sol Utilizando o fato de que \( f_{XY}(-x, -y) = f_{XY}(x, y) \), obtemos:
onde
Assim, temos:
Essa é a densidade de Cauchy com parâmetro de localização \(r\sigma _1/\sigma _2\) e parâmetro de escala \(\sigma _1\sqrt{1-r^2}/\sigma _2\). Integrando de \( -\infty \) até \( z \), obtemos a função de distribuição correspondente:
Sejam \( X \) e \( Y \) variáveis aleatórias independentes, com \( X \sim \operatorname {Gama}(m, \beta ) \) e \( Y \sim \operatorname {Gama}(n, \beta ) \), na parametrização forma–taxa. Mostre que \( Z = \frac{X}{X + Y} \) segue uma distribuição beta.
Sol A função de densidade conjunta de \( X \) e \( Y \) é dada por:
Note que \( 0 \lt Z \lt 1 \), uma vez que \( X \) e \( Y \) são variáveis aleatórias não negativas. Assim, a função de distribuição acumulada \( F_{Z}(z) \) pode ser expressa como:
onde utilizamos a representação gráfica mostrada na Figura 7.4.
Diferenciando em relação a \( z \), obtemos:
Essa expressão representa uma distribuição beta.
Seja \(Z=X^{2}+Y^{2}\). Determine \(f_Z(z)\).
Sol Temos que
Mas, \(x^{2}+y^{2} \leq z\) representa a área de um círculo com raio \(\sqrt{z}\) e, portanto,
para \(z\gt 0\); para \(z\leq 0\), \(F_Z(z)=0\).
Logo
\(X\) e \(Y\) são variáveis aleatórias normais independentes com média zero e variância comum \(\sigma ^{2}\). Determine \(f_{Z}(z)\) para \(Z=X^{2}+Y^{2}\).
Sol Usando 7.3, para \(z\gt 0\) obtemos
onde usamos a substituição \(y=\sqrt z\sin \theta \). Assim, \(X^{2}+Y^{2}\) tem distribuição exponencial com taxa \(1/(2\sigma ^{2})\) e média \(2\sigma ^{2}\).
7.2 Funções de variáveis contínuas: método do Jacobiano
O método da função de distribuição pode exigir uma nova descrição da região de integração para cada valor do parâmetro. Para transformações diferenciáveis e invertíveis, o teorema de mudança de variáveis permite calcular diretamente a densidade transformada. O jacobiano mede a dilatação ou contração local de áreas. Se \(h=g^{-1}\), um pequeno retângulo de área \(dz\, dw\) corresponde, no plano original, a uma área aproximada
Esse fator compensa a mudança de área e preserva a massa de probabilidade.
Sejam \(A_0,A\subset \mathbb R^2\) regiões abertas e \(g:A_0\to A\) uma bijeção. Escreveremos
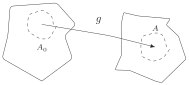
Como \(g\) é uma bijeção, existe a inversa \(h=g^{-1}:A\to A_0\), dada por
Suponha que as derivadas parciais
existem e são contínuas em \(A\).
Definimos o Jacobiano da transformação inversa \(h\) como o determinante
Podemos aplicar o Teorema de Mudança de Variáveis para densidades. Seja \(f = f_{X,Y}\) a densidade conjunta das variáveis aleatórias \(X\) e \(Y\), e assumamos que
Sejam \(Z\) e \(W\) as variáveis transformadas, ou seja, \(Z = g_1(X, Y)\) e \(W = g_2(X, Y)\). Então, para todo evento \(B \subset A\), temos
Assim, pela definição de densidade, a função obtida é a densidade de \((Z,W)\), e obtemos o seguinte teorema:
Para aplicar o teorema, determinamos o suporte transformado \(A\), escrevemos \(x\) e \(y\) em função de \(z,w\) e calculamos o módulo do jacobiano da inversa. Esse módulo multiplica a densidade original avaliada no ponto inverso. A identificação do suporte é indispensável: a expressão obtida vale em \(A\), e a densidade deve ser definida também fora dele.
Um gerador de números aleatórios costuma começar por uma variável \(U\sim \operatorname {Unif}(0,1)\). Como transformar esse número em um tempo de espera exponencial de taxa \(\lambda \)? A transformação
faz exatamente isso.
Sol A transformação leva \((0,1)\) em \((0,\infty )\) e sua inversa é \(u=e^{-\lambda t}\). Portanto,
Como a densidade de \(U\) vale \(1\) em \((0,1)\), obtemos
Logo \(T\sim \operatorname {Exp}(\lambda )\). O cálculo é unidimensional, mas já contém a ideia central do método: ao mudar de coordenadas, a densidade precisa compensar a deformação produzida pela transformação.
Em muitos exemplos, é mais fácil calcular o jacobiano da transformação direta. Como as matrizes derivadas de funções inversas são inversas uma da outra,
sendo
pois o determinante jacobiano da transformação direta costuma ser mais fácil de calcular. A identidade vale nos pontos em que ambos os determinantes são não nulos.
Nessa notação, a densidade conjunta pode ser expressa como
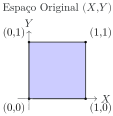
Dois servidores recebem cargas normalizadas \(X\) e \(Y\), modeladas como variáveis independentes e uniformes em \((0,1)\). Em vez das duas cargas separadas, queremos acompanhar
onde \(U\) mede a carga total e \(V\) o desequilíbrio entre os servidores. Quais pares \((U,V)\) podem ocorrer e como se distribuem?
Sol A transformação é linear e pode ser invertida imediatamente:
Seu jacobiano direto é
de modo que o módulo do jacobiano da inversa vale \(1/2\). Como \(f_{X,Y}(x,y)=1\) no quadrado unitário, temos
sempre que o ponto inverso pertence a esse quadrado.
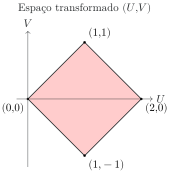
A geometria torna o suporte transparente: a transformação leva os quatro vértices do quadrado \((0,0),(0,1),(1,1),(1,0)\) nos pontos \((0,0),(1,-1),(2,0),(1,1)\). Assim,
e
O losango também revela algo que uma conta marginal esconderia: carga total e desequilíbrio não são independentes. Valores extremos de \(U\) restringem fortemente os valores possíveis de \(V\).
Duas etapas de um serviço têm durações independentes \(X\) e \(Y\), ambas exponenciais de taxa \(\lambda \). O tempo total é \(U=X+Y\), enquanto
registra qual etapa demorou mais e por quanto. Determine a densidade conjunta de \((U,V)\) e as distribuições dessas duas quantidades.
Sol A densidade original é
A inversa é
e as condições \(x\gt 0\), \(y\gt 0\) equivalem a \(u\gt 0\) e \(|v|\lt u\). Como o módulo do jacobiano da inversa vale \(1/2\),
Integrando em \(v\),
logo \(U\sim \operatorname {Gama}(2,\lambda )\). Para a diferença,
Portanto, a diferença entre duas exponenciais independentes de mesma taxa tem uma distribuição de Laplace centrada em zero. Apesar das formas simples das duas marginais, \(U\) e \(V\) não são independentes: o próprio suporte \(|v|\lt u\) acopla total e diferença.
Duas tarefas têm tempos de execução independentes \(X\) e \(Y\), ambos exponenciais com média \(\mu \). Para planejar o trabalho, duas quantidades são mais informativas do que os tempos separados:
Aqui \(U\) é o tempo total e \(V\) é a fração desse tempo gasta na primeira tarefa. Determine a densidade conjunta de \((U,V)\).
Sol A transformação é invertida por
O módulo do jacobiano da inversa é \(u\), pois
no suporte, onde \(u\gt 0\). Assim,
A densidade fatoriza:
Logo
e \(U\) e \(V\) são independentes.
O resultado é mais forte do que parece: depois de observar o tempo total, a fração desse tempo gasta na primeira tarefa continua uniformemente distribuída. Essa independência não é uma propriedade da transformação sozinha; o próximo exemplo mostra o que acontece quando mantemos \(U\) e \(V\), mas mudamos a distribuição de \(X\) e \(Y\).
Agora suponha que \(X\) e \(Y\) sejam independentes e uniformes em \((0,1)\), mas mantenha exatamente as mesmas quantidades
Será que soma e proporção continuam independentes?
Sol A inversa continua sendo
e o módulo do jacobiano continua sendo \(u\). A diferença está no suporte: agora precisamos impor simultaneamente
Como \(0\lt u\lt 2\) e \(0\lt v\lt 1\), essas restrições dão
Portanto,
nessa região e vale zero fora dela.
Geometricamente, o quadrado unitário não se transforma agora em um retângulo: para \(u\gt 1\), as restrições \(X\lt 1\) e \(Y\lt 1\) reduzem progressivamente o intervalo de valores possíveis de \(v\). Como o suporte não é um produto de um intervalo em \(u\) por um intervalo em \(v\), \(U\) e \(V\) não são independentes.
Comparado ao exemplo anterior, o jacobiano é o mesmo. O que mudou foi a combinação entre densidade e suporte. É essa combinação, e não a transformação isoladamente, que produziu a independência no caso exponencial.
Um sistema de posicionamento comete erros independentes \(X\) e \(Y\) nas direções horizontal e vertical, ambos com distribuição \(N(0,\sigma ^2)\). Para quem usa o sistema, porém, interessa mais a distância do erro à posição correta e sua direção. Defina
Determine a distribuição conjunta de \((R,\Theta )\).
Sol A densidade conjunta cartesiana é
Em coordenadas polares,
e o módulo do jacobiano da transformação inversa é
Logo,
A expressão já se separa em duas densidades:
Portanto,
e \(R\) e \(\Theta \) são independentes.
A simetria circular do erro gaussiano torna todas as direções igualmente prováveis. Além disso, a magnitude do erro é independente de sua direção.
O exemplo das duas tarefas exponenciais sugere uma pergunta: a independência entre soma e proporção sobrevive além do caso exponencial? Sejam
independentes, com a mesma taxa \(\beta \). Defina
Determine a distribuição conjunta de \((S,P)\).
Sol A transformação inversa é
com suporte \(s\gt 0\), \(0\lt p\lt 1\). O módulo do jacobiano é \(s\). Assim,
Reconhecemos as duas parcelas como densidades. Portanto,
e \(S\) e \(P\) são independentes.
Quando \(m=n=1\), recuperamos o exemplo das duas tarefas exponenciais: a soma é gama e a proporção é uniforme. A independência entre soma e proporção é, portanto, um caso particular da relação Beta–Gama.
7.2.1 Variáveis auxiliares
Às vezes, interessa apenas \(Z=g(X,Y)\), mas o método do jacobiano transforma duas coordenadas. Introduzimos então uma variável auxiliar \(W\), escolhida de modo que a transformação \((X,Y)\mapsto (Z,W)\) possa ser invertida. Por exemplo, podemos tomar
e completar a transformação com \(W=X\) ou \(W=Y\). Depois de obter \(f_{Z,W}\), integramos em \(w\) para recuperar a marginal \(f_Z\).
Considere duas variáveis aleatórias \( X \) e \( Y \). Calcule \( f_Z(z) \) sendo \( Z = X + Y \) a soma das variáveis aleatórias \( X \) e \( Y \).
Sol Suponha \(Z=X+Y\) e escolha \(W=Y\) para que a transformação seja injetiva e a solução seja dada por \(y=w, x=z-w\). O Jacobiano da transformação é dado por
E assim
E logo
Se \(X\) e \(Y\) forem independentes, a última integral é a convolução de \(f_X\) e \(f_Y\); veja a Definição 6.4.
Considere duas variáveis aleatórias contínuas \(X\) e \(Y\). Determine a densidade de \(Z=XY\).
Sol
Seja \(Z = XY\). Com \(W = X\), o sistema \(x y = z\), \(x = w\) possui uma única solução: \(x_1 = w\) e \(y_1 = \frac{z}{w}\). Nesse caso, temos \(J(x, y) = -w\), e consequentemente:
Portanto, a densidade da variável aleatória \(Z = XY\) é dada por:
Caso especial Agora assumimos que as variáveis aleatórias \(X\) e \(Y\) são independentes e possuem distribuição uniforme no intervalo \((0,1)\). Nesse caso, temos que \(z \lt w\) e
Assim, obtemos (veja a Figura 7.8):
Logo,
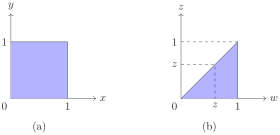
Funções não injetivas
Podemos utilizar o método do jacobiano também em casos em que a função \(g\) não é injetiva, bastando que \(g\) seja injetiva quando restrita a cada uma de \(k\) regiões abertas disjuntas cuja união contêm o valor de \(X\) com probabilidade um. Para tanto, suponhamos que \(G, G_{1}, \ldots , G_{k}\) sejam subregiões abertas do \(\mathbb {R}^{n}\) tais que \(G_{1}, \ldots , G_{k}\) sejam disjuntas e valha
e tais que a função \(\left.g\right|_{G_{i}}\), a restrição de \(g\) a \(G_{i}\), seja uma correspondência biunívoca entre \(G_{i}\) e \(G, \forall i=1, \ldots , k\). (Neste caso podemos dizer que a função \(g\) é \(k\) a 1.) Além disso, suponhamos que a função inversa de \(\left.g\right|_{G_{i}}\), denotada por \(h^{(i)}\), satisfaça todas as condições da função \(h\) do caso anterior, e indiquemos com \(J_{i}(X, y)\) o jacobiano da função \(h^{(i)}\). (Este jacobiano é função de \(y \in G\). Notemos que \(h^{(i)}: G \rightarrow G_{i}\) é uma bijeção.) Temos, então, o seguinte esquema:
Desde que
temos \(\P ( Y \in G)=1\), i.e., \(Y\) toma valores só em \(G\) (pelo menos com probabilidade 1).
7.3 Estatísticas de ordem
Em muitas aplicações, interessa a posição de uma observação na amostra ordenada: a menor, a maior ou a \(k\)-ésima menor. O tempo do vencedor de uma corrida é o mínimo dos tempos; a vida útil de um sistema em série é o mínimo das vidas de seus componentes, enquanto a de um sistema em paralelo é o máximo. A ordenação da amostra define novas variáveis aleatórias, chamadas estatísticas de ordem.
As distribuições dos extremos são obtidas diretamente a partir da função de distribuição das observações. O cálculo da densidade da \(k\)-ésima estatística e da distribuição conjunta de duas posições ordenadas exige também contar as possíveis posições das demais observações. Essas fórmulas serão aplicadas a problemas de confiabilidade e de amplitude da amostra.
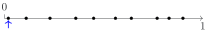
Sejam \(X_1,X_2,\ldots ,X_{10}\) uma amostra aleatória de tamanho 10 de uma distribuição uniforme em \((0,1)\). Abaixo aparecem três realizações e, em cada uma, o menor valor está destacado.
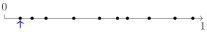
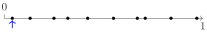
Reunindo os três mínimos em um único gráfico, obtemos:
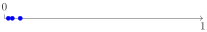
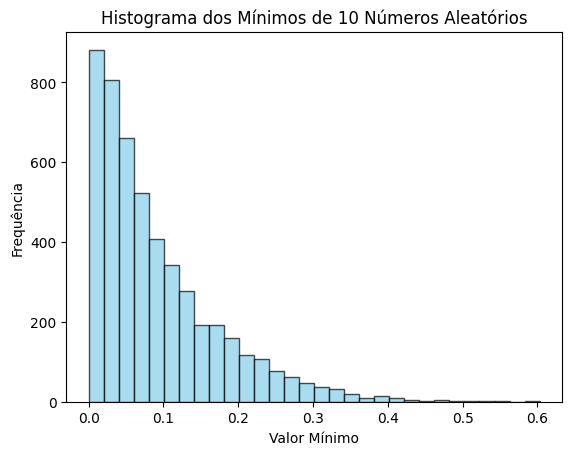
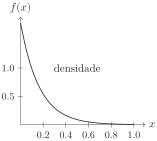
Não surpreendentemente, valores do mínimo próximos de zero são mais prováveis do que valores próximos de 1. Se repetirmos o experimento com amostras de tamanho 10, a densidade do mínimo tem o gráfico a seguir.
Considere uma amostra aleatória \(X_1,\ldots ,X_n\) de uma distribuição contínua com função de distribuição \(F\) e densidade \(f\). Definimos:
que representa o menor valor observado entre as variáveis \(X_{i}\), e:
correspondendo ao maior valor observado. De modo geral,
é a \(k\)-ésima estatística de ordem. A sequência
é a amostra ordenada.
De modo geral, temos \(X_{(1)} \leq X_{(2)} \leq \cdots \leq X_{(n)}\), implicando que valores de ordem podem coincidir. Entretanto, se a distribuição comum da amostra \(\left\{ X_1, X_2, \ldots , X_n\right\} \) for contínua, a probabilidade de coincidência é nula. Portanto, nas análises subsequentes, assumiremos que todos os valores observados são distintos, garantindo as seguintes desigualdades estritas:
Estatísticas de ordem extremas
As distribuições de \(X_{(1)}\) e \(X_{(n)}\) podem ser descritas a partir dos eventos que definem o mínimo e o máximo. Começando pelo máximo,
pois a condição \(X_{(n)} \leq x\) implica que todos os valores \(X_{i}\) devem ser menores ou iguais a \(x\), e o contrário também é verdadeiro. Como \(X_{1}, X_{2}, \ldots , X_{n}\) são variáveis independentes, podemos escrever:
Denotando a função de densidade de \(X_{(n)}\) por \(g_{n}(x)\), obtemos, ao derivar ambos os lados da expressão anterior:
A função de densidade de \(X_{(1)}\), que chamamos de \(g_{1}(x)\), pode ser encontrada de forma semelhante. Consideramos:
Portanto, ao derivar, obtemos:
Suponha que os tempos, em segundos, de oito velocistas sejam variáveis aleatórias independentes, todas com a distribuição uniforme \(\mathcal{U}(9.6,10.0)\). Queremos encontrar a probabilidade de que o resultado do vencedor seja menor que 9.69, ou seja, calcular \(\P (X_{(1)} \lt 9.69)\).
Sol A função densidade de probabilidade da variável aleatória \(X\) é dada por \(f_X(x) = 2.5 \cdot \mathbb {1}_{(9.6,10.0)}(x)\), onde
Para o valor específico de \(x = 9.69\), podemos calcular a função de distribuição acumulada \(F_X(x)\).
A probabilidade desejada é dada por:
Substituindo \(F_X(x)\) na expressão, temos:
Portanto, substituindo \(F_X(9.69)\) na equação da probabilidade:
Assim, concluímos que a probabilidade de que o tempo do vencedor seja inferior a 9.69 segundos é aproximadamente 0.86986, ou 86.986%.
Outras estatísticas de ordem
O evento \(\{ X_{(j)}\leq x\} \) ocorre se pelo menos \(j\) das \(n\) observações forem menores ou iguais a \(x\). Como cada observação satisfaz essa condição com probabilidade \(F(x)\), a contagem correspondente é binomial. Portanto,
Ao derivar (7.12), os termos intermediários se cancelam pela identidade \(\binom {n}{k+1}(k+1)=\binom {n}{k}(n-k)\). Resta
Há também uma interpretação local: para \(X_{(j)}\) cair em um pequeno intervalo ao redor de \(x\), devem existir \(j-1\) observações abaixo de \(x\), uma nesse intervalo e \(n-j\) acima de \(x\). As três categorias têm pesos aproximados \(F(x)\), \(f(x)\, dx\) e \(1-F(x)\), o que reproduz a fórmula anterior por uma contagem multinomial.
Se generalizarmos para a densidade conjunta de \(X_{(i)}\) e \(X_{(j)}\), com \(i\lt j\), a mesma contagem multinomial fornece, para \(x_i\lt x_j\),
Fora da região \(x_i\lt x_j\), essa densidade é zero.
Em particular, a função de densidade conjunta para \(X_{(1)}\) e \(X_{(n)}\) torna-se:
O mesmo método pode ser aplicado para encontrar a densidade conjunta de \(X_{(1)}, X_{(2)}, \ldots , X_{(n)}\), que resulta em:
A partir dessa função de densidade conjunta, é possível obter a função de densidade marginal para qualquer uma das estatísticas de ordem, embora esse tópico não seja abordado neste texto.
Considere componentes eletrônicos de um certo tipo, cujo tempo de vida \(X\) em horas é descrito por uma densidade de probabilidade:
Dessa forma temos que o tempo médio de vida é de 100 horas. Suponha que dois desses componentes operem de forma independente e em série em um sistema; isto é, o sistema falha assim que um dos componentes falha. Determine a função de densidade para \(Y\), o tempo de vida do sistema.
Sol Como o sistema falha com a falha do primeiro componente, temos \(Y = \min \left(X_{1}, X_{2}\right)\), onde \(X_{1}\) e \(X_{2}\) são variáveis aleatórias independentes com a densidade dada. Sabemos que \(F(x) = 1 - e^{-x / 100}\) para \(x \geq 0\), então:
Portanto, o mínimo de duas variáveis aleatórias exponenciais também segue uma distribuição exponencial, porém com uma média reduzida pela metade.
Considere agora que, na situação anterior, os componentes operem em paralelo: o sistema só falha depois que ambos falharem. Determine a densidade de \(Y\), o tempo de vida do sistema.
Sol Neste caso, \(Y = \max \left(X_{1}, X_{2}\right)\), e temos:
Observe que o máximo de duas variáveis aleatórias exponenciais não é, necessariamente, uma variável aleatória exponencial.
O tempo médio de vida do sistema é
Suponha que \(X_{1}, X_{2}, \ldots , X_{n}\) sejam variáveis aleatórias independentes, cada uma com distribuição uniforme no intervalo \((0,1)\).
Encontre a função de densidade de probabilidade da amplitude \(R = X_{(n)} - X_{(1)}\).
Calcule a média e a variância de \(R\).
Sol
1. No caso de uma distribuição uniforme, temos:
e
Assim, a função de densidade conjunta de \(X_{(1)}\) e \(X_{(n)}\) é:
Para encontrar a densidade de \(R = X_{(n)} - X_{(1)}\), fixamos o valor de \(x_{1}\) e definimos \(R = X_{n} - x_{1}\). Portanto, \(R = g(X_{n}) = X_{n} - x_{1}\), e a função inversa é \(X_{n} = h(R) = R + x_{1}\). Usando métodos de transformação, temos:
Ainda é uma função de \(x_{1}\) e \(r\), e devemos ter \(x_{1} \leq 1 - r\). Ao integrar em relação a \(x_{1}\), obtemos:
Para o item 2, usando integrais beta,
Consequentemente,
7.4 Exemplos integradores
Neste capítulo, as aplicações centrais são mudanças suaves de coordenadas e estatísticas de ordem. Os exemplos a seguir mostram essas duas ideias em ação, primeiro pelo jacobiano e depois por máximos e mínimos.
Sejam \(U\) e \(V\) independentes e uniformes em \((0,1)\), e defina
A transformação inversa é
Pelo método do jacobiano,
Agora considere
Na mudança de coordenadas polares, o fator de área é \(r\). Assim,
Portanto, \(X\) e \(Y\) são normais padrão independentes.
Essa transformação, conhecida como Box–Muller, mostra o caminho inverso ao usual: em vez de descobrir apenas a distribuição de uma transformação, escolhemos a transformação para construir uma distribuição desejada.
7.5 Exercícios