Esperança
A esperança associa à distribuição de uma variável um valor central, obtido por uma média ponderada. No caso discreto, os pesos são probabilidades; no contínuo, o cálculo é feito por integração contra a densidade. Se \(X\) é discreta e assume valores no conjunto enumerável \(C\), então
Se \(X\) tem densidade \(f_X\), a fórmula correspondente é
As propriedades da esperança permitem calcular médias de funções de uma ou várias variáveis e fundamentam o estudo da variância, da covariância e da correlação. O condicionamento oferece uma forma de decompor esses cálculos; os momentos e suas funções geradoras reúnem outras informações sobre a distribuição.
8.1 Definição e propriedades fundamentais
As fórmulas de esperança já foram apresentadas. Estudaremos agora propriedades que permitem calcular médias sem determinar uma nova distribuição a cada passo. A linearidade, as variáveis indicadoras e a fórmula das caudas serão os primeiros recursos para esse cálculo.
sempre que a soma e a integral convergirem absolutamente.
\(\mathbf{E}[aX+bY]=a\mathbf{E}[X]+b\mathbf{E}[Y]\);
se \(X\leq Y\), então \(\mathbf{E}[X]\leq \mathbf{E}[Y]\);
\(|\mathbf{E}[X]|\leq \mathbf{E}[|X|]\);
para todo evento \(A\), \(\mathbf{E}[\mathbb {1}_A]=\P (A)\).
A ideia é a mesma nos casos discreto e contínuo: um valor \(x\geq 0\) pode ser medido pelo comprimento do intervalo que fica abaixo dele,
Se \(X\) é discreta, com valores não negativos \(x_i\) e probabilidades \(p_i\), então
Se \(X\) possui densidade \(f_X\), então
Como os integrandos são não negativos, a troca da ordem de integração não cria problemas de cancelamento.
Finalmente, se \(X\) assume valores inteiros não negativos, então para \(k-1\leq t\lt k\) vale \(\P (X\gt t)=\P (X\geq k)\). Particionando a integral em intervalos unitários,
o que prova a segunda fórmula.
A interpretação é geométrica: em vez de somar os valores de \(X\) diretamente, podemos somar suas “camadas”. Para cada altura \(t\), contamos a probabilidade de a variável ultrapassar esse nível. No caso inteiro, essas camadas são os níveis \(1,2,\ldots \); no caso contínuo, elas variam continuamente com \(t\).
8.2 Esperança de funções de vetores aleatórios
Sejam \(X,Y\) variáveis aleatórias e \(g:\mathbb R^2\to \mathbb R\). Para calcular a média de \(g(X,Y)\), poderíamos determinar primeiro sua distribuição. Esse passo, porém, não é necessário: podemos obter \(\mathbf{E}[g(X,Y)]\) diretamente da distribuição conjunta, atribuindo a cada par \((x,y)\) o valor \(g(x,y)\) e usando como peso a probabilidade ou a densidade conjunta.
Se \(X,Y\) são discretas e
\[ \sum _x\sum _y |g(x,y)|\P (X=x,Y=y)\lt \infty , \]então
\[ \mathbf{E}[g(X,Y)] =\sum _x\sum _y g(x,y)\P (X=x,Y=y). \]Se \((X,Y)\) possui densidade conjunta \(f_{XY}\) e
\[ \iint _{\mathbb R^2}|g(x,y)|f_{XY}(x,y)\, dx\, dy\lt \infty , \]então
\[ \mathbf{E}[g(X,Y)] =\iint _{\mathbb R^2}g(x,y)f_{XY}(x,y)\, dx\, dy. \]
No caso discreto, agrupe os pares \((x,y)\) segundo o valor \(z=g(x,y)\). Se \(Z=g(X,Y)\), então
Logo,
A convergência absoluta garante que o reagrupamento das somas não altera o resultado.
No caso contínuo, suponha primeiro \(g\geq 0\). Pela fórmula das caudas,
Como
trocando a ordem de integração obtemos
Para uma função que assume ambos os sinais, escreva \(g=g^+-g^-\) e aplique o caso não negativo às duas parcelas. A hipótese de integrabilidade garante que ambas sejam finitas.
Para uma única variável, a mesma regra fica:
A Tabela 8.1 resume os casos especiais mais importantes de 8.5.
| Discreto $X$ | $\E[g(X)]=\dsum_{i} g\left(t_{i}\right) \P\left(X=t_{i}\right)$ |
|---|---|
| Absolutamente Contínuo $X$ | $\E[g(X)]=\dint_{-\infty}^{\infty} g(x) f_{X}(x) d x$ |
Um acidente ocorre em um ponto \( X \), que é distribuído uniformemente ao longo de uma estrada de comprimento \( L \). No momento do acidente, uma ambulância está no ponto \( Y \), que também é distribuído uniformemente ao longo da mesma estrada. Suponha que \( X \) e \( Y \) sejam variáveis independentes. A tarefa é determinar a distância esperada entre a ambulância e o local do acidente.
Sol Para resolver o problema, precisamos encontrar \( \mathbf{E}[|X - Y|] \), que representa a distância esperada entre os pontos \( X \) e \( Y \). Como \( X \) e \( Y \) são independentes e uniformemente distribuídos, a função densidade conjunta é:
De acordo com o Teorema 8.3, podemos expressar a distância esperada como:
Vamos calcular a integral interna primeiro:
Resolvendo cada uma das integrais separadamente, temos:
Somando os resultados:
Agora, substituímos na integral externa para encontrar \( \mathbf{E}[|X - Y|] \):
Calculando a integral:
Portanto, a distância esperada entre a ambulância e o local do acidente é:
Funções de variáveis aleatórias independentes
Quando \(X\) e \(Y\) são independentes, a distribuição conjunta fatora. Isso permite calcular uma esperança por somas ou integrais sucessivas usando apenas as distribuições marginais.
Pela independência, a distribuição conjunta fatora. No caso discreto,
e, portanto, o Teorema 8.3 fornece imediatamente
No caso contínuo, a independência equivale a
Substituindo essa fatoração na fórmula do mesmo teorema,
A hipótese de não negatividade ou integrabilidade é justamente a que garante a validade das somas ou integrais iteradas utilizadas acima.
Em particular, a esperança do produto de funções de variáveis aleatórias independentes é o produto de suas esperanças.
Aplique o teorema anterior a \(h(x,y)=g_1(x)g_2(y)\). Tanto no caso discreto quanto no contínuo, a soma ou integral iterada fatora no produto de duas expressões:
A diferença \(\mathbf{E}[XY]-\mathbf{E}[X]\mathbf{E}[Y]\) é denominada covariância. Ela mede associação linear; covariância nula, por si só, não implica independência.
Considere uma partícula inicialmente localizada em um ponto dado no plano. Suponha que a partícula execute uma sequência de passos, todos de mesmo comprimento, mas em direções escolhidas de forma completamente aleatória. Especificamente, após cada passo, a nova posição da partícula é alcançada a uma distância de exatamente uma unidade da posição anterior, sendo o ângulo do movimento uniformemente distribuído no intervalo \((0, 2\pi )\), como ilustrado na Figura 8.1. Determine o valor esperado do quadrado da distância da partícula à origem após \(n\) passos.
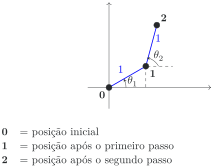
Sol Se \(\left(X_i, Y_i\right)\) representa, em coordenadas retangulares, a mudança de posição no \(i\)-ésimo passo, com \(i=1, \ldots , n\), então temos:
onde \(\theta _i\), para \(i=1, \ldots , n\), é, por hipótese, uma variável aleatória independente e uniformemente distribuída no intervalo \((0, 2\pi )\). Como a posição da partícula após \(n\) passos tem coordenadas retangulares \(\left(\sum _{i=1}^n X_i, \sum _{i=1}^n Y_i\right)\), o quadrado da distância \(D^2\) em relação à origem é dado por:
onde usamos o fato de que \(\cos ^2 \theta _i + \sin ^2 \theta _i = 1\).
Ao calcular as esperanças, utilizamos a independência de \(\theta _i\) e \(\theta _j\) para \(i \neq j\), além das seguintes propriedades de integração sobre o intervalo \((0, 2\pi )\):
Portanto, obtemos o resultado:
Suponha que \( N \) pessoas joguem seus chapéus no centro de uma sala. Os chapéus são misturados aleatoriamente, e cada pessoa seleciona um chapéu ao acaso. Qual é o número esperado de pessoas que recuperam o próprio chapéu?
Sol Vamos definir a variável aleatória \( X \) como o número de pessoas que selecionam seus próprios chapéus. Podemos expressar \( X \) como a soma de variáveis indicadoras individuais:
onde, para cada \( i = 1, 2, \dots , N \),
Cada variável \( X_i \) indica o evento de a pessoa \( i \) recuperar seu próprio chapéu. A probabilidade desse evento é
pois há \( N \) chapéus igualmente prováveis, e apenas um deles pertence à pessoa \( i \).
Assim, o valor esperado de \( X_i \) é
Embora as variáveis \( X_i \) não sejam independentes (porque a seleção de chapéus por uma pessoa afeta as opções disponíveis para as outras), a linearidade da esperança matemática não requer independência. Portanto, podemos somar os valores esperados individuais:
Portanto, o número esperado de pessoas que recuperam seus próprios chapéus é 1.
Suponha que existam \( N \) tipos diferentes de cupons de desconto, e que cada vez que alguém recolhe um cupom, este tenha igual probabilidade de ser qualquer um dos \( N \) tipos. Determine o número esperado de cupons que alguém precisa acumular antes de conseguir um conjunto completo que contenha pelo menos um de cada tipo.
Sol
Seja \( X \) o número total de cupons acumulados até que se obtenha pelo menos um de cada tipo. Vamos calcular \( \mathbf{E}[X] \) decompondo \( X \) como a soma de variáveis aleatórias \( X_i \), onde \( X_i \) representa o número de cupons necessários para passar de possuir \( i - 1 \) tipos distintos para possuir \( i \) tipos distintos de cupons.
Assim, temos:
Inicialmente, não temos nenhum cupom, então o primeiro cupom sempre será de um novo tipo. Portanto, \( X_1 = 1 \).
Para \( i \geq 2 \), suponha que já tenhamos \( i - 1 \) tipos distintos de cupons. A probabilidade de que o próximo cupom seja de um tipo novo é:
Logo, \( X_i \) é uma variável aleatória geométrica com parâmetro \( p_i \). A esperança matemática de uma variável geométrica é dada por \( \mathbf{E}[X_i] = \frac{1}{p_i} \), portanto:
O número esperado total de cupons necessários é a soma das esperanças individuais:
Para simplificar a soma, realizamos a substituição \( k = N - i + 1 \), o que implica \( i = N - k + 1 \). Quando \( i = 1 \), \( k = N \); quando \( i = N \), \( k = 1 \). Assim, a soma torna-se:
8.3 Variância e covariância
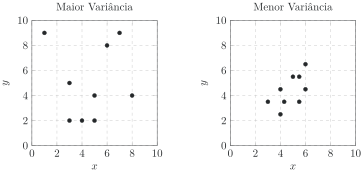
Duas variáveis com a mesma média podem apresentar dispersões muito diferentes. A variância descreve essa diferença por meio do desvio quadrático médio em torno da esperança. Para estudar a variação conjunta de duas variáveis, introduziremos também a covariância.
Quanto maior a variância, maior tende a ser a dispersão. Sua raiz quadrada é o desvio padrão, expresso na mesma unidade de \(X\), e por isso mais fácil de interpretar diretamente.
Uma fórmula alternativa para \(\operatorname {Var}(X)\) é deduzida a seguir:
Considere cinco lançamentos de uma moeda honesta. Seja \(H\) o número de caras. Calcule \(\mathbf{E}[H]\) e \(\operatorname {Var}(H)\). Lembramos que
Logo a esperança é
Para o calculo da variância começaremos calculando
Logo a variância é
A variância trata de uma variável; para duas variáveis, a covariância descreve como seus desvios em relação às médias variam em conjunto. Ela mede associação linear, não independência.
A covariância pode assumir valores positivos, negativos ou zero:
Um valor positivo indica que as duas variáveis tendem a aumentar juntas.
Um valor negativo indica que uma variável tende a aumentar quando a outra diminui.
Um valor próximo de zero indica que não há uma relação linear clara entre as duas variáveis.
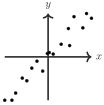
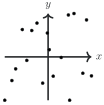
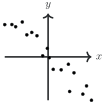
Se \(X\) e \(Y\) são independentes, então \(\operatorname {Cov}(X,Y)=0\). A recíproca é falsa. Para ver isso, seja \(X\) tal que
e definindo-se
Como \(XY=0\), temos \(\mathbf{E}[XY]=0\); além disso, \(\mathbf{E}[X]=0\). Logo,
Entretanto, \(X\) e \(Y\) são claramente dependentes. A proposição a seguir lista algumas propriedades da covariância.
\(\operatorname {Cov}(X, Y)=\operatorname {Cov}(Y, X)\)
\(\operatorname {Cov}(X, X)=\operatorname {Var}(X)\)
\(\operatorname {Cov}(a X, Y)=a \operatorname {Cov}(X, Y)\)
\(\operatorname {Cov}\left(\sum _{i=1}^n X_i, \sum _{j=1}^m Y_j\right)=\sum _{i=1}^n \sum _{j=1}^m \operatorname {Cov}\left(X_i, Y_j\right)\)
As proposições 1 e 2resultam imediatamente da definição da covariância, e a proposição 3é deixada como exercício para o leitor. Para demonstrar a proposição 4 , que diz que a operação de cálculo da covariância é aditiva (como é a operação de cálculo do valor esperado), suponha que \(\mu _i=\mathbf{E}\left[X_i\right]\) e \(v_j=\mathbf{E}\left[Y_j\right]\). Então,
e
onde a última igualdade é obtida porque o valor esperado da soma de variáveis aleatórias é igual à soma de seus valores esperados.
Tomando \(Y_j=X_j\) nas propriedades 2 e 4 da Proposição 8.8, obtemos
Como cada par de índices \(i, j, i \neq j\), aparece duas vezes no somatório duplo, a fórmula anterior é equivalente a
Se \(X_{1}, \ldots , X_{n}\) são independentes por pares, no sentido de \(X_{i}\) e \(X_{j}\) serem independentes para \(i \neq j\), então a Equação 8.3 reduz-se para
Calcule a variância de uma variável aleatória binomial \(X\) com parâmetros \(n\) e \(p\).
Sol Como tal variável aleatória representa o número de sucessos em \(n\) tentativas independentes quando cada tentativa tem a mesma probabilidade de sucesso \(p\), podemos escrever
onde \(X_{i}\) representa variáveis independentes de Bernoulli tais que
Com isso, da Equação 8.3, obtemos
Mas
Logo,
Sejam \(X_{1}, \ldots , X_{n}\) variáveis aleatórias independentes identicamente distribuídas com valor esperado \(\mu \) e variância \(\sigma ^{2}\), e suponha que \(\bar{X}=\sum _{i=1}^{n} X_{i} / n\) seja a média amostral. As grandezas \(X_{i}-\bar{X}, i=1, \ldots , n\), são chamadas de desvios, e elas são iguais às diferenças entre os valores individuais dos dados e a média amostral. A variável aleatória
é chamada de variância amostral. Determine
\(\operatorname {Var}(\bar{X})\) e
\(\mathbf{E}\left[S^{2}\right]\).
Sol 1
2 Começamos com a seguinte identidade algébrica:
Calculando a esperança da equação anterior, obtemos
onde usamos o item 1 e o fato de que \(\mathbf{E}[\bar X]=\mu \). Dividindo por \(n-1\), concluímos que \(\mathbf{E}[S^2]=\sigma ^2\): a variância amostral é um estimador não viesado da variância da população.
Considere \( m \) tentativas independentes, em que cada uma pode resultar em um dos \( r \) possíveis desfechos, com probabilidades associadas \( p_1, p_2, \ldots , p_r \), satisfazendo \( \sum _{i=1}^{r} p_i = 1 \). Definimos \( N_i \), para \( i = 1, \ldots , r \), como a quantidade de tentativas que resultam no desfecho \( i \). Nessas condições, as variáveis \( N_1, N_2, \ldots , N_r \) seguem uma distribuição multinomial, dada por:
onde \( \sum _{i=1}^{r} n_i = m \). Agora, calcule a covariância entre \( N_i \) e \( N_j \).
Sol Podemos começar observando que, para \( i \neq j \), é razoável supor que, à medida que \( N_i \) aumenta, \( N_j \) tende a diminuir. Assim, é intuitivo concluir que essas variáveis apresentam uma covariância negativa. Vamos calcular sua covariância usando a Proposição 8.8 e as representações
onde
Da Proposição 8.8, temos
Agora, por um lado, quando \(k \neq \ell \),
pois o resultado da tentativa \(k\) é independente do resultado da tentativa \(\ell \). Por outro lado,
onde a equação usa o fato de que \(I_{i}(\ell ) I_{j}(\ell )=0\), já que a tentativa \(\ell \) não pode levar simultaneamente aos resultados \(i \mathbf{E}j\). Com isso, obtemos
o que está de acordo com nossa intuição de que as variáveis \(N_{i}\) e \(N_{j}\) são negativamente correlacionados.
Considere \( X \) e \( Y \) definidos como:
onde \( \Theta \) é uma variável aleatória uniformemente distribuída no intervalo \( (0, 2\pi ) \).
Mostre que \( X \) e \( Y \) são não-correlacionadas.
Mostre que \( X \) e \( Y \) não são independentes.
\( X \) e \( Y \) são não-correlacionadas.
Sabemos que
Então:
De forma semelhante:
Agora, calculemos \( \mathbf{E}[XY] \):
Portanto, como \( \mathbf{E}[XY] = \mathbf{E}[X]\mathbf{E}[Y] \), concluímos que \( X \) e \( Y \) são não-correlacionadas.
\( X \) e \( Y \) não são independentes.
Calculando:
De forma semelhante:
Por fim:
Logo:
Isso implica que \( X \) e \( Y \) não são independentes.
Dois resultados relacionam a esperança e a mediana a problemas de predição. Suponhamos que se queira escolher uma constante real \(c\) para representar o valor de uma variável aleatória \(X\). Se o critério é minimizar o erro absoluto médio, isto é, a média de \(|X-c|\), uma mediana é um preditor ótimo (veja a definição adiante). Se o critério é minimizar o erro quadrático médio \(\mathbf{E}(X-c)^2\), o melhor preditor é a média:
\((X-c)^2=(X-\mu +\mu -c)^2=(X-\mu )^2+2(\mu -c)(X-\mu )+(\mu -c)^2\), logo (pela linearidade da esperança)
Logo\(\mathbf{E}(X-c)^2 \geq \mathbf{E}(X-\mu )^2, \forall c \in \mathbb {R}\).
Por definição, \(m\) é uma mediana de \(X\) se \(\P (X \geq m) \geq 1 / 2\) e \(\P (X \leq m) \geq 1 / 2\).
8.3.1 Correlação
A covariância depende das unidades em que as variáveis são medidas. Para obter uma medida normalizada de associação linear, dividimos a covariância pelo produto dos desvios padrão. O coeficiente de correlação assim definido varia entre -1 e 1.
Para demonstrar a Equação 8.13, suponha que \(X\) e \(Y\) tenham variâncias dadas por \(\sigma _{x}^{2}\) e \(\sigma _{y}^{2}\), respectivamente. Então, por um lado,
o que implica que
Por outro lado,
o que implica que
o que completa a demonstração da Equação 8.13.
De fato, como \(\operatorname {Var}(Z)=0\) implica que \(Z\) é constante com probabilidade 1, a igualdade ocorre exatamente quando \(Y=a+bX\) com probabilidade 1: temos \(\rho (X,Y)=1\) se \(b\gt 0\) e \(\rho (X,Y)=-1\) se \(b\lt 0\).
A correlação mede associação linear. Valores próximos de \(1\) ou \(-1\) indicam forte alinhamento linear; o sinal indica a direção. Já \(\rho (X,Y)=0\) significa apenas que as variáveis são não correlacionadas. Não significa independência nem ausência de relação: o exemplo anterior tem covariância zero e, ainda assim, dependência entre \(X\) e \(Y\).
8.4 Esperança condicional
A esperança depende da informação que temos. Considere dois dados independentes: \(X\) é a soma dos resultados e \(Y\) é o resultado do primeiro dado. Antes de observar qualquer dado,
Se descobrimos que \(Y=5\), então
A variável \(X\) não mudou; mudou a informação disponível sobre ela.
A esperança condicional é a média calculada com a informação adicional: condicionamos a distribuição de \(X\) ao valor \(Y=y\) e, em seguida, calculamos a esperança com essa distribuição.
Se \(X\) e \(Y\) são conjuntamente discretas, para \(p_Y(y)\gt 0\),
\[ \mathbf{E}[X\mid Y=y] =\sum _x x\, p_{X\mid Y}(x\mid y). \]Se \(X\) e \(Y\) são conjuntamente contínuas, para \(f_Y(y)\gt 0\),
\[ \mathbf{E}[X\mid Y=y] =\int _{-\infty }^{\infty } x\, f_{X\mid Y}(x\mid y)\, dx. \]
No exemplo dos dados, \(\varphi (y)=y+3{,}5\). Antes de observar \(Y\), portanto, \(\varphi (Y)\) ainda é aleatória; essa variável será denotada por
Em resumo: \(\mathbf{E}[X\mid Y=y]\) é uma média para uma informação já conhecida; \(\mathbf{E}[X\mid Y]\) registra qual média será usada quando \(Y\) for observado.
No caso contínuo, por exemplo,
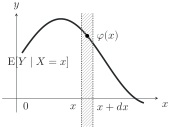
Esse número é o centro da distribuição condicional de \(Y\) para o valor observado \(X=x\). À medida que \(x\) varia, esses centros formam a função
frequentemente chamada de linha de regressão; veja a Figura 8.5.
Seja
Determine \(\mathbf{E}( X \mid Y )\) e \(\mathbf{E}( Y \mid X )\).
Sol Como a Figura 8.6 mostra, \(f_{X Y}(x, y)=1\) na área sombreada e zero em outros lugares. Portanto,
e
Isso dá
e
Portanto,
enquanto, por simetria,
Logo,
Se \(Y\) não traz informação sobre \(X\), a média também não deve mudar.
A independência implica que a distribuição condicional de \(X\) dado \(Y=y\) coincide com a distribuição marginal de \(X\): no caso discreto, \(p_{X\mid Y}(x\mid y)=p_X(x)\), e no contínuo, \(f_{X\mid Y}(x\mid y)=f_X(x)\). Substituindo na definição de esperança condicional obtemos o resultado.
Se \(X\) e \(Y\) são variáveis aleatórias binomiais independentes com parâmetros \(n\) e \(p\) idênticos, calcule o valor esperado condicional de \(X\) dado que \(X+Y=m\).
Sol Vamos primeiro calcular a função de probabilidade condicional de \(X\) dado que \(X+Y=m\). Para \(k \leq \min (n, m)\),
onde usamos o fato de que \(X+Y\) é uma variável aleatória binomial com parâmetros \(2 n\) e \(p\). Com isso, a distribuição condicional de \(X\) dado que \(X+Y=m\) é hipergeométrica. Mais precisamente, trata-se de uma hipergeométrica com população \(2n\), \(n\) elementos de um dos tipos e amostra de tamanho \(m\). Assim, pela fórmula da esperança da hipergeométrica, obtemos
Suponha que a densidade conjunta de \(X\) e \(Y\) seja dada por
Calcule \(\mathbf{E}[X \mid Y=y]\).
Sol Começamos calculando a densidade condicional
Com isso, a distribuição condicional de \(X\), dado que \(Y=y\), é uma distribuição exponencial com média \(y\). Assim,
Uma vez fixado \(Y=y\), calculamos com a distribuição condicional exatamente como calcularíamos com qualquer outra distribuição. Em particular,
e a linearidade continua válida. No caso contínuo, embora \(\P (Y=y)=0\), a densidade condicional fornece a regra correta; não estamos dividindo por \(\P (Y=y)\).
8.4.1 Esperança condicional como variável aleatória
A distinção apresentada no exemplo inicial pode ser formalizada da seguinte maneira.
No caso contínuo, substituímos a densidade condicional:
A integrabilidade de \(X\) justifica a troca da ordem de integração. No caso discreto, o mesmo cálculo é feito trocando integrais por somas.
Se \(Y\) é uma variável aleatória discreta, então a Equação 8.14 diz que
Por outro lado, se \(Y\) é contínua com densidade \(f_{Y}(y)\), a Equação 8.14 diz que
A identidade (8.14) é chamada de lei da esperança total. Ela calcula a média global ponderando as médias condicionais pela distribuição de \(Y\). Em muitos problemas, fixar \(Y\) simplifica o cálculo da média condicional; os exemplos seguintes mostram como usar essa decomposição.
Em um experimento, um ratinho é colocado em um labirinto com três portas. A primeira porta conduz a um túnel que o leva à saída após 12 minutos. A segunda porta leva a um túnel que o fará retornar ao labirinto após 36 minutos. Já a terceira porta conduz a um túnel que também o faz retornar ao labirinto, mas após 48 minutos. Supondo que o ratinho escolha qualquer uma das portas com igual probabilidade, qual é o tempo esperado até que ele consiga sair do labirinto?
Sol Seja \( X \) o tempo (em minutos) até que o ratinho alcance a saída, e seja \( Y \) a porta escolhida inicialmente. O tempo esperado \( \mathbf{E}[X] \) pode ser expresso como:
Como as portas são escolhidas com igual probabilidade, temos:
Agora, analisamos cada caso condicionado à escolha da porta inicial:
A justificativa para as equações acima é a seguinte: se o ratinho escolher a primeira porta, ele sairá do labirinto em exatamente 12 minutos, logo \( \mathbf{E}[X \mid Y=1] = 12 \). Se escolher a segunda porta, gastará 36 minutos no túnel antes de retornar ao labirinto, e então o problema será idêntico ao inicial, com um tempo esperado adicional \( \mathbf{E}[X] \). Portanto, \( \mathbf{E}[X \mid Y=2] = 36 + \mathbf{E}[X] \). Um raciocínio semelhante aplica-se à terceira porta, resultando em \( \mathbf{E}[X \mid Y=3] = 48 + \mathbf{E}[X] \).
Substituindo essas expressões na equação para \( \mathbf{E}[X] \), obtemos:
Simplificando:
Multiplicando ambos os lados por 3 e isolando \( \mathbf{E}[X] \), temos:
Portanto, o tempo esperado para que o ratinho saia do labirinto é de 96 minutos.
Considere uma cafeteria onde o número de clientes que entram em um determinado dia é uma variável aleatória com média igual a \(70\). Suponha também que os valores gastos pelos clientes sejam variáveis aleatórias independentes, com uma média comum de \(R\$ 60,00\). Além disso, assuma que os gastos de cada cliente são independentes do número total de clientes que entram na cafeteria. Qual é o valor esperado do total gasto na cafeteria em um dia?
Sol
Seja \(N\) o número de clientes que entram na cafeteria e \(X_i\) o valor gasto pelo \(i\)-ésimo cliente. O gasto total no dia pode ser expresso como \(\sum _{i=1}^{N} X_i\). Calculamos a expectativa da soma da seguinte forma:
Por outro lado:
Devido à independência entre \(X_i\) e \(N\), temos:
Como as variáveis \(X_i\) são independentes e identicamente distribuídas, segue que:
Assim, concluímos que:
Logo:
No contexto do exemplo, temos \(\mathbf{E}[N] = 70\) e \(\mathbf{E}[X] = 60\). Portanto, a quantidade esperada de dinheiro gasto na cafeteria em um dia é:
O tempo necessário para descarregar um trem que transporta cereais é distribuído uniformemente entre \( a \) e \( b \) horas, isto é, \( T \sim U(a, b) \), quando não há interrupções. No entanto, a grua utilizada na descarga é pouco confiável e está sujeita a avarias que ocorrem de acordo com uma distribuição de Poisson com média de \( \lambda \) avarias por hora. Cada vez que a grua falha, são necessárias \( d \) horas para consertá-la. Nosso objetivo é determinar o tempo médio real de descarga do trem, considerando todas essas condições.
Sol Seja \( T_R \) o tempo real de descarga do trem, cujo valor esperado \( \mathbf{E}(T_R) \) desejamos encontrar. Observamos que \( T_R \) depende do tempo de descarga sem interrupções \( T \) e do número de avarias \( N_T \) que ocorrem durante esse período. O número de avarias \( N_T \) segue uma distribuição de Poisson com parâmetro \( \lambda T \), ou seja, \( N_T \sim \text{Poisson}(\lambda T) \).
Para calcular \( \mathbf{E}(T_R) \), utilizamos a propriedade da esperança condicional:
Primeiro, determinamos \( \mathbf{E}(T_R \mid T) \). Dado que o tempo de descarga sem interrupções é \( T \) e ocorrem \( N_T = n \) avarias, o tempo real de descarga é:
Assim, a esperança condicional é:
Podemos separar a soma em duas partes:
Sabemos que:
\(\sum _{n=0}^{\infty } \P (N_T = n) = 1\), pois é a soma das probabilidades de todas as possíveis quantidades de avarias.
\(\mathbf{E}[N_T \mid T] = \sum _{n=0}^{\infty } n \P (N_T = n) = \lambda T\), já que \( N_T \) é Poisson com média \( \lambda T \).
Portanto:
Agora, calculamos \( \mathbf{E}(T_R) \):
Como \( T \) é uma variável aleatória uniforme em \( [a, b] \), seu valor esperado é:
Substituindo, obtemos o tempo médio real de descarga:
O tempo médio real de descarga do trem é o tempo médio sem interrupções, \( \frac{a + b}{2} \), ajustado pelo fator \( (1 + d \lambda ) \), que representa o impacto médio das avarias da grua no processo de descarga.
Três máquinas estão nas posições \(0\), \(1\) e \(2\) metros de uma linha. A cada chamado, qualquer uma delas pode falhar com probabilidade \(1/3\), independentemente da máquina atendida no chamado anterior. Um trabalhador compara duas estratégias:
permanecer na máquina que acabou de reparar até o próximo chamado;
retornar sempre à posição central, \(1\), depois de cada reparo.
Se \(X\) é a distância percorrida entre dois chamados consecutivos, qual estratégia produz a menor distância média?
Estratégia 1 Sejam \(I\) e \(J\) as posições das máquinas nos dois chamados. Elas são independentes e uniformes em \(\{ 0,1,2\} \), e \(X=|I-J|\). Portanto,
Estratégia 2 Entre dois chamados, o trabalhador vai da posição central até a máquina \(J\) e retorna ao centro; assim, \(X=2|J-1|\). Logo,
Nesse modelo, a estratégia 1 é melhor: ela reduz a distância média de \(4/3\) para \(8/9\) de metro por intervalo entre chamados.
Considere uma sequência de tentativas independentes, nas quais cada tentativa possui uma probabilidade de sucesso \( p \). Denotemos por \( N \) o momento em que ocorre o primeiro sucesso. O objetivo é determinar a variância de \( N \), ou seja, \( \operatorname {Var}(N) \), sendo \(N\) uma geométrica.
Sol Para abordar a questão, consideremos uma variável indicadora \( Y \) definida da seguinte forma:
\( Y = 1 \) se a primeira tentativa resultar em sucesso (neste caso, \( N = 1 \)),
\( Y = 0 \) caso contrário (neste caso, \( N \) será maior ou igual a 2).
A variância de \( N \) pode ser expressa pela seguinte fórmula:
Para calcular \( \mathbf{E}[N^{2}] \), utilizamos a lei da esperança condicional:
Agora, vamos considerar os dois casos possíveis para \( Y \):
Caso em que \( Y = 1 \) (a primeira tentativa é um sucesso): - Neste caso, temos \( N = 1 \), logo:
\[ \mathbf{E}[N^{2} \mid Y=1] = 1^{2} = 1. \]Caso em que \( Y = 0 \) (a primeira tentativa é um fracasso): Se a primeira tentativa falhar, já se passou uma tentativa sem sucesso. O número total de tentativas necessárias para o primeiro sucesso será igual a 1 (a tentativa falha) mais o número de tentativas adicionais necessárias até o primeiro sucesso, que também segue a mesma distribuição que \( N \). Assim, podemos expressar \( N \) como:
\[ N = 1 + N', \]onde \( N' \) é a variável aleatória que conta o número de tentativas até o primeiro sucesso após a primeira tentativa fracassada. Portanto, temos:
\[ \mathbf{E}[N^{2} \mid Y=0] = \mathbf{E}[(1 + N)^{2}]. \]
Com isso,
Como \(\mathbf{E}[N]=1 / p\) temos que
ou
Consequentemente,
O número de pessoas que embarcaram num ônibus é uma variável aleatória de Poisson com média \( \mu = 5 \). Um ônibus passa por \( N = 10 \) pontos, e cada passageiro tem a mesma probabilidade de descer em qualquer um dos \( N \) pontos, independentemente de onde os outros passageiros descem. Calcule o número esperado de paradas que o ônibus fará antes que todos os passageiros desembarquem.
Sol Seja \( X \) o número de pessoas esperando no ponto de ônibus. Assim, \( X \sim \text{Poisson}(5) \). Seja \( Y \) o número de pontos nos quais o ônibus para para desembarcar passageiros. (\( X \) e \( Y \) são variáveis aleatórias.)
A função de probabilidade de \(X\) é
Seja \( Y_i \) uma variável aleatória indicadora, onde \( Y_i = 1 \) se o ônibus para no \( i \)-ésimo ponto, e \( Y_i = 0 \) caso contrário.
Pela linearidade da esperança:
Finalmente, juntando tudo:
Variância condicional
Podemos provar que essa fórmula é válida começando pela definição de variância e utilizando a fórmula da expectativa condicional duas vezes:
Na equação intermediária, adicionamos e subtraímos o termo necessário para reorganizar como expectativa e variância.
Seja \( N \) o número de clientes que visitam uma determinada cafeteria em um dia. Suponha que conhecemos \( \mathbf{E}[N] \) e \( \operatorname {Var}(N) \). Seja \( X_i \) o valor médio que o \( i \)-ésimo cliente gasta. Admitimos que os \( X_i \)’s são independentes entre si e também independentes de \( N \). Assumimos ainda que possuem a mesma média e variância:
Seja \( Y \) o total de vendas da loja, ou seja,
Determine \( \mathbf{E}[Y] \) e \( \operatorname {Var}(Y) \).
Sol Para encontrar \( \mathbf{E}[Y] \), não podemos utilizar diretamente a linearidade da expectativa, pois \( N \) é aleatório. No entanto, condicionado a \( N = n \), podemos aplicar a linearidade e encontrar \( \mathbf{E}[Y \mid N = n] \). Assim, utilizamos a lei da expectativa iterada:
Substituímos \( Y \) pela soma condicional:
Pela linearidade da expectativa:
Como \( X_i \)’s são independentes de \( N \):
Substituímos \( \mathbf{E}[X_i] = \mathbf{E}[X] \):
Como \( \mathbf{E}[X] \) é constante:
Para encontrar \( \operatorname {Var}(Y) \), utilizamos a lei da variância total:
Sabemos que:
Calculando os termos:
Portanto:
Uma máquina em uma fábrica produz chips de computador. Cada chip possui uma probabilidade \(\theta \) de ser defeituoso, e os chips são produzidos de forma independente, ou seja, a probabilidade de um chip ser defeituoso não depende do status dos outros chips. Suponha que a máquina produza 100 chips por dia. Toda manhã, quando a máquina é ligada, há um valor diferente de \(\theta \). De fato, \(\theta \) é uma variável aleatória que segue uma distribuição Beta(1,4). Se \(Y\) representa o número de defeituosos produzidos em um dia escolhido aleatoriamente, qual é o valor esperado de \(Y\)?
Sol Não precisamos calcular a função de probabilidade de \(Y\). Como \(Y\mid \theta \sim \operatorname {Bin}(100,\theta )\), usamos
pois o valor esperado de \(\theta \) é \(1/5\).
Qual é o desvio padrão do número de defeituosos produzidos em um dia escolhido aleatoriamente? Usando a fórmula para a variância, temos:
Portanto, o desvio padrão do número de defeituosos é aproximadamente \(16.7\).
8.5 Momentos
A média e a variância envolvem \(X\) e \(X^2\). Os momentos estendem esse estudo a outras potências e descrevem, quando existem, diferentes aspectos da forma de uma distribuição.
Seja \( X \) uma variável aleatória. Para \( k = 1, 2, \dots \), o momento de ordem \( k \) da variável \( X \) é definido como:
desde que esta quantidade seja finita. O momento de ordem \( 1 \), \( \mathbf{E}[X] \), é a média da variável aleatória.
Se \(X\) é integrável e \(\mu =\mathbf{E}[X]\), definimos o momento central de ordem \(k\) como
desde que essa quantidade também exista. Este momento descreve a dispersão e outras propriedades da variável ao redor de sua média.
De forma semelhante, o momento absoluto de ordem \( k \) é dado por:
Considere \( X \sim \text{Gama}(\alpha , \beta ) \). Vamos calcular os momentos de ordem \( k \) desta variável.
Simplificando:
Utilizando a definição da função Gama:
Escrevendo o resultado como produto de fatores sucessivos e usando a propriedadeque
temos:
Se \( \alpha = 1 \), \( X \) segue uma distribuição Exponencial com parâmetro \( \beta \). Nesse caso:
Assim, os momentos podem ser obtidos de forma simples para este caso específico.
Seja a função densidade de probabilidade da variável aleatória normal dada por:
onde a média é \(0\) e \(\sigma ^2\gt 0\) é a variância.
Os momentos da distribuição normal são definidos como:
onde \(f(x)\) é a densidade fornecida em (8.23).
Mostraremos que os momentos de ordem \(n\) da variável normal são:
Os momentos de ordem ímpar (\(n = 2k + 1\)) são iguais a zero devido à simetria da distribuição normal em torno da média zero. Como \(f(-x) = f(x)\) e \(x^{2k+1}\) é uma função ímpar, a integral sobre todo o eixo real é zero:
Para os momentos pares, é mais simples usar uma recorrência por integração por partes. A normalização da densidade equivale à identidade
Para \(k\geq 1\), tome \(u=x^{2k-1}\) e \(dv=x e^{-x^2/(2\sigma ^2)}\, dx\). Como \(v=-\sigma ^2e^{-x^2/(2\sigma ^2)}\) e o termo de fronteira é zero,
Partindo de \(\mathbf{E}[X^0]=1\), a recorrência fornece
Isso confirma a segunda parte de (8.24).
8.6 Funções geradoras de momento
A função geradora de momentos reúne os momentos em uma única função e permite recuperá-los por derivação. Além disso, transforma o estudo de somas de variáveis independentes no cálculo de produtos de funções geradoras.
A função geradora de momentos de \(X\) é
desde que essa esperança seja finita para todo \(t\) em algum intervalo \((-h,h)\), com \(h\gt 0\).
Além disso, quando existe em um intervalo ao redor de zero, \(M_X\) determina a distribuição de \(X\). Para somas de variáveis independentes, a função geradora da soma é o produto das funções geradoras individuais. Essas duas propriedades tornam a ferramenta especialmente eficiente para identificar distribuições de somas.
As fórmulas de cálculo seguem diretamente da definição de esperança:
Se \(X\) possui função geradora de momentos em um intervalo aberto que contém zero, então
Avaliando em \(t=0\), obtemos
Se \(X\) é uma variável aleatória binomial com parâmetros \(n\) e \(p\), então
onde a última igualdade resulta do teorema binomial. Calculando a derivada, obtemos
Assim,
Calculando a derivada segunda, obtemos
então
A variância de \(X\) é dada por
o que verifica o resultado obtido anteriormente.
Se \(X\) é uma variável aleatória de Poisson com parâmetro \(\lambda \), então
Calculando a derivada, obtemos
Assim,
Portanto, a média e a variância de uma variável aleatória de Poisson são iguais a \(\lambda \).
Observamos dessa dedução que, para a distribuição exponencial, \(\mathrm{M}(t)\) é definida apenas para valores de \(t\) menores que \(\lambda \). Calculando a derivada de \(\mathrm{M}(t)\), obtemos
Portanto,
A variância de \(X\) é dada por
O teorema anterior afirma que, se duas variáveis aleatórias \( X \) e \( Y \) têm a mesma função geradora de momento, isto é, \( M_X(t) = M_Y(t) \) para todos os \( t \) em um intervalo ao redor de \( 0 \), então elas têm a mesma distribuição de probabilidade. Assim por exemplo uma variável \(X\) tal que \(M_X(t)=e^{ \lambda \left(e^{t}-1\right) }\) é uma variável de Poisson de taxa \(\lambda \).
A função geradora de momentos de uma variável aleatória binomial também pode ser deduzida a partir da função geradora de uma Bernoulli. Se \( X \sim \operatorname {Bin}(n,p) \), então \( X \) é a soma de \( n \) variáveis independentes \( X_1, X_2, \ldots , X_n \), onde cada \( X_i \sim \operatorname {Bernoulli}(p) \).
Assim, temos:
Logo, a função geradora de momentos de \( X \sim \operatorname {Bin}(n,p) \) é:
Substituímos \( M_{X_i}(t) = 1 - p + p e^t \):
A função geradora de momento \(M_\zeta (t)\) é definida como:
onde \(f_\zeta (x)\) é a função densidade de probabilidade da distribuição normal:
Substituindo \(f_\zeta (x)\) na expressão de \(M_\zeta (t)\):
Agora, combinamos os expoentes:
Expansão do quadrado e rearranjo dos termos:
Completando o quadrado:
Calculando \( (\mu + \sigma ^2 t)^2 - \mu ^2 \):
Portanto, o expoente torna-se:
Substituindo de volta na integral:
Reconhecemos que a integral é a integral da função densidade de uma distribuição normal com média \(\mu + \sigma ^2 t\) e variância \(\sigma ^2\), portanto:
Assim, simplificando:
Para demonstrar que \(\zeta = \zeta _1 + \zeta _2\) segue uma distribuição normal com média \(\mu = \mu _1 + \mu _2\) e variância \(\sigma ^2 = \sigma _1^2 + \sigma _2^2\), utilizaremos a propriedade da função geradora de momento. A função geradora de momento de uma variável aleatória \(\zeta \) é definida por
Primeiramente, lembramos que a função geradora de momento de uma variável normal \(\zeta _i \sim \mathcal{N}(\mu _i, \sigma _i^2)\) é dada por
Como \(\zeta _1\) e \(\zeta _2\) são independentes, a função geradora de momento da soma \(\zeta = \zeta _1 + \zeta _2\) é o produto das FGMs individuais:
Substituindo as expressões das FGMs:
Observamos que \(M_{\zeta }(t)\) é a função geradora de momento de uma variável normal com média \(\mu = \mu _1 + \mu _2\) e variância \(\sigma ^2 = \sigma _1^2 + \sigma _2^2\), pois a função geradora de momento de uma variável normal \(\mathcal{N}(\mu , \sigma ^2)\) é
Como as funções geradoras são finitas em um intervalo ao redor de zero e coincidem nesse intervalo, o teorema de unicidade permite concluir que \(\zeta \) segue uma distribuição normal com os parâmetros desejados:
A soma de variáveis normais independentes permanece na família normal, com média igual à soma das médias e variância igual à soma das variâncias. Assim, a combinação de erros normais independentes pode ser estudada por meio de uma única distribuição normal, como no exemplo seguinte.
Suponha que duas máquinas produzam peças com dimensões que seguem distribuições normais independentes: a primeira com média \(\mu _1 = 10\) cm e desvio padrão \(\sigma _1 = 0{,}2\) cm, e a segunda com média \(\mu _2 = 15\) cm e desvio padrão \(\sigma _2 = 0{,}3\) cm. A soma das dimensões das peças produzidas por ambas as máquinas será uma variável normal com média \(\mu = 10 + 15 = 25\) cm e desvio padrão \(\sigma = \sqrt{0{,}2^2 + 0{,}3^2} \approx 0{,}3606\) cm.
| \multicolumn{1}{|c|}{ Distribuição } | Função geradora de momento $\M_X(t)$ |
|---|---|
| Degenerada $\delta_a$ | $e^{t a}$ |
| Bernoulli $\P(X=1)=p$ | $1-p+p e^t$ |
| Geométrica $(1-p)^{k-1} p$ | $\frac{p}{1-(1-p) e^t}, t<-\ln (1-p)$ |
| Binomial $B(n, p)$ | $\left(1-p+p e^t\right)^n$ |
| Binomial negativa $\mathrm{NB}(r, p)$ | $\left(\frac{p}{1-e^t+p e^t}\right)^r, t<-\ln (1-p)$ |
| Poisson Pois( $\lambda)$ | $e^{\lambda\left(e^t-1\right)}$ |
| Uniforme (contínua) $\mathrm{U}(a, b)$ | $\frac{e^{t b}-e^{t a}}{t(b-a)}$ |
| Uniforme (discreta) $\mathrm{DU}(a, b)$ | $\frac{e^{a t}-e^{(b+1) t}}{(b-a+1)\left(1-e^t\right)}$ |
| Normal $N\left(\mu, \sigma^2\right)$ | $e^{t \mu+\frac{1}{2} \sigma^2 t^2}$ |
| Gama $\operatorname{Gama}(\alpha,\beta)$ (taxa) | $\left(\frac{\beta}{\beta-t}\right)^{\alpha},\ t<\beta$ |
| Exponencial $\operatorname{Exp}(\lambda)$ | $\left(1-t \lambda^{-1}\right)^{-1}, t<\lambda$ |
8.7 Exemplos integradores
A força da esperança aparece com mais clareza quando a distribuição completa da variável de interesse é difícil, mas sua decomposição em partes simples é fácil. Indicadores resolvem contagens combinatórias; variância e covariância organizam fontes de ruído; e modelos mistos surgem naturalmente em aplicações.
Em \(G(n,p)\), seja \(M\) o número total de arestas. Se \(I_e\) indica a presença da aresta \(e\),
e portanto
Para triângulos, seja \(T\) a quantidade de subconjuntos de três vértices que formam um triângulo. Se \(J_A\) indica que as três arestas do conjunto \(A\in \binom {[n]}3\) estão presentes,
Como \(\mathbf{E}[J_A]=p^3\),
A distribuição de \(T\) é bem menos simples que a de \(M\), mas sua média continua saindo em uma linha.
8.8 Uma visão unificada da esperança
Até aqui, calculamos esperança por duas fórmulas que parecem pertencer a mundos diferentes. Para uma variável aleatória discreta, somamos valores ponderados por probabilidades; para uma variável com densidade, integramos valores ponderados pela densidade:
Essas fórmulas atendem à maior parte dos problemas estudados. Há, porém, variáveis cuja distribuição possui uma parte discreta e uma parte contínua. O estudo desses casos conduz a uma definição que reúne as duas formas de calcular a esperança.
Em vez de partir da forma da distribuição de \(X\), consideramos os eventos em que \(X\) assume determinados valores. Essa abordagem conduz à integral de Lebesgue com respeito à probabilidade. Sem desenvolver uma teoria geral de integração, apresentaremos a construção que unifica os cálculos de esperança utilizados no capítulo.
Quando soma e integral aparecem juntas
Considere o tempo \(X\), em milissegundos, necessário para responder a uma requisição. Com probabilidade \(1/4\), a resposta vem de um cache e leva exatamente \(1\) ms. Nos demais \(3/4\) dos casos, a requisição é processada pelo servidor e o tempo é uniforme no intervalo \([2,6]\).
A distribuição de \(X\) não é discreta: ela assume um contínuo de valores entre \(2\) e \(6\). Também não é puramente contínua, porque
A parte contínua tem densidade
pois sua massa total deve ser \(3/4\). O valor esperado é, portanto,
A soma registra a contribuição do átomo em \(1\), e a integral, a da parte contínua. Para justificar o uso conjunto dessas duas operações, convém examinar a definição de esperança no espaço amostral.
Não é necessária uma definição especial para distribuições mistas. A soma e a integral usuais são formas de uma mesma operação: integrar a variável aleatória em relação à probabilidade do espaço amostral.
Para chegar a essa fórmula, começaremos pelo objeto mais simples possível.
Indicadoras e variáveis simples
Se \(A\) é um evento, sua função indicadora vale \(1\) quando \(A\) ocorre e \(0\) caso contrário. Assim,
A esperança de \(\mathbb {1}_A\) já foi usada várias vezes neste capítulo:
Essa identidade relaciona eventos e esperanças: a indicadora associa uma variável aleatória ao evento, e sua esperança é a probabilidade desse evento.
Agora suponha que \(X\) assuma apenas os valores \(a_1,\ldots ,a_n\). Se
então os eventos \(A_1,\ldots ,A_n\) formam uma partição do espaço amostral e podemos escrever
Uma variável dessa forma é chamada variável aleatória simples. Para ela, a definição natural é
É exatamente a média ponderada que já conhecemos. O ponto novo é que o peso não está associado, em primeiro lugar, a um ponto da reta: ele está associado a um conjunto de resultados \(A_i\subseteq \Omega \).
Essa formulação permite aproximar variáveis gerais por variáveis simples, sem distinguir, a cada etapa, entre distribuições discretas, contínuas ou mistas.
Riemann e Lebesgue: duas maneiras de organizar a aproximação
A integral de Riemann, familiar do cálculo, aproxima a área sob uma curva dividindo o eixo horizontal. Em cada pequeno intervalo do domínio, escolhemos uma altura e construímos um retângulo. Refinar a partição significa tornar os intervalos cada vez menores.
A construção de Lebesgue pode ser vista de outra maneira. Em vez de organizar a aproximação principalmente por onde estamos no domínio, organizamos os pontos de acordo com os valores assumidos pela função. Escolhemos níveis \(y_0\lt y_1\lt \cdots \lt y_m\) e agrupamos os pontos para os quais a função cai em cada faixa de alturas. Esses grupos podem ser bastante irregulares no domínio; o que importa é o tamanho que a probabilidade atribui a cada um deles.
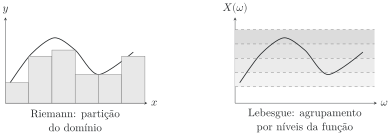
No contexto probabilístico, os pesos dessas faixas são dados pelas suas probabilidades. Se uma aproximação de \(X\) assume os valores \(a_1,\ldots ,a_n\) nos eventos \(A_1,\ldots ,A_n\), sua contribuição média é
Ou seja, a soma de Lebesgue para a esperança já apareceu na Equação (8.27). O que muda ao passar para uma variável geral é que refinamos essas faixas de valores e tomamos um limite.
Há uma diferença conceitual importante em relação ao cálculo usual. O espaço \(\Omega \) pode nem sequer ser um intervalo da reta. Pode ser um conjunto de sequências, trajetórias, configurações ou qualquer outro espaço amostral. Ainda assim, faz sentido perguntar qual é a probabilidade do conjunto em que \(X\) fica entre dois níveis. É essa possibilidade que torna a integral com respeito a \(\P \) tão adequada à probabilidade.
De variáveis simples a variáveis gerais
Suponha primeiro que \(X\geq 0\). Podemos construir variáveis simples
que se aproximam de \(X\) por baixo e cujos degraus ficam progressivamente mais finos. Escrevemos
Cada \(X_n\) possui uma esperança definida pela soma (8.27). A ideia de Lebesgue é definir
Para uma variável não negativa, esse limite pode ser finito ou infinito. A teoria garante que o valor obtido não depende da sequência particular de degraus usada para aproximar \(X\), desde que a aproximação crescente seja feita da maneira adequada.
É útil comparar esse procedimento com uma imagem conhecida. Na integral de Riemann, aproximamos uma curva por retângulos cada vez mais estreitos. Aqui, aproximamos uma variável aleatória por funções em degraus cada vez mais precisas. Em ambos os casos, a quantidade procurada surge como limite de objetos elementares; o que muda é a forma de organizar esses objetos.
Para uma variável que pode assumir valores positivos e negativos, separamos as duas partes:
Então
Se \(\mathbf{E}[X^+]\) e \(\mathbf{E}[X^-]\) são finitas — de modo equivalente, se \(\mathbf{E}[|X|]\lt \infty \) — dizemos que \(X\) é integrável e definimos
A notação \(\int _\Omega X\, d\P \) enfatiza que estamos integrando os valores de \(X\) usando a probabilidade como regra para pesar conjuntos do espaço amostral. É essa a integral de Lebesgue que aparece naturalmente na teoria da probabilidade.
Essa definição inclui tanto as somas quanto as integrais em \(dx\). Quando conhecemos a distribuição de \(X\), podemos expressá-la nas formas concretas utilizadas ao longo do capítulo.
Uma fórmula, três regimes
No caso discreto, os eventos
particionam o espaço amostral. Aplicando a definição para variáveis simples — e depois passando ao limite quando há infinitos valores possíveis — obtemos
A soma usual é, portanto, a expressão da integral quando a distribuição está concentrada em pontos.
Se \(X\) possui densidade \(f_X\), a probabilidade é distribuída ao longo da reta segundo essa densidade. Nesse caso,
É a fórmula contínua que usamos desde o início do capítulo.
Finalmente, considere uma distribuição mista regular com átomos \(x_1,x_2,\ldots \), de massas
e uma parte contínua descrita por uma densidade \(f\). A massa total satisfaz
e a mesma integral abstrata fornece
sempre que as contribuições envolvidas forem integráveis. A fórmula usada no exemplo do cache aparece, portanto, sem que precisemos criar uma nova noção de esperança para o caso misto.
Podemos resumir a situação assim:
As três linhas são manifestações da mesma identidade:
Nos cálculos, usamos a forma mais conveniente: uma soma, uma integral ordinária ou uma combinação das duas. A definição unificada mostra que todas expressam a mesma construção: aproximar a variável por variáveis simples, ponderar os conjuntos correspondentes por suas probabilidades e passar ao limite.
8.9 Exercícios