Martingais
Esse caminho levará às probabilidades de saída, às durações médias e à identidade de Wald. Em cada aplicação, será preciso verificar quando uma identidade válida em tempos fixos continua válida no instante aleatório da parada. As seções opcionais retomam essas ideias no controle de falsos positivos em testes sequenciais e na seleção de caminhos em modelos de reforço.
7.1 Esperança condicional: da partição à informação
Um dado equilibrado foi lançado, mas alguém revela apenas se o resultado está em \(A_1=\{ 1,2\} \), \(A_2=\{ 3,4\} \) ou \(A_3=\{ 5,6\} \). Que valor devemos prever para o resultado \(Y\)?
Para uma variável integrável \(Y\) e um evento \(A\), escrevemos \(E(Y;A)=E(Y\mathbf1_A)\). Se \(\mathbb P(A)\gt 0\), a média de \(Y\) entre os resultados que pertencem a \(A\) é o número
Agora considere uma partição \(A_1,\ldots ,A_k\) do espaço de resultados. Se a informação \(\mathcal G\) revela em qual dessas partes estamos, a previsão deixa de ser um único número: seu valor depende da parte revelada. Definimos
Nas partes de probabilidade zero podemos atribuir qualquer valor finito.
A fórmula tem uma propriedade que explica por que é a previsão adequada: em cada parte \(A_i\), ela preserva a média de \(Y\). De fato,
O mesmo vale para qualquer união dessas partes: basta somar as igualdades. Assim, a previsão usa as distinções permitidas pela informação, sem distinguir resultados dentro de uma mesma parte.
Usaremos letras como \(\mathcal G\) e \(\mathcal H\) para representar informações e escreveremos \(\mathcal H\preceq \mathcal G\) quando \(\mathcal G\) revela tudo o que já era conhecido em \(\mathcal H\). Se a informação distingue uma quantidade enumerável de histórias, a mesma definição vale, com uma soma enumerável sobre partes de probabilidade positiva. Nesse caso, \(E|Y|\lt \infty \) garante a convergência absoluta das médias ponderadas.
Há uma segunda situação recorrente: o passado pode conter valores reais, mas a próxima variável aleatória \(\xi \) é independente dele. Nesse caso, mantemos fixa a história e fazemos a média apenas sobre o novo incremento. Por exemplo, se \(S_n\) é conhecido e \(E\xi _{n+1}=\mu \), com \(\xi _{n+1}\) independente de todo o passado, então
Isso é apenas a média de uma soma com uma parcela conhecida e outra independente. Para funções mais gerais dos incrementos, usaremos do mesmo modo somas ou integrais usuais de uma variável.
Esse tratamento por histórias enumeráveis e novos incrementos independentes é suficiente para os modelos deste capítulo. Não pretendemos aqui desenvolver a definição de esperança condicional para informações completamente gerais. Todas as igualdades e desigualdades entre previsões condicionais são entendidas quase certamente.
Comecemos por uma partição \(\{ A_i\} \) que descreve \(\mathcal G\). Nesta demonstração, omitimos das somas as partes de probabilidade zero, que não contribuem para nenhuma esperança. Em cada parte de probabilidade positiva, a esperança condicional é uma média usual. Assim, a linearidade decorre de
Multiplicar cada média por \(\mathbb P(A_i)\) e somar fornece \(E(E(Y\mid \mathcal G))=\sum _i E(Y;A_i)=E(Y)\).
Para a propriedade da torre, seja \(B\) uma parte de probabilidade positiva da partição que descreve \(\mathcal H\). Como \(\mathcal H\preceq \mathcal G\), ela é união de partes \(A_i\). Logo,
Dividir por \(\mathbb P(B)\) prova a identidade em cada parte de \(\mathcal H\). A integrabilidade de \(Y\) garante a convergência absoluta das somas, pois \(\sum _i|E(Y;A_i)|\leq E|Y|\).
Se \(X\) é determinado por \(\mathcal G\), ele assume algum valor constante \(x_i\) em cada parte \(A_i\). Por isso,
e, ao dividir por \(\mathbb P(A_i)\), obtemos \(E(XY\mid \mathcal G)=XE(Y\mid \mathcal G)\). Não estamos supondo que \(X\) seja limitado. Para conferir que a expressão do lado direito é integrável, observe que
A independência, por sua vez, dá \(E(Y;A_i)=E(Y)\mathbb P(A_i)\), de onde \(E(Y\mid \mathcal G)=E(Y)\). A ordem \(Y\leq Z\) é preservada ao tomar médias em cada parte. Finalmente, a desigualdade triangular dá
que é a última regra.
Isso demonstra as propriedades quando a informação é descrita por uma partição finita ou enumerável. Para informações produzidas por históricos de valores reais, admitiremos essas mesmas propriedades nas situações usadas no livro, juntamente com a regra da Observação 7.1. Continuaremos a manter fixa a história e integrar somente o novo incremento. A demonstração por partições, contudo, não constitui uma demonstração desse caso mais geral.
7.2 Filtrações e informação
Ao acompanhar um processo, reunimos as observações feitas até cada instante. Para formular quais decisões podem usar essas observações, precisamos registrar como a informação se acumula.
A relação \(\mathcal F_n\preceq \mathcal F_{n+1}\) diz que, ao avançar um passo, podemos aprender algo novo, mas não esquecemos o que já era conhecido.
A condição \(E|M_n|\lt \infty \) garante que as previsões condicionais sejam integráveis e que possamos tomar suas médias. Sem esse controle, as expressões poderiam envolver diferenças indefinidas, como \(\infty -\infty \).
Condicionada à informação disponível em \(n\), a média do incremento \(M_{n+1}-M_n\) é zero em um martingal, não negativa em um submartingal e não positiva em um supermartingal. Os prefixos podem parecer invertidos à primeira leitura: em um submartingal, o valor atual fica abaixo da previsão do próximo valor; em um supermartingal, fica acima. Eles descrevem essa desigualdade, não a qualidade do jogo.
Propriedades básicas Se \((M_n)\) e \((N_n)\) são martingais relativamente à mesma filtração e \(a,b\in \mathbb R\), então \((aM_n+bN_n)\) é um martingal. Além disso, para \(m\leq n\),
Para submartingais, \(E(M_n)\) é não decrescente; para supermartingais, é não crescente.
Primeiro, \(aM_n+bN_n\) é adaptado à filtração comum e integrável, pois
Pela linearidade da esperança condicional,
o que verifica todas as condições de martingal. Na segunda afirmação, o caso \(m=n\) é imediato, pois \(M_n\) já é determinado por \(\mathcal F_n\). Se \(m\lt n\), aplicamos repetidamente a propriedade da torre:
Tomando esperanças, obtemos \(E(M_n)=E(M_m)\) e, em particular, \(E(M_n)=E(M_0)\). Para um submartingal, a preservação da ordem e a propriedade da torre dão
Iterar essa desigualdade prova a monotonicidade anunciada. Para um supermartingal, o mesmo cálculo tem a desigualdade invertida.
7.3 Exemplos
Nos exemplos a seguir, a filtração natural contém tudo o que foi observado até o instante \(n\). Para verificar a propriedade de martingal, separaremos a parte já conhecida do próximo incremento e calcularemos sua média condicional. Essa mesma operação aparecerá em formas distintas: retirar uma deriva, compensar o crescimento de um quadrado ou normalizar um produto.
O valor de \(M_n\) depende somente dos incrementos já observados, logo é adaptado. A soma finita de incrementos integráveis garante a integrabilidade, com a estimativa
Como \(\xi _{n+1}\) é independente da história até \(n\), temos
Como \(M_n\) é conhecido em \(\mathcal F_n\), a igualdade acima equivale a \(E(M_{n+1}\mid \mathcal F_n)=M_n\). Para o processo sem compensação,
Se \(\mu \leq 0\), o lado direito é no máximo \(S_n\); se \(\mu \geq 0\), é no mínimo \(S_n\). Isso prova as duas classificações.
Sejam \(\xi _1,\xi _2,\ldots \) i.i.d., com \(E(\xi _i)=0\) e \(E(\xi _i^2)=\sigma ^2\lt \infty \). Para \(S_n=S_0+\xi _1+\cdots +\xi _n\), com \(S_0\) constante, o processo
é um martingal em relação à filtração natural.
A soma tem segundo momento finito, de modo que \(M_n\) é integrável e adaptado. Para calcular o próximo incremento, expandimos o quadrado:
Condicionando por \(\mathcal F_n\),
Na primeira parcela, \(S_n\) pode sair do condicionamento porque já é conhecido; a média de \(\xi _{n+1}\) é zero pela independência. A segunda parcela tem média \(\sigma ^2\), que é cancelada pela compensação. Assim, a esperança condicional do incremento é zero, como exige a definição. A correção \(n\sigma ^2\) retira exatamente o crescimento médio de \(S_n^2\).
O produto depende somente de \(X_1,\ldots ,X_n\) e, portanto, é adaptado. A não negatividade permite calcular a esperança absoluta como a própria esperança. Pela independência dos fatores,
Além disso, \(X_{n+1}\) é independente da informação \(\mathcal F_n\), de modo que \(E(X_{n+1}\mid \mathcal F_n)=1\). Consequentemente,
Esse tipo de modelo é natural quando as variações são proporcionais ao valor atual, como em modelos financeiros multiplicativos. A não negatividade dos fatores também impede preços negativos.
Sejam \(\xi _1,\xi _2,\ldots \) i.i.d. e suponha que
Para \(S_n=S_0+\xi _1+\cdots +\xi _n\), com \(S_0\) constante, o processo
é um martingal. Em particular, se \(\varphi (\theta )=1\), então \(e^{\theta S_n}\) é um martingal.
Como \(e^{\theta \xi _1}\gt 0\), temos \(0\lt \varphi (\theta )\lt \infty \). Tome os fatores \(X_i=e^{\theta \xi _i}/\varphi (\theta )\) e \(M_0=e^{\theta S_0}\). Eles são independentes, não negativos e satisfazem
Além disso,
O exemplo anterior fornece adaptação, integrabilidade e a identidade condicional de martingal. Se \(\varphi (\theta )=1\), o denominador simplesmente desaparece.
Sejam \(\xi _1,\xi _2,\ldots \) independentes, com
onde \(p\in (0,1)\) e \(p\ne 1/2\). Para \(S_n=S_0+\xi _1+\cdots +\xi _n\),
é um martingal, com \(S_0\) constante.
Para verificar, escolha \(\theta \) de modo que \(e^\theta =(1-p)/p\). Então
O resultado segue do Exemplo 7.6, pois \(e^{\theta S_n}=((1-p)/p)^{S_n}\). A escolha de \(\theta \) faz a contribuição média de um passo positivo e a de um passo negativo somarem um; por isso, a multiplicação por esse novo fator preserva a média condicional da potência.
Nos exemplos anteriores, escolhemos funções da caminhada para compensar sua evolução média. Para uma cadeia de Markov, a mesma ideia se expressa pela comparação entre o valor atual de uma função e sua média após um passo.
Funções super-harmônicas Seja \((X_n)\) uma cadeia de Markov em \(S\), com matriz de transição \(P\), e \(f:S\times \mathbb N_0\to \mathbb R\). Suponha que \(f(X_n,n)\) seja integrável em cada \(n\), que \(\sum _yp(x,y)|f(y,n+1)|\lt \infty \) e que
para todo \(x,n\). Então \(M_n=f(X_n,n)\) é um supermartingal em relação à filtração natural de \(X\). Se a desigualdade é invertida, obtemos um submartingal; se vale a igualdade, obtemos um martingal.
Como \(f\) é determinística, \(f(X_n,n)\) é determinado pela história até \(n\) e o processo é adaptado. Sua integrabilidade é uma das hipóteses. Fixada uma história com \(X_n=x\), a propriedade de Markov diz que o próximo estado tem distribuição \(p(x,\cdot )\), independentemente dos estados anteriores. A convergência absoluta da soma, também assumida, permite calcular essa média. Portanto,
A desigualdade da hipótese foi aplicada ao estado aleatório \(X_n\). Juntamente com adaptação e integrabilidade, essa é exatamente a condição de supermartingal. Se a desigualdade da hipótese é invertida, a desigualdade condicional também se inverte; se há igualdade, a média condicional coincide com \(f(X_n,n)\), dando um martingal.
Os dois exemplos seguintes são úteis para estudar probabilidades de atingir conjuntos e tempos de saída.
Considere uma cadeia de Markov \((X_n)\) em um espaço finito \(S\). Para \(A\subset S\), seja
Se, para \(x\in S\setminus A\),
então \(h(X_{n\wedge H_A})\) é um supermartingal.
Torne absorventes os estados de \(A\). A nova cadeia coincide com \(X\) até a entrada e depois permanece no estado atingido, de modo que seu valor no instante \(n\) é \(X_{n\wedge H_A}\). Fora de \(A\), a desigualdade para \(h\) é a da hipótese; em \(A\), a transição é para o próprio estado e a média seguinte é exatamente \(h(x)\). Aplique, portanto, o Teorema 7.3 à cadeia absorvida.
Também podemos verificar a identidade diretamente na informação da cadeia original. Como \(\{ H_A\gt n\} \) já é conhecido em \(\mathcal F_n\),
Depois da entrada o incremento é zero; antes dela usamos a hipótese. O processo é adaptado, e a finitude de \(S\) limita \(|h|\) por uma constante, garantindo a integrabilidade em cada instante.
Nas condições do exemplo anterior, sejam \(g:S\to \mathbb R\) e \(\alpha \in \mathbb R\). Suponha que, para \(x\notin A\),
Então o processo
é um supermartingal em relação à filtração natural de \(X\).
Os dois termos precisam parar juntos: depois da chegada a \(A\), nem o estado observado nem o relógio acumulado mudam.
A variável \(Z_n\) depende somente de \(X_0,\ldots ,X_n\), pois \(H_A\) é uma parada. Assim, o processo é adaptado. Além disso,
portanto cada \(Z_n\) é integrável. No evento \(\{ H_A\leq n\} \), o incremento é zero. No evento \(\{ H_A\gt n\} \), a propriedade de Markov fornece
Isso prova a afirmação, inclusive quando a chegada ocorre no instante \(n+1\).
7.4 Estratégias de jogo e tempos de parada
Até aqui, construímos martingais escolhendo funções do estado ou dos incrementos. Agora estudaremos o que acontece quando usamos esses processos para decidir quanto apostar e quando interromper o jogo. Uma estratégia pode usar tudo o que aconteceu até agora, mas não pode escolher a aposta depois de ver o resultado da rodada. Essa restrição é o conteúdo da previsibilidade.
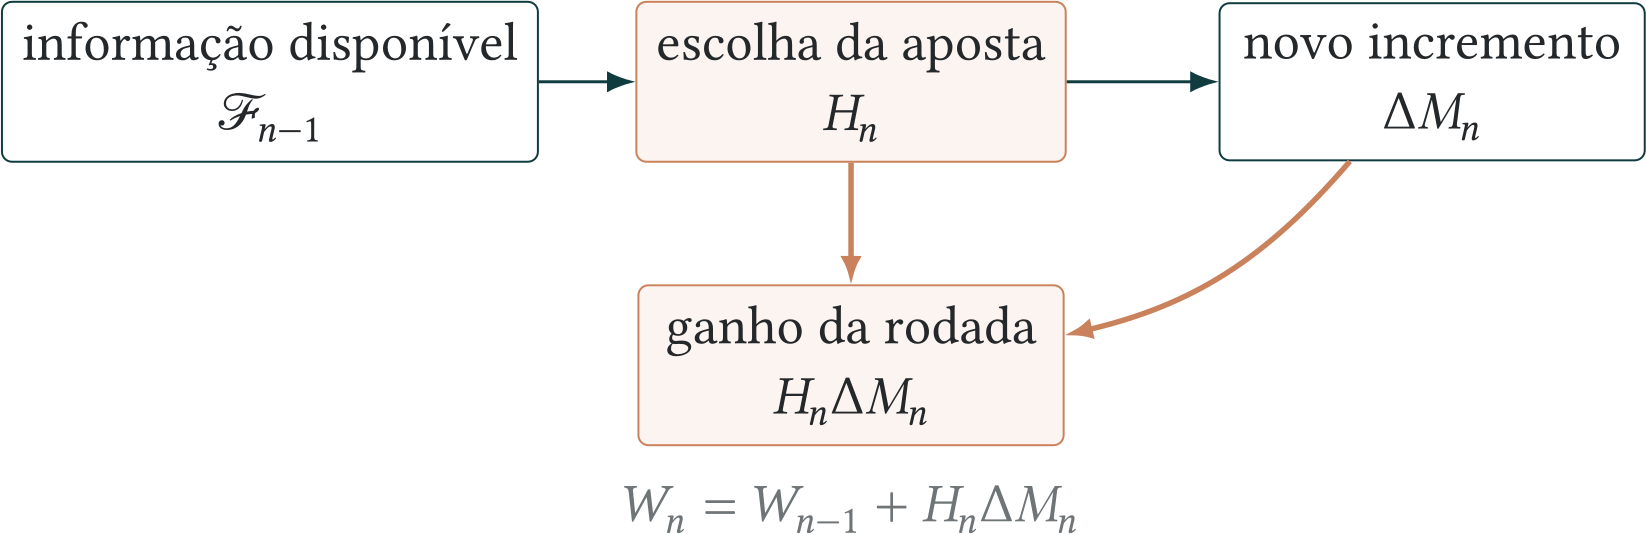
Se \(M_n\) representa o ganho acumulado por unidade apostada e \(H_n\) é a quantidade apostada na rodada \(n\), a riqueza resultante é
A soma acima é chamada de transformada de martingal. Cada parcela usa uma decisão tomada com a informação anterior.
Cada parcela até \(n\) depende apenas da informação disponível nesse instante, pois \(H_m\) é conhecido em \(m-1\) e \(M_m-M_{m-1}\) é conhecido em \(m\). Logo, \(V\) é adaptado.
No caso de supermartingal, a limitação de cada aposta dá
Como \(V_n\) contém apenas \(n\) parcelas, isso garante sua integrabilidade. No caso de martingal, a integrabilidade decorre da hipótese explícita sobre cada produto.
Para calcular a previsão do próximo ganho, escrevemos
A aposta \(H_{n+1}\) já está decidida com a informação \(\mathcal F_n\) e, portanto, pode sair da média condicional:
Se \(M\) é supermartingal, a média do incremento é não positiva. Como \(H_{n+1}\ge 0\), o produto também é não positivo. Se \(M\) é martingal, a média do incremento é zero, e o produto continua tendo média zero mesmo quando a aposta pode ser negativa. Isso prova as duas afirmações.
Para qualquer processo \(M\), escrevemos \(M^T_n=M_{T\wedge n}\) para o processo observado até \(T\) e congelado depois da parada. A Figura 7.2 mostra essa operação em uma realização.
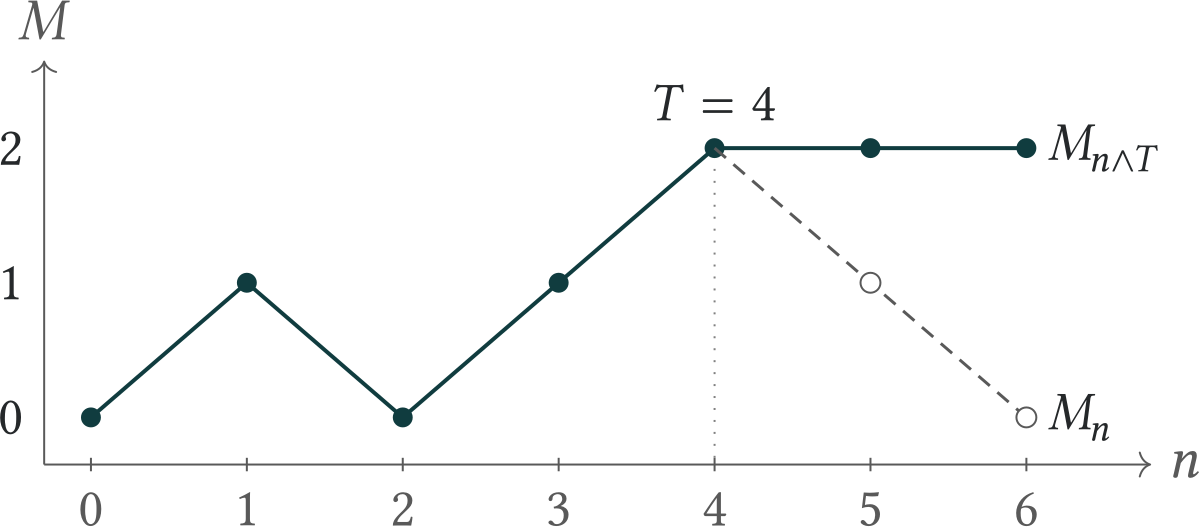
Processo parado Se \((M_n)\) é um martingal e \(T\) é um tempo de parada, então \((M_{T\wedge n})\) também é um martingal. A mesma afirmação vale para submartingais e supermartingais.
Ponha
No instante \(m-1\), já podemos decidir se \(T\leq m-1\) e, portanto, se \(T\geq m\). Assim, \(H_m\) é previsível e satisfaz \(0\leq H_m\leq 1\).
Para cada trajetória,
De fato, se \(T=k\leq n\), apenas os \(k\) primeiros incrementos entram na soma, que se reduz a \(M_0+(M_1-M_0)+\cdots +(M_k-M_{k-1})=M_k\). Se \(T\gt n\), entram todos os incrementos até \(n\) e a soma vale \(M_n\).
Logo, \(M_{T\wedge n}\) é a transformada de \(M\) pela estratégia que acompanha o processo até a parada. O Teorema 7.4 mostra que essa transformada é martingal se \(M\) é martingal e supermartingal se \(M\) é supermartingal. Para um submartingal, aplicamos o mesmo resultado ao supermartingal \(-M\) e trocamos os sinais.
O teorema garante \(E(M_{T\wedge n})=E(M_0)\) para todo \(n\). Passar ao limite e concluir \(E(M_T)=E(M_0)\) exige uma hipótese adicional; esse cuidado é essencial nas aplicações.
7.4.1 Convergência de martingais limitados
O controle das médias, por si só, não garante que uma sequência aleatória convirja. Para martingais, uma limitação uniforme dos valores impede oscilações persistentes. Vamos demonstrar primeiro uma desigualdade para contar quantas vezes uma trajetória atravessa um intervalo.
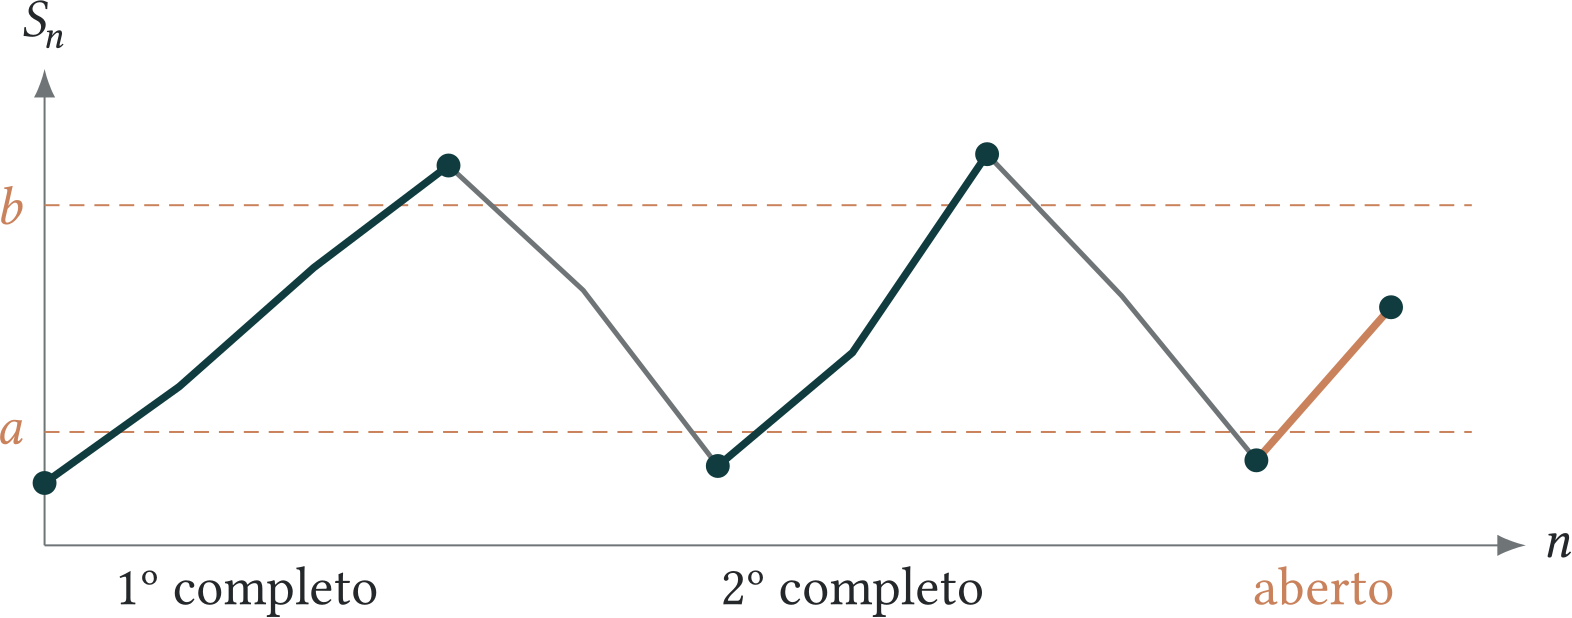
Considere a seguinte estratégia: quando a trajetória atinge um valor menor ou igual a \(a\), passamos a acompanhar uma unidade do processo; deixamos de acompanhá-la na primeira visita posterior a um valor maior ou igual a \(b\) e repetimos o procedimento. Se \(H_m\in \{ 0,1\} \) indica se estamos acompanhando o processo entre os instantes \(m-1\) e \(m\), então \(H_m\) é determinado pela história até \(m-1\). O ganho acumulado até \(N\) é
Como \(S\) é um supermartingal e \(H_m\geq 0\) é decidido antes do incremento,
Cada cruzamento completo rende pelo menos \(b-a\). No instante \(N\) pode restar, no máximo, um cruzamento aberto. Se ele começou em \(m_0\lt N\), com \(S_{m_0}\leq a\), seu ganho até o instante final é
Quando não há cruzamento aberto, a contribuição residual é zero. Portanto, trajetória por trajetória,
Todos os termos são integráveis: \(H_m\) é limitado e os incrementos são integráveis; além disso, \(U_N[a,b]\leq N\). Tomando esperanças e usando \(EG_N\leq 0\), obtemos
Por fim, \((a-S_N)^+\leq |a|+|S_N|\leq |a|+C\), o que prova a segunda desigualdade e a uniformidade da cota em \(N\).
Dizemos que \(M_n\) converge para \(M_\infty \) em média ou em \(L^1\) quando
Essa condição controla a magnitude média do erro, enquanto a convergência quase certa acompanha as trajetórias. Em geral, nenhuma dessas duas convergências implica a outra. No próximo teorema, a limitação uniforme permitirá concluir ambas.
Comece pelo submartingal \(M\) e ponha \(S_n=-M_n\). Então \(S\) é um supermartingal limitado. Fixe racionais \(a\lt b\) e escreva \(U_N[a,b]\) para o número de cruzamentos completos de \([a,b]\) por \(S\) até o instante \(N\). Como \(U_N[a,b]\) cresce com \(N\), existe o limite \(U_\infty [a,b]\in \mathbb N_0\cup \{ \infty \} \). Para cada inteiro \(k\geq 1\), a desigualdade de Markov e o lema anterior dão
Os eventos \(\{ U_N[a,b]\geq k\} \) crescem com \(N\). Pela continuidade das probabilidades, a mesma cota vale para \(\mathbb P(U_\infty [a,b]\geq k)\). Fazendo \(k\to \infty \), obtemos \(\mathbb P(U_\infty [a,b]=\infty )=0\). Há apenas uma quantidade enumerável de pares racionais \(a\lt b\), portanto, com probabilidade um, todos esses números de cruzamentos são finitos simultaneamente.
Agora considere uma trajetória nesse evento. Se
podemos escolher racionais \(a\lt b\) estritamente entre esses dois valores. A trajetória visita valores abaixo de \(a\) e valores acima de \(b\) arbitrariamente tarde. Escolhendo alternadamente uma visita abaixo de \(a\) e a primeira visita posterior acima de \(b\), obtemos infinitos cruzamentos completos de \([a,b]\), contradizendo \(U_\infty [a,b]\lt \infty \). Portanto, limite inferior e limite superior coincidem. Como \(|S_n|\leq C\), o limite é finito, e assim \(M_n=-S_n\) converge quase certamente para alguma variável \(M_\infty \) com \(|M_\infty |\leq C\).
Por fim, ponha \(D_n=|M_n-M_\infty |\). Temos \(0\leq D_n\leq 2C\) e \(D_n\to 0\) quase certamente. Para qualquer \(\varepsilon \gt 0\),
A probabilidade à direita tende a zero: os eventos \(\{ \sup _{m\geq N}D_m\gt \varepsilon \} \) decrescem para um evento de probabilidade zero. Portanto \(ED_n\to 0\), isto é, há convergência em \(L^1\). Para um supermartingal, aplicamos diretamente o mesmo argumento de cruzamentos; martingais são casos particulares de ambos.
7.5 Aplicações
Voltaremos às probabilidades de saída e às durações já estudadas por primeiro passo. Antes, precisamos distinguir duas afirmações: parar em \(T\wedge n\) conserva a média de um martingal; passar à identidade em \(T\) exige justificar o limite. A caminhada seguinte mostra por que a finitude quase certa da parada não basta.
Sejam \(\xi _1,\xi _2,\ldots \) independentes, com
e defina a caminhada aleatória simples simétrica \(S_n=1+\xi _1+\cdots +\xi _n\). Seja
A recorrência da caminhada, demonstrada anteriormente, implica \(\mathbb {P}_1(T\lt \infty )=1\). Portanto, \(S_T=0\) e
Isso não contradiz o Teorema 7.5, que trata de \(S_{T\wedge n}\), não diretamente de \(S_T\). Antes de atingir 0, a caminhada pode fazer excursões arbitrariamente altas.
Para \(m\geq 1\), escreva \(H_m=\inf \{ n\geq 0:S_n=m\} \). A fórmula da ruína do jogador, já demonstrada por primeiro passo no Capítulo 2, fornece
Se \(R=\max _{0\leq n\leq T}S_n\), então
A igualdade entre os eventos usados nessa soma merece atenção. Como os passos são de tamanho um, alcançar um máximo pelo menos \(m\) antes de chegar a zero equivale a visitar o nível \(m\) antes de \(T\). Além disso, \(T\) é finito quase certamente, de modo que esse máximo é finito em cada uma dessas trajetórias, embora tenha esperança infinita.
Se uma variável integrável dominasse todos os \(S_{T\wedge n}\), também dominaria seu supremo ao longo dos instantes inteiros, que é \(R\). Isso contradiz \(E(R)=\infty \). O exemplo distingue, assim, a finitude quase certa do máximo da integrabilidade desse máximo.
Para justificar as passagens ao limite nas próximas aplicações, usaremos duas regras que podem ser demonstradas com probabilidades de eventos e séries de caudas.
Na primeira afirmação, \(|Z|\leq Y\) quase certamente. Para \(D_n=|Z_n-Z|\), temos \(D_n\leq 2Y\). Dados \(K,\varepsilon \gt 0\),
Como \(D_n\to 0\) quase certamente, os eventos \(\{ \sup _{m\geq n}D_m\gt \varepsilon \} \) decrescem para um evento de probabilidade zero. Pela continuidade das probabilidades,
Logo, para \(K\) e \(\varepsilon \) fixos, o segundo termo da cota tende a zero. A cauda \(E(Y;Y\gt K)\) também tende a zero quando \(K\to \infty \), pois \(EY\lt \infty \). Isso se vê repartindo os valores de \(Y\) nos intervalos \([m,m+1)\): como \(m+1\le Y+1\) nesse intervalo,
As caudas dessa série tendem a zero e controlam \(E(Y;Y\gt K)\) quando \(K\) cresce. Fazendo primeiro \(n\to \infty \), depois \(K\to \infty \) e, por fim, \(\varepsilon \downarrow 0\), concluímos que \(ED_n\to 0\).
A segunda afirmação resulta, para cada \(n\), da identidade \(T\wedge n=\sum _{m=1}^n\mathbf1_{\{ T\geq m\} }\) e da fórmula da esperança de uma variável inteira não negativa pela soma das probabilidades de cauda.
A primeira regra permite passar das identidades em \(T\wedge n\) à identidade no tempo final \(T\), desde que haja uma cota integrável para os valores parados. Uma cota constante fornece a versão mais direta desse princípio.
Parada com processo limitado Se \((M_n)\) é um martingal, \(T\) é um tempo de parada finito quase certamente e existe uma constante \(K\) tal que
então \(E(M_T)=E(M_0)\).
7.5.1 Distribuições de saída
No capítulo de cadeias finitas, calculamos probabilidades de saída resolvendo equações de primeiro passo. A interpretação por martingais oferece outro caminho: procuramos uma função do estado cuja média permaneça constante e a observamos no instante da saída. As condições de fronteira transformam essa média em uma equação para a probabilidade desejada.
Saída e funções harmônicas Seja \(X\) uma cadeia de Markov em \(S\), com matriz \(P\). Sejam \(A,B\subset S\) disjuntos, \(C=S\setminus (A\cup B)\) finito e
Suponha que \(H_A\wedge H_B\lt \infty \) quase certamente a partir de todo \(x\in C\). Se \(h:S\to \mathbb R\) satisfaz \(h=1\) em \(A\), \(h=0\) em \(B\) e
então \(h(x)=\mathbb {P}_x(H_A\lt H_B)\) para \(x\in C\).
Fixe \(x\in C\) e ponha \(T=H_A\wedge H_B\). Antes de \(T\), a cadeia está em \(C\) e a equação \(Ph=h\) conserva a média condicional de \(h(X_n)\). Depois de \(T\), a função observada fica congelada. Portanto, \(h(X_{T\wedge n})\) é um martingal, pelo mesmo cálculo dos exemplos de funções harmônicas paradas. Ele é limitado pela constante
pois em \(A\) e \(B\) os valores são, respectivamente, um e zero. A hipótese garante \(T\lt \infty \) quase certamente. Pelo Teorema 7.9,
O argumento explica por que as condições de fronteira são \(0\) e \(1\): no instante da saída, a variável \(h(X_T)\) é exatamente a indicadora de sair por \(A\).
Este é o Teorema 2.20, agora obtido sem resolver o sistema linear: a parada de um martingal limitado substitui a inversão de \(I-R\).
Para explicitar a finitude de \(T\), ponha \(L=b-a\). Partindo de qualquer estado interno, \(L\) passos consecutivos para a direita forçam a chegada a \(b\) antes do fim do bloco. A probabilidade dessa sequência é \(2^{-L}\), independentemente do passado. Assim,
Logo \(T\lt \infty \) quase certamente. Como \(S_n\) é martingal e \(S_{T\wedge n}\in [a,b]\), o Teorema 7.9 dá
Escreva \(u=\mathbb P_x(S_T=b)\). Os passos de tamanho um impedem ultrapassar as barreiras, logo \(S_T\in \{ a,b\} \) e a probabilidade de saída por \(a\) é \(1-u\). A identidade anterior fica \(x=a(1-u)+bu=a+(b-a)u\). Isolando \(u\), obtemos \(u=(x-a)/(b-a)\) e \(1-u=(b-x)/(b-a)\), as fórmulas de (7.2).
A posição \(S_n\) já é um martingal no passeio simétrico. Por isso a chance de alcançar a barreira superior é simplesmente a fração do intervalo que separa \(x\) da barreira inferior.
Considere agora a caminhada assimétrica \(S_n=x+\xi _1+\cdots +\xi _n\), com
Suponha \(0\lt p\lt 1\), \(p\ne 1/2\), escreva \(r=q/p\) e seja
As probabilidades de saída são
Novamente \(T\lt \infty \) quase certamente: em um bloco de \(L=b-a\) passos, a sequência de apenas passos positivos tem probabilidade \(p^L\gt 0\) e força a saída. Portanto, \(\mathbb P_x(T\gt kL)\leq (1-p^L)^k\to 0\). Pelo Exemplo 7.7, \(M_n=r^{S_n}\) é um martingal. Como \(M_{T\wedge n}\) permanece entre \(r^a\) e \(r^b\), o Teorema 7.9 fornece
Se \(u=\mathbb P_x(S_T=b)\), a identidade se escreve \(r^x=r^a(1-u)+r^bu\). Como \(r\ne 1\), os números \(r^a\) e \(r^b\) são distintos. Assim,
que são as fórmulas de (7.3). O cálculo vale tanto para \(r\gt 1\) quanto para \(0\lt r\lt 1\): neste último caso, numerador e denominador mudam de sinal juntos.
No passeio assimétrico, a própria posição já não é um martingal. A função \(r^{S_n}\) compensa a tendência da caminhada e desempenha o papel que \(S_n\) tinha no caso simétrico. Em lugar de resolver novamente uma recorrência, usamos a constância da esperança e os dois valores de fronteira.
E se as probabilidades de subir e descer mudarem de estado para estado? Em geral, uma única potência \(r^{S_n}\) já não compensa a deriva. A função de escala do próximo exemplo constrói a transformação adequada para cada cadeia.
Pela definição da soma, para \(x\geq 1\),
As diferenças consecutivas de \(\phi \) satisfazem
De fato,
A probabilidade de permanência não aparece nessa diferença, pois produz incremento zero. Logo \(P\phi (x)=\phi (x)\) no interior das barreiras. De cada estado interno existe um caminho de probabilidade positiva até uma barreira. Como há apenas finitos estados internos, o argumento por blocos geométricos usado na ruína garante que \(T=H_a\wedge H_b\) é finito quase certamente. O martingal parado \(\phi (X_{T\wedge n})\) é limitado por \(\phi (b)\). Pela parada com processo limitado,
o que dá a fórmula, pois \(\phi \) é estritamente crescente.
Tomando \(a=0\) e \(x=1\), obtemos \(\mathbb {P}_1(H_0\lt H_b)=1-1/\phi (b)\). Esses eventos aumentam para \(\{ H_0\lt \infty \} \): toda trajetória que chega a \(0\) em tempo finito tem máximo finito até a chegada. Assim, \(\mathbb {P}_1(H_0\lt \infty )=1\) exatamente quando \(\phi (b)\to \infty \). No primeiro passo a partir de \(0\),
Para \(p_0\gt 0\), essa expressão é 1 precisamente no caso anunciado. Para \(p_0=0\), o retorno em tempo positivo ocorre já no passo 1.
7.5.2 Tempos de saída
Para calcular por onde a cadeia sai, bastou encontrar uma função harmônica. Para calcular quando ela sai, precisamos também contabilizar o tempo gasto em cada passo. É esse custo de uma unidade por etapa que aparece na equação de Poisson: a função de estado deve compensá-lo com uma queda média de uma unidade.
Saída e equação de Poisson Seja \(X\) uma cadeia de Markov em \(S\), com matriz \(P\). Seja \(A\subset S\), suponha que \(C=S\setminus A\) seja finito e defina
Suponha \(\mathbb {P}_x(H_A\lt \infty )=1\) para todo \(x\in C\). Se \(g=0\) em \(A\) e
então \(g(x)=E_x(H_A)\) para \(x\in C\).
O cálculo do Exemplo 7.9 vale aqui porque \(g\) é limitada em \(C\) e nula em \(A\). Ele mostra que
é um martingal. Tomando esperanças,
Como \(C\) é finito, \(g(X_{H_A\wedge n})\) é limitado e converge quase certamente para \(g(X_{H_A})=0\). Além disso,
A primeira regra da Proposição 7.8, com a cota constante de \(|g|\) em \(C\), faz o primeiro termo tender a zero. A fórmula das probabilidades de cauda da mesma proposição faz o segundo tender a \(E_x(H_A)\) e conclui o argumento.
Este é o Teorema 2.21, agora obtido pela parada do martingal que combina a função de estado com o tempo acumulado.
No passeio simétrico, a posição tem média constante, mas o seu quadrado cresce em média uma unidade a cada passo. Subtrair esse crescimento produz \(S_n^2-n\), o martingal apropriado para calcular a duração média do jogo.
Seja \((S_n)\) uma caminhada aleatória simples simétrica, iniciada em \(x\in (a,b)\), com \(a,b,x\) inteiros, e seja
A duração média é
Pelo Exemplo 7.4, \(S_n^2-n\) é um martingal. Aplicando o Teorema 7.5 no tempo \(T\wedge n\),
A finitude quase certa de \(T\) foi verificada no exemplo da distribuição de saída simétrica. O processo \(S_{T\wedge n}\) permanece no intervalo \([a,b]\) e, em cada trajetória com \(T\lt \infty \), é igual a \(S_T\) a partir de algum instante. Assim, converge quase certamente para \(S_T\). Seus quadrados são limitados pela constante \(\max \{ a^2,b^2\} \); a primeira regra da Proposição 7.8 faz suas esperanças convergirem. Pela fórmula de caudas da mesma proposição, \(E(T\wedge n)\to E(T)\). Portanto,
Usando as probabilidades de saída de (7.2), obtemos
A diferença em relação ao cálculo das probabilidades de saída é instrutiva: \(S_n\) acompanha a posição, enquanto \(S_n^2-n\) carrega também a passagem do tempo.
Para incrementos independentes de média \(\mu \), uma soma com \(n\) parcelas tem média \(n\mu \). A identidade seguinte mostra em que condições podemos substituir esse número fixo por um tempo de parada. O ponto decisivo é que a decisão de incluir a próxima parcela seja tomada antes de observá-la.
Equação de Wald Sejam \(\xi _1,\xi _2,\ldots \) variáveis i.i.d. com \(E|\xi _1|\lt \infty \) e \(E(\xi _1)=\mu \). Seja \(S_n=S_0+\xi _1+\cdots +\xi _n\), com \(S_0\) constante. Se \(T\) é um tempo de parada para a filtração natural e \(E(T)\lt \infty \), então
O evento \(\{ T\geq m\} \) pode ser decidido com a história até \(m-1\); como o próximo incremento é independente dessa história, sua indicadora é independente de \(\xi _m\). Além disso,
Para \(K\gt N\), a desigualdade triangular fornece
A cauda à direita tende a zero uniformemente em \(K\), pela fórmula de caudas para \(E(T)\). Para explicitar o controle do valor final, note primeiro que \(E(T)\lt \infty \) implica \(T\lt \infty \) quase certamente. Repartindo segundo os eventos \(\{ T=k\} \) e reordenando apenas parcelas não negativas, temos
A soma é entendida como zero quando \(T\leq N\). Esse cálculo, também com \(N=0\), prova a integrabilidade de \(S_T-S_0\) e mostra que as somas parciais convergem em média a esse valor. Passando ao limite nas esperanças das somas finitas, obtemos
No Exemplo 7.11, temos \(\mu =0\) e \(E_1(S_T)\ne E_1(S_0)\). Pela contrapositiva da equação de Wald, necessariamente \(E_1(T)=\infty \).
Já num passeio com deriva para baixo, a esperança do tempo de chegada pode ser finita. O martingal \(S_n-(p-q)n\) permite calculá-la, mas primeiro precisamos verificar essa finitude: não seria legítimo aplicar Wald antes de estabelecer sua hipótese.
Considere a caminhada aleatória simples assimétrica \(S_n=x+\xi _1+\cdots +\xi _n\), com
Suponha \(0\lt p\lt 1/2\), \(x\geq 1\) inteiro e seja \(T=\inf \{ n\geq 0:S_n=0\} \). Então \(E_x(T)=x/(q-p)\).
Como \(E(\xi _i)=p-q\lt 0\), o processo \(S_n-(p-q)n\) é um martingal. Parando em \(T\wedge n\),
pois \(S_{T\wedge n}\geq 0\): antes de atingir zero, a caminhada não pode ficar negativa, e na parada seu valor é zero. Pela fórmula de caudas, \(E_x(T\wedge n)\uparrow E_x(T)\); fazendo \(n\to \infty \), obtemos \(E_x(T)\leq x/(q-p)\lt \infty \). Em particular, \(T\) é finito quase certamente. A equação de Wald pode agora ser aplicada e dá
Como \(S_T=0\) e \(S_0=x\), essa igualdade é \(-x=(p-q)E_x(T)\), isto é,
Os exemplos de saída ilustram uma escolha que vale lembrar: a ferramenta não é sempre o mesmo martingal. A posição, uma potência, uma função de escala ou um quadrado compensado respondem a perguntas distintas. O que permanece é o cuidado com a parada e com a passagem ao limite.
7.6 Problemas de síntese
Os dois problemas seguintes reúnem a escolha do martingal, a justificação da parada e a interpretação do resultado. No primeiro, duas perguntas sobre a mesma partida exigem martingais diferentes. No segundo, voltamos à estratégia de duplicação para calcular o efeito de um limite de apostas.
Escreva \(S_n=2+\xi _1+\cdots +\xi _n\) e \(T=\inf \{ n\geq 0:S_n\in \{ 0,5\} \} \). Antes das contas, verifiquemos que a partida termina e que \(E(T)\lt \infty \). A partir de qualquer capital interno, uma sequência de cinco vitórias força a saída pela barreira superior em, no máximo, cinco rodadas. Essa sequência tem probabilidade \(\alpha =(2/3)^5\), independentemente do passado. O argumento por blocos dá
Para a probabilidade de vitória, usamos o martingal \(2^{-S_n}\). Até a parada, ele permanece entre \(2^{-5}\) e \(1\). Se \(h=\mathbb P(S_T=5)\), a parada com processo limitado fornece
Para a duração, precisamos de um martingal que registre o tempo. Como \(E(\xi _1)=1/3\), esse papel cabe a \(S_n-n/3\). Já provamos a integrabilidade de \(T\), portanto a equação de Wald dá
O capital final vale cinco na vitória e zero na ruína. Logo,
A chance de vitória é aproximadamente \(0{,}774\), e a duração média é aproximadamente \(5{,}61\) rodadas. A primeira conta usa os valores da função exponencial nas barreiras; a segunda combina a posição final com o ganho médio por rodada. Não foi necessário resolver uma nova equação de diferenças para a duração.
Se a primeira vitória ocorre até a rodada \(m\), ela cobre todas as perdas anteriores e deixa uma unidade de ganho. Se as \(m\) rodadas terminam em derrota, a perda acumulada é \(1+2+\cdots +2^{m-1}=2^m-1\). Assim,
e
Também podemos chegar à média pela transformada de martingal. Se \(\tau \) é a rodada da primeira vitória e \(\xi _k\in \{ -1,1\} \) é o resultado da rodada \(k\), então
A aposta da rodada \(k\) é decidida com os resultados até \(k-1\). Para cada \(m\) fixo, todos os ganhos envolvidos são integráveis; portanto a transformada preserva a média zero.
Agora use a mesma sequência infinita de resultados para comparar os diferentes limites \(m\). A primeira vitória ocorre quase certamente em tempo finito. Em cada uma dessas trajetórias, \(G_m=1\) para todo \(m\geq \tau \), de modo que \(G_m\to 1\) quase certamente. Apesar disso, \(E(G_m)=0\) para todo \(m\). Não há contradição: a perda possível cresce como \(2^m\), e não existe uma variável integrável que domine todos os \(|G_m|\); se existisse, a Proposição 7.8 obrigaria as médias a convergir para \(1\). Aumentar o limite torna o ganho mais provável, mas também aumenta a perda que pode ocorrer. Convergência quase certa, sozinha, não permite trocar limite e esperança.
7.7 Exercícios
7.8 Testes sequenciais e martingais*
O que acontece com o nível de significância quando observamos repetidamente os dados e paramos assim que o resultado parece favorável? Um teste planejado para um tamanho fixo de amostra controla a probabilidade de rejeitar uma hipótese verdadeira naquele instante. Essa garantia não se estende automaticamente à procura de um instante favorável entre muitos.
Por exemplo, vinte testes independentes em blocos distintos, cada um com probabilidade de falso positivo \(0{,}05\), produzem pelo menos um falso positivo com probabilidade \(1-0{,}95^{20}\approx 0{,}642\). Quando os testes reutilizam os dados acumulados, as decisões são dependentes e essa fórmula não se aplica; ainda assim, repetir um teste fixo até aparecer \(p\lt 0{,}05\) em geral infla o erro. Precisamos de uma garantia para toda a trajetória da estatística.
Um valor grande de \(L_n\) indica que os dados observados favorecem \(H_1\) em relação a \(H_0\). Não é a probabilidade de \(H_1\) ser verdadeira: é uma comparação entre as probabilidades dos dados em dois modelos especificados.
A razão de uma observação tem esperança
onde escrevemos uma soma no caso discreto e uma integral usual no contínuo. A última igualdade usa a hipótese sobre os suportes. Cada fator é uma função da nova observação e, portanto, é independente dos fatores anteriores. Pela não negatividade e pela independência,
Isso prova a integrabilidade em cada instante. Como \(L_n\) é determinado pelos dados observados até \(n\), é também adaptado. Logo,
Fixe \(c\gt 0\) e \(T_c=\inf \{ n\geq 0:L_n\geq c\} \). Esse é um tempo de parada, pois saber se \(T_c\leq m\) exige apenas examinar \(L_0,\ldots ,L_m\). Para cada inteiro \(m\), o Teorema 7.5 sobre o processo parado dá
A primeira desigualdade usa não negatividade, sem supor que \(L_{T_c}\) seja limitado ou que \(T_c\) seja finito. Os eventos \(\{ T_c\leq m\} \) crescem para \(\{ T_c\lt \infty \} \), logo \(\mathbb {P}(T_c\lt \infty )\leq 1/c\) por continuidade da probabilidade.
Resta incluir a possibilidade de o supremo não ser atingido. Para todo \(c\lt 1/\alpha \),
Portanto, a probabilidade do evento à esquerda é no máximo \(1/c\). Fazendo \(c\uparrow 1/\alpha \), obtemos a desigualdade desejada. O argumento usa apenas as identidades nos tempos limitados \(T_c\wedge m\) e a continuidade das probabilidades; não exige passar ao limite na esperança do processo parado.
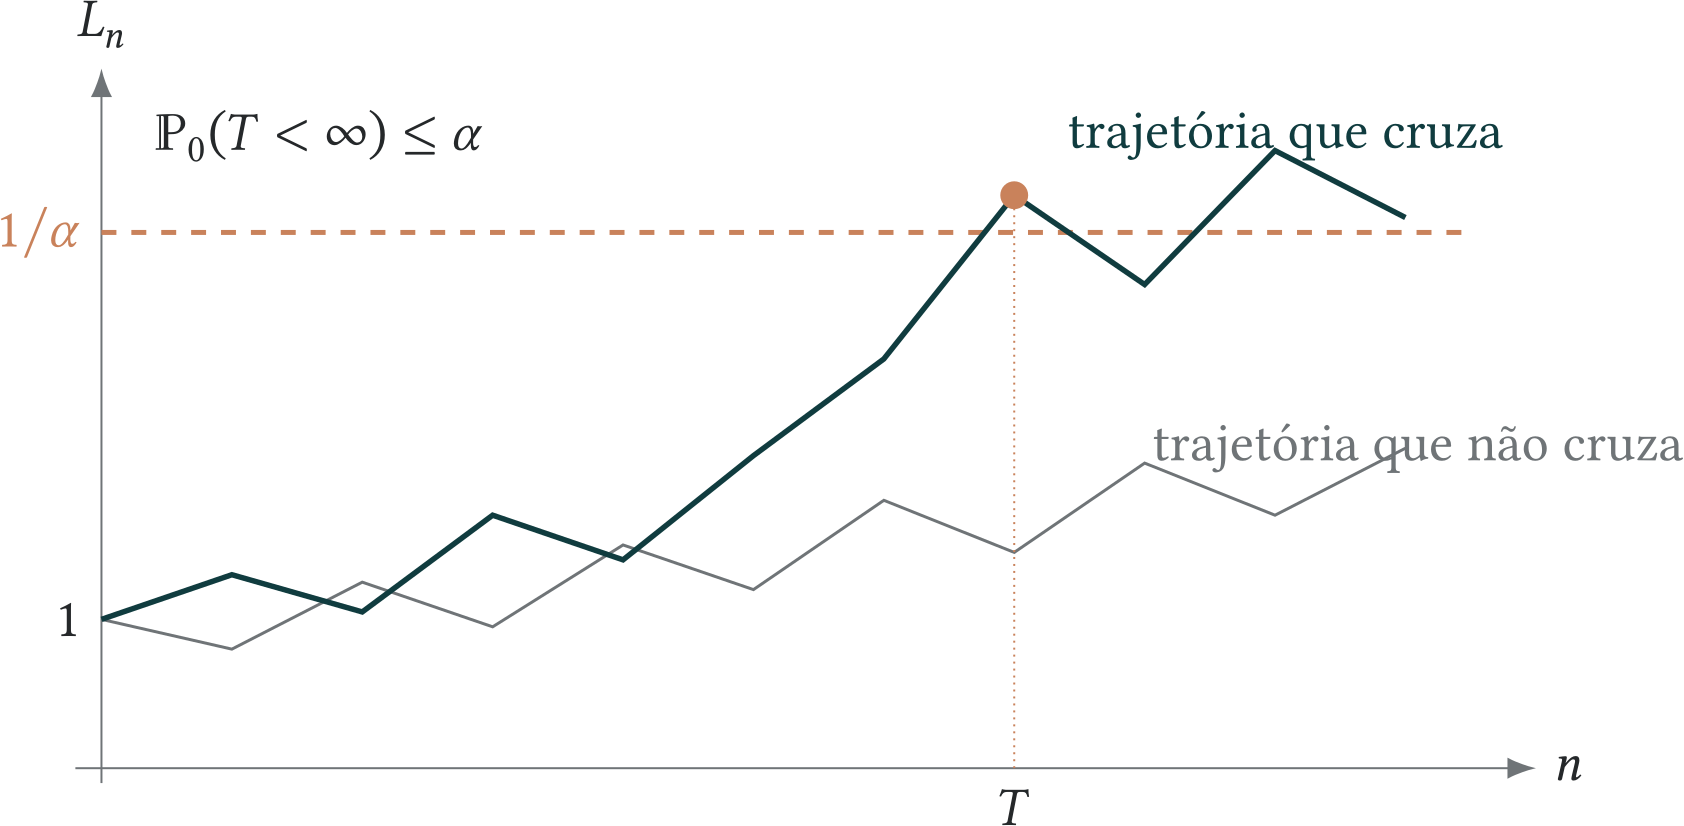
A regra “rejeite \(H_0\) na primeira vez em que \(L_n\geq 1/\alpha \)” tem, assim, probabilidade de falso positivo no máximo \(\alpha \), mesmo com monitoramento após cada observação e sem horizonte máximo. A desigualdade é uma cota, não uma promessa de erro exatamente igual a \(\alpha \). O tratamento clássico de razões de verossimilhanças sequenciais está em Wald (1947); a desigualdade para martingais remonta a Ville (1939).
Acompanhe usuários distintos com a mesma janela completa de observação e registre \(X_k=1\) se o usuário \(k\) realiza a ação definida como conversão, e \(X_k=0\) caso contrário. Suponha independência entre usuários e probabilidade constante de conversão. Considere o valor de referência conhecido \(H_0:p=1/2\) e a alternativa previamente escolhida \(H_1:p=0{,}7\).
Se \(S_n=X_1+\cdots +X_n\), a estatística é
Cada conversão multiplica a evidência por \(1{,}4\); cada não conversão a multiplica por \(0{,}6\). Para os dados \((1,1,0,1)\), os valores sucessivos são
Com \(\alpha =0{,}05\), o limiar é \(20\), portanto não rejeitamos nesse trecho. Em outro trecho iniciado em \(n=0\), nove conversões consecutivas bastariam: \(1{,}4^9\approx 20{,}66\). A garantia de Ville considera todos os caminhos possíveis sob \(H_0\), inclusive a procura contínua por um cruzamento.
A garantia matemática depende também da forma como os dados são produzidos. Para cada usuário, o registro deve conservar o que conta como conversão, qual foi sua janela completa de observação e em que ordem ele entrou na amostra. A proporção \(S_n/n\) descreve a taxa observada, mas não autoriza reajustar livremente as hipóteses \(f_0\) e \(f_1\) usando os próprios resultados que estão sendo monitorados. Do mesmo modo, uma taxa de referência estimada de dados históricos carrega incerteza; tratá-la como conhecida muda as condições sob as quais o teste é válido.
As hipóteses de independência e de taxa constante merecem ser confrontadas com os registros. Taxas muito diferentes entre períodos ou grupos, assim como observações repetidas do mesmo indivíduo, podem indicar que a sequência de Bernoulli independentes não descreve bem o experimento. Um estudo A/B ainda exigiria considerar a alocação e os resultados dos dois grupos: o exemplo acima trata apenas do monitoramento contra uma referência fixa.
A desigualdade de Ville controla o risco de decidir quando interromper esse monitoramento, mas não corrige escolhas feitas depois de observar os dados, mudanças na população ou dependências ignoradas. Por outro lado, não cruzar o limiar até certa data não demonstra \(H_0\); a rapidez da detecção depende, entre outros fatores, da alternativa \(H_1\) escolhida. Se mudamos o experimento ou as hipóteses, precisamos verificar novamente a propriedade de martingal que sustenta a garantia.
7.9 Reforço e seleção nas colônias de formigas*
Retomamos o modelo de dois caminhos da Seção 3.8, sem evaporação. A escolha obedece a (3.6) e a atualização é dada por (3.7) com \(\delta =0\). O histórico \(\mathcal H_n\) da colônia até a iteração \(n\) forma uma filtração, e as proporções de feromônio são adaptadas a ela. Agora podemos demonstrar os resultados de convergência anteriormente anunciados.
7.9.1 Reforços iguais: a urna de Pólya
Primeiro suponha que os dois caminhos recebam o mesmo reforço \(q\gt 0\) e que não haja evaporação. Temos então
Dividindo todas as quantidades por \(q\), recuperamos uma urna de Pólya: quando as quantidades iniciais divididas por \(q\) são inteiras, escolher o caminho \(i\) corresponde a retirar uma bola da cor \(i\), devolvê-la e acrescentar outra da mesma cor. Para valores iniciais positivos não inteiros, a mesma regra usa massas de cada cor em lugar de números de bolas; a escolha é proporcional à massa e o reforço acrescenta uma unidade.
Feromônio como uma urna de Pólya Defina
No modelo sem evaporação e com reforços iguais, \((Z_n)_{n\geq 0}\) é um martingal limitado. Portanto, existe uma variável aleatória \(Z_\infty \) tal que \(Z_n\to Z_\infty \) quase certamente.
Mais precisamente, se \(\tau _1(0)=aq\) e \(\tau _2(0)=bq\), com \(a,b\gt 0\), então
Em particular,
Escreva \(S_n=\tau _1(n)+\tau _2(n)\) e \(Z_n=\tau _1(n)/S_n\). Se o caminho 1 é escolhido, o novo valor da proporção é \((\tau _1(n)+q)/(S_n+q)\); caso contrário, é \(\tau _1(n)/(S_n+q)\). Como a probabilidade da primeira alternativa é \(Z_n\),
Logo, \((Z_n)\) é um martingal. Como \(0\leq Z_n\leq 1\), o Teorema 7.7 garante a convergência quase certa.
Para identificar a distribuição do limite, considere uma sequência particular de \(r+s\) escolhas, com \(r\) escolhas do caminho 1 e \(s\) do caminho 2. Escreva \((c)_k=c(c+1)\cdots (c+k-1)\), com \((c)_0=1\). Multiplicando as probabilidades condicionais, encontramos para qualquer sequência com essas contagens
De fato, cada escolha do caminho 1 acrescenta uma unidade à sua massa e cada escolha do caminho 2 faz o mesmo com a outra. Os denominadores crescem sucessivamente de \(a+b\) até \(a+b+r+s-1\). Assim, a ordem das escolhas não altera essa probabilidade.
Para reconhecer a expressão, precisamos apenas de uma integral de uma variável. Para \(a,b\gt 0\), defina
A integral imprópria é finita e positiva: perto de \(0\) o integrando se comporta como \(u^{a-1}\) e perto de \(1\), como \((1-u)^{b-1}\). A distribuição \(\operatorname {Beta}(a,b)\) tem densidade
Não precisaremos da função Gama para calcular com essa distribuição. Da identidade \(u+(1-u)=1\), segue
Uma integração por partes fornece
O termo de fronteira é zero porque \(a,b\gt 0\). Combinando as duas relações,
Repetindo essas fórmulas \(r\) e \(s\) vezes, obtemos
Considere agora outro experimento. Primeiro sorteamos \(P\sim \operatorname {Beta}(a,b)\); depois, condicionado ao valor de \(P\), fazemos escolhas independentes com probabilidade \(P\) de escolher o caminho 1. Uma sequência particular com \(r\) escolhas do primeiro caminho e \(s\) escolhas do segundo tem probabilidade
Portanto, toda sequência finita de escolhas tem a mesma probabilidade nos dois modelos.
Denote por \(N_1(n)\) o número de escolhas do primeiro caminho até a etapa \(n\). Então
Esse valor depende apenas das primeiras \(n\) escolhas. Como cada sequência dessas escolhas tem a mesma probabilidade nos dois modelos, também \(Z_n\) tem a mesma distribuição em ambos, para cada \(n\).
No modelo com parâmetro sorteado, a lei forte dos grandes números, aplicada com o valor de \(P\) fixado, dá \(N_1(n)/n\to P\) e, consequentemente, \(Z_n\to P\) quase certamente. No modelo de reforço original já provamos \(Z_n\to Z_\infty \) quase certamente. Resta mostrar que a igualdade das distribuições em cada etapa identifica também a distribuição do limite.
Podemos fazer isso sem um teorema de convergência de distribuições. Fixe \(u\in (0,1)\) e \(\varepsilon \gt 0\). No modelo de reforço,
e, invertendo os papéis dos limiares,
Os termos de desvio tendem a zero pela convergência quase certa. As probabilidades \(\mathbb P(Z_n\le u\pm \varepsilon )\) são as mesmas nos dois modelos, pela igualdade de distribuições já demonstrada. No modelo com \(P\), o mesmo argumento mostra que \(\mathbb P(Z_n\le v)\to \mathbb P(P\le v)\) para todo \(v\), pois \(P\) possui densidade. Deixando \(n\to \infty \) e depois \(\varepsilon \downarrow 0\), obtemos \(\mathbb P(Z_\infty \le u)=\mathbb P(P\le u)\), isto é, \(Z_\infty \sim \operatorname {Beta}(a,b)\).
Finalmente, as mesmas integrais dão, para \(k=1,2\),
Em particular,
Subtraindo o quadrado da média,
como anunciado.
O caso \(a=b=1\) permite interpretar o resultado: \(Z_\infty \) é uniforme em \([0,1]\). Embora os caminhos sejam simétricos, a proporção de feromônio não converge necessariamente a \(1/2\). O reforço pode preservar indefinidamente flutuações ocorridas nas primeiras escolhas. Por exemplo,
Simetria das regras implica simetria da distribuição dos resultados, mas não obriga cada execução a terminar em uma configuração simétrica.
7.9.2 Reforços diferentes: deriva e seleção
Voltemos aos reforços \(q_i=Q/L_i\), ainda sem evaporação. Suponha que \(L_1\lt L_2\); equivalentemente, \(q_1\gt q_2\). Agora o caminho 1 recebe mais feromônio toda vez que é percorrido.
Condicionado ao passado, a escolha do caminho 1 produz o incremento
enquanto a escolha do caminho 2 produz
Multiplicando esses incrementos pelas probabilidades \(Z_n\) e \(1-Z_n\), obtemos (7.4). Como a função \(q\mapsto q/(S_n+q)\) é crescente, a deriva é positiva quando \(q_1\gt q_2\) e \(0\lt Z_n\lt 1\). Explicitamente,
O valor \(Z_n\) é determinado pelo histórico e está entre zero e um; logo é adaptado e integrável. A deriva não negativa verifica a condição de submartingal, e a limitação permite aplicar o teorema de convergência citado no enunciado.
A deriva positiva favorece, a cada etapa, o caminho mais curto. Ela também torna \(Z_n\) um submartingal limitado, mas isso garante apenas a existência de um limite, não que esse limite seja \(1\). Precisamos de uma ideia adicional para mostrar que o caminho mais curto acaba dominando.
A demonstração do Teorema 3.17, anunciado anteriormente, usa uma ligação com os processos de nascimento puro do Capítulo 6. Em vez de comparar diretamente as escolhas sucessivas, observaremos o crescimento de dois processos independentes que reproduzem as mesmas proporções de feromônio. Uma visão geral da teoria das urnas reforçadas está em Pemantle (2007).
Primeiro passo: representar as escolhas por relógios. Para \(i=1,2\), considere um processo de nascimento puro \(Y_i(t)\) que, quando está no estado \(y\), salta para \(y+q_i\) a uma taxa igual a \(y\). Tome os dois processos independentes, com os mesmos valores iniciais de feromônio do modelo discreto.
Se, em determinado instante, os processos estão em \((y_1,y_2)\), seus relógios têm taxas \(y_1\) e \(y_2\). A corrida de exponenciais mostra que o primeiro toca antes do segundo com probabilidade \(y_1/(y_1+y_2)\), exatamente a probabilidade de escolher o caminho 1. Depois do toque, o relógio correspondente recomeça com a nova taxa; pela falta de memória, a espera residual do outro relógio conserva sua lei exponencial. Assim, a sequência dos pares observados nos instantes de salto tem a mesma lei que \((\tau _1(n),\tau _2(n))\). O relógio contínuo não altera a ordem probabilística das escolhas; apenas permite estudar separadamente o crescimento dos dois componentes.
Segundo passo: medir o crescimento de cada componente. Se \(Y_i(0)=y_i\gt 0\), depois de \(m\) saltos sua massa é \(y_i+q_i m\), e o tempo médio até o salto seguinte é \(1/(y_i+q_i m)\). Podemos, portanto, escrever o instante do \(k\)-ésimo salto como
onde os \(E_{i,m}\) são independentes e exponenciais de taxa \(1\). As esperas médias são comparáveis à série harmônica. Como \(x\mapsto 1/(y_i+q_ix)\) é positiva e decrescente, a comparação entre soma e integral fornece
Essas integrais são diferenças de logaritmos. Logo, existe uma constante \(D_i\lt \infty \) tal que, para todo \(k\ge 2\),
Pela independência, as variâncias se somam:
pois a série é comparável à de \(1/m^2\). Assim, a média cresce na escala \(\log k\), mas a variância permanece limitada.
Escolhemos primeiro a subsequência \(k=2^j\): nela, \(\log k\) é proporcional a \(j\), e a estimativa de Chebyshev se torna somável. Para \(\varepsilon \gt 0\),
Como a série \(\sum _{j\ge 1}j^{-2}\) converge, a soma dessas probabilidades é finita. Pelo primeiro lema de Borel–Cantelli, para cada \(\varepsilon \gt 0\), os desvios maiores que \(\varepsilon j\) ocorrem apenas finitas vezes, quase certamente. Aplicando o resultado a \(\varepsilon =1,1/2,1/3,\ldots \), obtemos
A estimativa para a média também mostra que \(ET_{i,2^j}/(j\log 2)\to 1/q_i\). Juntando os dois limites, \(T_{i,2^j}/\log (2^j)\to 1/q_i\).
Resta passar das potências de dois a todos os índices. Para \(2^j\leq k\leq 2^{j+1}\) e \(j\geq 1\), a monotonicidade dá
Os dois extremos tendem a \(1/q_i\), pois os fatores \(j/(j+1)\) e \((j+1)/j\) tendem a \(1\). Portanto,
Esse limite mostra também que os instantes de salto tendem a infinito: não há explosão. Por outro lado, cada número finito de saltos ocorre em tempo finito, de modo que sua contagem \(K_i(t)\) cresce sem limite quando \(t\to \infty \).
Precisamos agora converter o tempo necessário para \(k\) saltos na quantidade de saltos observada até \(t\). Ponha \(k=K_i(t)\). Para \(t\) suficientemente grande, \(k\geq 2\) e \(T_{i,k}\leq t\lt T_{i,k+1}\); portanto,
Os extremos tendem a \(1/q_i\). Assim, \(t/\log K_i(t)\to 1/q_i\) e, tomando os recíprocos, \(\log K_i(t)/t\to q_i\). Como \(Y_i(t)=y_i+q_iK_i(t)\), a diferença \(\log Y_i(t)-\log K_i(t)\) tende a \(\log q_i\). Dividida por \(t\), essa diferença tende a zero. Portanto, os dois logaritmos divididos por \(t\) têm o mesmo limite:
Terceiro passo: comparar os caminhos. Cada componente cresce exponencialmente em escala logarítmica, com taxa \(q_i\). Se \(q_1\gt q_2\), então
e por isso \(Y_2(t)/Y_1(t)\to 0\). Os instantes da sequência conjunta de saltos também tendem a infinito. Neles, a proporção de feromônio do primeiro caminho é \(Z_n=Y_1/(Y_1+Y_2)\); portanto \(Z_n\to 1\).
A mesma estimativa fornece a ordem da velocidade em escala logarítmica:
De fato, até o tempo \(t\) houve \((Y_i(t)-y_i)/q_i\) saltos do processo \(i\); como \(Y_2(t)/Y_1(t)\to 0\), o número total \(n(t)\) de saltos satisfaz \(\log n(t)/t\to q_1\). Por outro lado, \(t^{-1}\log (1-Z_{n(t)})\to q_2-q_1\). Como \(q_i=Q/L_i\), o expoente é \(1-L_1/L_2\). Quando os comprimentos são muito próximos, a distinção entre os caminhos pode ser lenta. Esse fenômeno aparece com frequência em otimização: soluções quase equivalentes exigem muitas amostras para serem separadas de modo consistente.
O caminho mais longo continua sendo usado infinitas vezes quase certamente. Na representação em tempo contínuo, o segundo processo também realiza infinitos saltos; sua quantidade de feromônio apenas cresce em uma ordem menor. Assim, a fração das escolhas correspondentes ao caminho 2 converge a zero, embora o número total dessas escolhas cresça sem limite.
7.10 Exercícios complementares*
Os três primeiros exercícios usam a Seção 7.8; o último retoma a Seção 7.9.