Cadeias de Markov enumeráveis
Em um espaço infinito, uma cadeia irredutível pode ser transiente. Mesmo quando é recorrente, o tempo médio de retorno pode ser infinito; nesse caso, não há distribuição estacionária. Os critérios de retorno, as equações de primeiro passo e o teorema ergódico continuam disponíveis, sob as hipóteses estabelecidas nos capítulos anteriores.
Os passeios aleatórios revelam a influência da dimensão sobre a recorrência. O protocolo Aloha descreve um sistema de comunicação com infinitos estados; nos processos de ramificação, o estado é o tamanho de uma população. Os problemas de síntese reúnem esses modelos no estudo da ruína, do crescimento de filas e da extinção. Por fim, a percolação em árvores e os grafos aleatórios mostram como a ideia de ramificação também ajuda a estudar a formação de grandes componentes em uma rede.
4.1 Passeios aleatórios em \(\mathbb Z^d\)
O critério de recorrência do Teorema 2.16 ganha uma interpretação concreta para passeios aleatórios: basta estimar a probabilidade de o passeio estar novamente na origem após \(n\) passos.
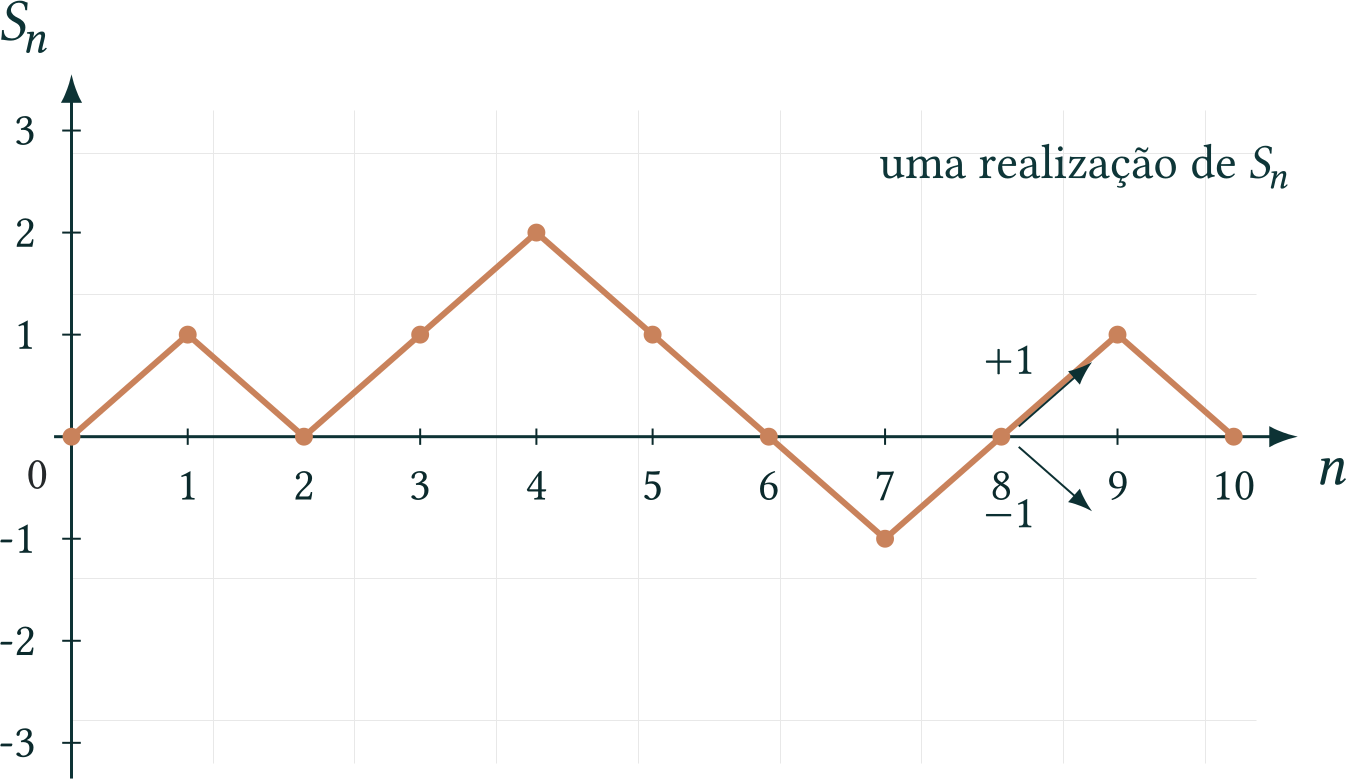
Sob \(\mathbb P_x\), o passeio parte de \(x\). Como a lei dos incrementos não depende da posição, começar em outro estado apenas desloca a trajetória: \(\mathbb P_x(S_n=x)=\mathbb P_0(S_n=0)\). Por isso, estudaremos os retornos à origem. A Figura 4.1 mostra uma realização em dimensão um.
As probabilidades de estar novamente na origem após poucos passos podem ser calculadas por contagem de caminhos. Aqui admitimos visitas anteriores à origem: não estamos calculando probabilidades de primeiro retorno. Partindo da origem em \(\mathbb Z^d\), o primeiro passo pode ocorrer em qualquer uma das \(2d\) direções. Para retornar no segundo passo, deve-se escolher a direção oposta. Portanto,
Em quatro passos há dois tipos de caminho fechado. No primeiro, todos os passos são paralelos a um mesmo eixo: há \(d\) escolhas do eixo e \(\binom 42=6\) maneiras de ordenar os dois passos positivos e os dois negativos. No segundo, são usados dois eixos distintos, com um passo positivo e um negativo em cada eixo: há \(\binom d2\) escolhas dos eixos e \(4!=24\) ordenações. Para \(d=1\), esse segundo tipo não ocorre, de acordo com \(\binom 12=0\). Assim,
Em particular,
Essas contas mostram que a dimensão altera as probabilidades de retorno já nos primeiros passos. A classificação em recorrente ou transiente depende, porém, da soma sobre todos os instantes.
Os vértices de \(\mathbb Z^d\) se dividem em duas classes: aqueles cuja soma das coordenadas é par e aqueles cuja soma é ímpar. Cada passo liga vértices de classes diferentes; assim, o grafo é bipartido. Como a soma vale zero na origem, o passeio só pode retornar a ela em instantes pares.
Para estimar as probabilidades de retorno, usaremos a fórmula de Stirling,
Se \(p=0\) ou \(p=1\), o passeio se move sempre no mesmo sentido e nunca retorna à origem. Suponha, portanto, \(0\lt p\lt 1\). Para retornar à origem no instante \(2n\), são necessários exatamente \(n\) passos para a direita e \(n\) para a esquerda. Logo,
Pela fórmula de Stirling,
Consequentemente,
Como não há retornos em instantes ímpares, basta examinar \(\sum _{n\geq 1}\mathbb {P}_0(S_{2n}=0)\). Se \(p=q=1/2\), temos \(4pq=1\) e os termos dessa série são assintoticamente equivalentes a \(1/\sqrt{\pi n}\). Ela diverge, pois \(\sum _{n\geq 1}n^{-1/2}\) diverge. Se \(p\neq q\), então \(4pq=1-(p-q)^2\lt 1\). Como \(\binom {2n}{n}\leq \sum _{j=0}^{2n}\binom {2n}{j}=4^n\), temos \(\mathbb {P}_0(S_{2n}=0)\leq (4pq)^n\) para todo \(n\geq 1\). A série converge por comparação com a série geométrica \(\sum _{n\geq 1}(4pq)^n\). Pelo Teorema 2.16, a origem é recorrente no primeiro caso e transiente no segundo. Por invariância por translação, a mesma classificação vale para todos os estados.
Expandindo os dois fatores pelo binômio de Newton, temos
Um termo de grau \(n\) é obtido escolhendo \(x^k\) no primeiro fator e \(x^{n-k}\) no segundo. Assim, o coeficiente de \(x^n\) no produto é \(\sum _{k=0}^n\binom nk\binom n{n-k}\). Como \(\binom n{n-k}=\binom nk\), essa soma é o lado esquerdo da identidade. Por outro lado, o produto é \((1+x)^{2n}\), cujo coeficiente de \(x^n\) é \(\binom {2n}{n}\). Igualar os coeficientes prova a afirmação, inclusive para \(n=0\).
Em um caminho fechado com \(2n\) passos, suponha que haja \(k\) passos para a direita e \(k\) para a esquerda. Restam \(n-k\) passos para cima e \(n-k\) para baixo. Para cada \(k\), observamos que
Portanto, somando sobre \(k\) e usando a identidade de Vandermonde demonstrada acima, o número de caminhos fechados é
Cada sequência específica de \(2n\) passos tem probabilidade \(4^{-2n}\), pois em cada instante há quatro direções equiprováveis. Consequentemente,
Pela estimativa (4.1), \(\binom {2n}{n}/4^n\sim 1/\sqrt{\pi n}\). Elevando ao quadrado, obtemos
Como a série \(\sum _{n\ge 1}1/n\) diverge, a série das probabilidades de retorno também diverge. Pelo Teorema 2.16, a origem é recorrente; por translação, todos os estados são recorrentes.
A recorrência garante que o passeio volta à origem, mas não que o tempo médio até esse retorno seja finito. As estimativas que acabamos de obter permitem responder também a essa segunda pergunta.
Em ambos os casos, o passeio é recorrente e \(P^n(0,0)=\mathbb P_0(S_n=0)\to 0\): nos instantes pares, isso decorre das equivalências assintóticas obtidas; nos ímpares, a probabilidade é zero. Denote por
o número de visitas à origem entre os instantes \(1\) e \(n\). Então
Para justificar esse limite, fixe \(\varepsilon \gt 0\) e escolha \(m_0\) tal que \(P^m(0,0)\lt \varepsilon \) para \(m\geq m_0\). Os termos anteriores a \(m_0\) são finitos e, divididos por \(n\), tendem a zero; os restantes contribuem no máximo \(\varepsilon \) à média. Mais explicitamente, para \(n\geq m_0\),
Primeiro fazemos \(n\) crescer e depois tomamos \(\varepsilon \) arbitrariamente pequeno, obtendo o limite anunciado.
Por outro lado, o Teorema 3.4 dá \(N_n(0)/n\to 1/E_0(T_0^+)\) quase certamente. Como essas variáveis ficam entre zero e um, o Lema 3.5 mostra que suas esperanças convergem para a mesma constante. Logo, \(1/E_0(T_0^+)=0\), isto é, \(E_0(T_0^+)=\infty \). Por translação, a conclusão vale para todos os estados.
A Figura 4.2 mostra uma trajetória no plano e sua distância à origem. Os zeros no segundo painel identificam os retornos da trajetória desenhada no primeiro.
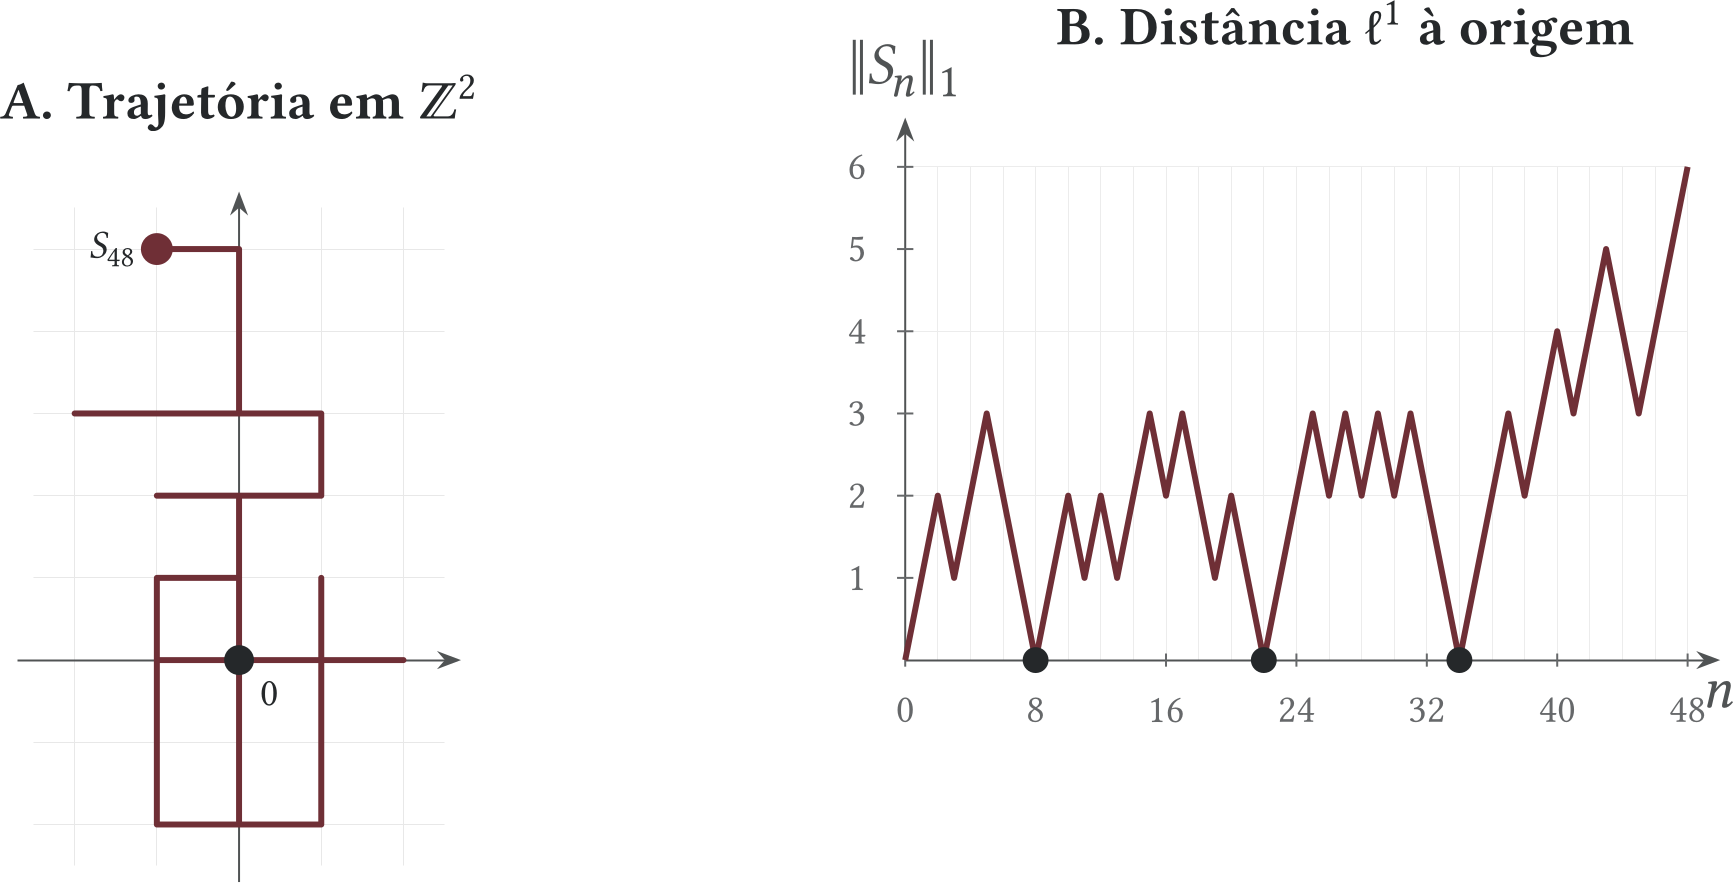
Em dimensão três, a contagem dos caminhos fechados produz uma soma mais difícil de calcular exatamente. Para provar a transiência, basta obter uma cota para a probabilidade de retorno cuja série seja convergente. Combinaremos a estimativa do coeficiente binomial central com uma cota para o maior termo de uma distribuição multinomial.
Um retorno à origem só pode ocorrer após um número par de passos. Consideremos, portanto, \(2n\) passos, com \(n\ge 1\). Denote por \(i,j,k\) as quantidades de passos nas direções positivas dos três eixos. Para que o deslocamento final seja zero, precisamos ter também \(i,j,k\) passos nas respectivas direções negativas. Assim,
Para valores fixados de \(i,j,k\), estamos ordenando seis tipos de passos, com multiplicidades \(i,i,j,j,k,k\). O número dessas sequências é
Cada sequência tem probabilidade \(6^{-2n}\), porque há seis direções equiprováveis. Somando sobre todas as possibilidades, chegamos a
Primeiro passo: reconhecer uma distribuição de probabilidade. Defina
Esse é o valor da probabilidade de obter \(i,j,k\) resultados em três categorias equiprováveis, em \(n\) ensaios independentes. Pela fórmula multinomial,
Com esses números, a expressão admite a fatoração
Como \(6^{2n}=2^{2n}3^{2n}\), a probabilidade de retorno fica
Não precisaremos calcular a soma dos quadrados: como todos os termos são não negativos e somam um,
Logo,
Segundo passo: estimar o maior termo multinomial. O máximo ocorre quando \(i,j,k\) diferem entre si por no máximo uma unidade. Para ver isso, suponha, por exemplo, que \(i\ge j+2\). Ao trocar \((i,j,k)\) por \((i-1,j+1,k)\), a razão entre o novo termo e o anterior é
Assim, enquanto duas coordenadas diferirem por duas ou mais unidades, podemos aumentar o termo aproximando-as. No máximo, as três coordenadas estão tão equilibradas quanto possível.
Comecemos pelo caso \(n=3m\). Então o maior termo é \(M_{3m}=a_{m,m,m}\). Pela fórmula de Stirling, \(k!\sim \sqrt{2\pi k}(k/e)^k\), obtemos
Em particular, \(M_{3m}\) é da ordem de \(1/m\).
Para os demais valores de \(n\), se \(n=3m+1\), os índices maximais são \((m+1,m,m)\) e suas permutações. Se \(n=3m+2\), são \((m+1,m+1,m)\) e suas permutações. Comparando diretamente os fatoriais com os do caso \(3m\),
Ambos os fatores são no máximo um. Como \(n=3m\), \(3m+1\) ou \(3m+2\) tem a mesma ordem de grandeza que \(m\) para \(m\ge 1\), existe uma constante \(C_2\) tal que
Os casos \(n=1,2\) são incluídos aumentando \(C_2\), se necessário.
Terceiro passo: reunir as duas estimativas. A estimativa (4.1) fornece
Assim, existe uma constante \(C_1\) tal que \(\binom {2n}{n}/2^{2n}\leq C_1/\sqrt n\) para \(n\) suficientemente grande. Aumentando \(C_1\), incluímos também os primeiros valores de \(n\). Portanto,
Não há retornos em instantes ímpares. Como \(\sum _{n\ge 1}n^{-3/2}\) converge, também converge \(\sum _{k\ge 1}\mathbb P_0(S_k=0)\). Pelo critério de recorrência, a origem é transiente. A invariância por translação estende essa conclusão a todos os estados.
Para \(d\gt 3\), projete o passeio nas três primeiras coordenadas. A projeção fica parada quando o passo ocorre numa das demais coordenadas. Se a observarmos apenas nos instantes em que ela se move, obtemos o passeio simples em \(\mathbb Z^3\); esse processo é a cadeia de saltos da projeção. De fato, cada passo move uma dessas três coordenadas com probabilidade \(6/(2d)=3/d\). Condicionadas à ocorrência de um movimento, as seis direções projetadas têm probabilidade \((1/(2d))/(3/d)=1/6\) cada uma. Como os incrementos originais são independentes, essas direções sucessivas também são independentes.
O tempo de espera até cada movimento tem distribuição geométrica com parâmetro \(3/d\gt 0\) e é finito quase certamente: a probabilidade de esperar mais de \(r\) passos é \((1-3/d)^r\), que tende a zero. Os tempos de espera formam uma sequência enumerável; portanto, com probabilidade um, todos são finitos. Pela transiência em dimensão três, a cadeia de saltos visita a origem apenas um número finito de vezes e todas as suas permanências têm duração finita. Nesse mesmo evento, a projeção está na origem em apenas um número finito de instantes. Toda visita do passeio original à origem exige que a projeção esteja na origem. Portanto, o passeio em \(\mathbb Z^d\) é transiente.
Os resultados anteriores compõem o teorema de Pólya: o passeio simples e simétrico é recorrente nas dimensões \(1\) e \(2\) e transiente em todas as dimensões maiores.
4.2 Um sistema com infinitos estados: o protocolo Aloha
Nos passeios, perguntamos se a trajetória retorna a um estado. Em um sistema de comunicação, os estados podem registrar o número de mensagens pendentes. O exemplo a seguir mostra como as colisões podem impedir o escoamento dessas mensagens e fazer a fila crescer.
Em uma versão simplificada do protocolo Aloha, mensagens novas tentam transmitir assim que chegam; cada mensagem que já sofreu uma colisão tenta novamente, independentemente das outras, com probabilidade \(r=1/2\) por intervalo. Se exatamente uma mensagem transmitir, ela sai do sistema. Se duas ou mais transmitirem, ocorre uma colisão e nenhuma sai.
Suponha que, em cada intervalo \(n\), cheguem \(A_n=1\) mensagem com probabilidade \(3/4\) ou \(A_n=2\) mensagens com probabilidade \(1/4\), independentemente entre intervalos. As decisões de retransmissão são renovadas a cada intervalo, independentemente das novas chegadas e de todos os sorteios anteriores. Seja \(X_n\) o número de mensagens pendentes antes das novas chegadas no intervalo \(n\), com \(X_0=0\). A Figura 4.3 resume as possibilidades de transmissão.
Escreva \(I_n=1\) quando há uma transmissão bem-sucedida no intervalo \(n\) e \(I_n=0\) caso contrário. Então
Se chegam duas mensagens, elas colidem entre si e \(X_n\) aumenta em duas unidades. Se chega uma, o número de mensagens pendentes fica igual ou aumenta em uma unidade. Portanto, \(X_n\) nunca diminui.
Há uma particularidade importante nesta versão do modelo: sempre chega pelo menos uma mensagem nova, e ela tenta transmitir imediatamente. Por isso, uma mensagem pendente nunca consegue sair: qualquer tentativa sua colide com uma nova transmissão. O único sucesso possível ocorre quando chega uma única mensagem e todas as pendentes ficam em silêncio; nesse caso, quem sai é a mensagem recém-chegada.
Dado \(X_n=k\), as probabilidades do próximo estado dependem apenas de \(k\), pois os novos sorteios são independentes do passado. Assim, \((X_n)\) é uma cadeia de Markov em \(\mathbb N_0\), com transições
e todas as demais probabilidades são zero. Cada estado é transiente: partindo de \(k\), a probabilidade de permanecer nele durante os próximos \(r\) intervalos é \(p(k,k)^r\), que tende a zero porque \(p(k,k)\lt 1\). Portanto, a cadeia o deixa em tempo finito quase certamente; como nunca diminui, não pode retornar depois de sair.
Além do crescimento da fila, ocorre um bloqueio persistente do canal: ao longo de infinitos intervalos, ocorrem somente finitas transmissões bem-sucedidas, quase certamente. Para demonstrá-lo, observamos que a condição de sucesso descrita acima dá
Se \(M_n\) é o número de intervalos entre \(0\) e \(n-1\) em que chegaram duas mensagens, então \(X_n\geq 2M_n\) e \(M_n\) tem distribuição binomial com parâmetros \(n\) e \(1/4\). Cada intervalo com duas chegadas acrescenta duas mensagens à fila, e os demais nunca a fazem diminuir; isso explica a desigualdade \(X_n\geq 2M_n\). Além disso, escrevendo \(M_n\) como soma dos indicadores independentes desses intervalos, obtemos
Consequentemente,
Para contar todos os sucessos, somamos primeiro até um instante finito e depois fazemos esse instante crescer. Pela linearidade da esperança e pela passagem ao limite para contagens crescentes, justificada no Lema 2.15, obtemos
Uma variável não negativa com esperança finita não pode ser infinita com probabilidade positiva. Para ver isso aqui, se \(S=\sum _{n\geq 0}I_n\), a desigualdade de Markov dá \(\mathbb P(S\geq r)\leq 4/r\) para todo \(r\geq 1\); como \(\{ S=\infty \} \subseteq \{ S\geq r\} \), sua probabilidade é zero. Logo, o número total de sucessos é finito quase certamente, embora mensagens continuem chegando. As tentativas simultâneas impedem o escoamento das mensagens.
A conclusão vale para a versão de carga elevada considerada aqui. Outras leis de chegada exigem uma análise própria.
Nos passeios e no protocolo Aloha, acompanhamos deslocamentos ou o acúmulo de mensagens. No próximo modelo, a população de uma geração produz a seguinte: o tamanho atual continua sendo toda a informação necessária para descrever o próximo passo, mas cada indivíduo contribui com uma quantidade aleatória de novos indivíduos.
4.3 Processos de ramificação
Uma população pode crescer em média e, ainda assim, desaparecer. O tamanho esperado, por si só, não determina a probabilidade de extinção.
A ideia de acompanhar sucessivas gerações não se limita a populações de seres vivos. Ela aparece também em sistemas físicos e em processos de transmissão, como mostram os exemplos a seguir.
Linhagens familiares. A partir de um indivíduo, acompanhamos seus filhos, netos, bisnetos e assim por diante. O número de filhos pode variar de uma pessoa para outra, e cada filho pode dar continuidade à linhagem por meio de seus próprios descendentes. Quantos membros haverá em uma geração futura? Qual é a probabilidade de que a linhagem deixe de ter descendentes?
Multiplicadores de elétrons. Um elétron que atinge uma superfície pode provocar a emissão de vários outros elétrons. Estes são conduzidos a uma segunda superfície, onde podem produzir novas emissões. Em uma sequência de etapas, um pequeno número inicial de elétrons pode dar origem a um sinal muito maior. Cada etapa corresponde a uma geração, e o número de elétrons emitidos por impacto faz o papel do número de filhos.
Reações em cadeia. Um nêutron pode provocar a fissão de um núcleo atômico, liberando novos nêutrons, que podem provocar outras fissões. Nem todo nêutron dá continuidade à reação: ele pode escapar do material ou ser absorvido sem produzir uma fissão. Em uma aproximação por gerações, podemos perguntar se a sequência de fissões se interrompe ou continua.
Início de uma epidemia. Uma pessoa infectada pode transmitir a doença a um número aleatório de outras pessoas. Estas podem produzir novas infecções, formando sucessivas gerações de transmissão. Quando ainda há muitas pessoas suscetíveis e diferentes cadeias de transmissão raramente alcançam a mesma pessoa, um processo de ramificação pode aproximar essa fase inicial. As gerações indicam quem infectou quem, não intervalos de tempo de igual duração.
Nesses exemplos, cada elemento pode produzir um número aleatório de novos elementos. Para construir um modelo comum, chamaremos esses elementos de indivíduos e acompanharemos o total em cada geração.
O tamanho de cada geração será o estado de uma cadeia de Markov. Condicionando no tamanho da geração anterior, calcularemos a média e a variância da população; com as funções geradoras, estudaremos a probabilidade de extinção. Ao final, discutiremos o que se pode estimar a partir de dados de cascatas de compartilhamentos, em uma aplicação que também pode ser lida separadamente.
4.3.1 Indivíduos, gerações e crescimento médio
Considere uma população que evolui em gerações. Cada indivíduo produz um número aleatório de filhos, independentemente dos demais e sempre segundo a mesma distribuição. Esses filhos formam a geração seguinte, na qual o mecanismo se repete. Assim, o tamanho de cada geração é determinado pela soma dos números de filhos dos indivíduos da geração anterior.
O índice \(n\) identifica a geração e \(r\) distingue os indivíduos que a compõem. A fórmula conta os filhos de todos eles. Se dois indivíduos produzem, respectivamente, três e nenhum filho, a geração seguinte terá tamanho três. A família \((Y_{n,r})\) registra quantos filhos cada indivíduo tem, enquanto a sequência \((Z_n)\) conserva apenas os totais por geração. Assim, árvores genealógicas diferentes podem produzir a mesma sequência de tamanhos.
A. Árvore genealógica
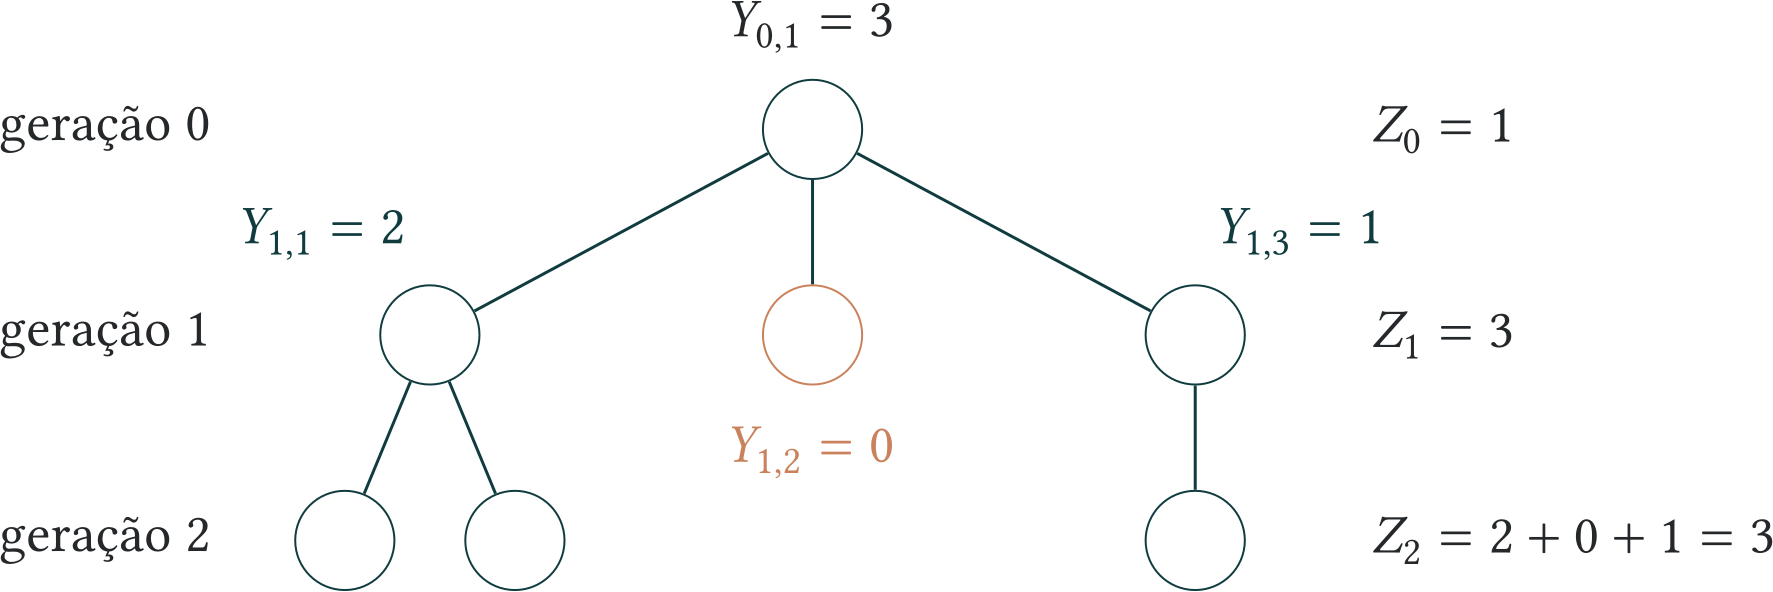
B. Evolução dos tamanhos
Se sabemos que \(Z_n=i\), há exatamente \(i\) indivíduos para se reproduzir. As gerações até \(n\) foram determinadas pelos sorteios \(Y_{\ell ,r}\) com \(\ell \lt n\). Os números de filhos \(Y_{n,1},\ldots ,Y_{n,i}\) são independentes desses sorteios e têm todos a lei de \(Y\). Por isso, conhecer as gerações anteriores não altera a distribuição da próxima: basta saber \(Z_n\). Essa é a propriedade de Markov, e as probabilidades de transição são
onde \(Y_1,\ldots ,Y_i\) são cópias independentes de \(Y\). O estado zero é absorvente: se uma geração não tem indivíduos, a seguinte também estará vazia.
A independência das reproduções, o uso da mesma lei por todos os indivíduos e a separação em gerações são hipóteses do modelo, não propriedades automáticas de uma população real.
Suponha que cada indivíduo não tenha filhos com probabilidade \(1/3\) e tenha dois filhos com probabilidade \(2/3\). Se \(Z_n=2\), então
com \(Y_1,Y_2\) independentes e valores em \(\{ 0,2\} \). Portanto,
Para obter dois filhos ao todo, exatamente um dos dois indivíduos deve reproduzir-se; as duas escolhas possíveis explicam o fator \(2\) em \(p(2,2)\). Essas são todas as possibilidades, e suas probabilidades somam um.
O mesmo raciocínio vale para qualquer tamanho inicial. Se \(Z_n=i\), o número \(B\) de indivíduos que produzem dois filhos tem distribuição binomial com parâmetros \(i\) e \(2/3\), e \(Z_{n+1}=2B\). Assim, para \(0\leq k\leq i\),
enquanto \(p(i,j)=0\) nos demais casos.
O fator \(m\) tem uma interpretação simples: cada indivíduo deixa, em média, \(m\) filhos, de modo que a esperança do tamanho da população é multiplicada por \(m\) de uma geração para a seguinte. Isso se refere à média entre possíveis evoluções, não ao crescimento de cada trajetória. Algumas populações podem desaparecer, enquanto outras crescem o suficiente para sustentar a esperança.
Se \(Z_n=i\), os \(i\) indivíduos produzem filhos, cada um com esperança \(m\). Pela linearidade da esperança,
Retiramos o condicionamento somando sobre os possíveis tamanhos da geração atual. Pela esperança total,
Na soma, os valores de \(i\) com probabilidade zero não contribuem. Como \(Z_0=k\) é constante, \(E(Z_0)=k\). Se \(E(Z_n)=km^n\lt \infty \), a igualdade anterior dá \(E(Z_{n+1})=km^{n+1}\lt \infty \). Isso estabelece simultaneamente a fórmula e a finitude das esperanças por indução, incluindo \(n=0\).
A média não informa quanto os tamanhos das gerações podem variar entre uma realização e outra. Para estudar essa variação, suponha que a distribuição de filhos tenha variância finita \(\sigma ^2=\operatorname {Var}(Y)\).
Escreva \(v_n=\operatorname {Var}(Z_n)\). Dado \(Z_n=i\), a geração seguinte é formada pelos filhos desses \(i\) indivíduos. Como os números de filhos são independentes, cada um com média \(m\) e variância \(\sigma ^2\), temos
O segundo momento é a soma da variância com o quadrado da média. Aplicando essa identidade à distribuição condicionada, obtemos
Para calcular o segundo momento de \(Z_{n+1}\), tomamos agora a esperança sobre os possíveis valores de \(Z_n\). Como
a fórmula da esperança total fornece
Essa igualdade também permite verificar que os segundos momentos são finitos. De fato, como \(Z_0=k\), temos \(E(Z_0^2)=k^2\lt \infty \). Suponha agora que \(E(Z_n^2)\lt \infty \). Como já sabemos que \(E(Z_n)=km^n\) é finita, a igualdade anterior mostra que \(E(Z_{n+1}^2)\lt \infty \). Portanto, por indução, todos os segundos momentos são finitos.
Podemos, então, calcular a variância subtraindo o quadrado da média. Usando \(E(Z_{n+1})=mE(Z_n)\), encontramos
Na última igualdade, usamos \(E(Z_n)=km^n\) e reconhecemos, entre parênteses, a variância de \(Z_n\).
Se \(m=1\), a recorrência se reduz a
Assim, a variância aumenta \(k\sigma ^2\) a cada geração. Como \(Z_0=k\) é constante, temos \(v_0=0\) e, portanto,
Os dois termos da recorrência têm origens diferentes. O primeiro mede a variabilidade produzida pela reprodução na geração atual; o segundo vem da variação no número de indivíduos que chegaram a essa geração.
Com um indivíduo inicial e média de um filho, temos
Se \(\sigma ^2\gt 0\), a média permanece constante, mas a variância cresce linearmente. Isso não significa que a população se mantenha perto de um indivíduo. Veremos que, nesse caso, ela acaba se extinguindo com probabilidade um.
Retomemos os multiplicadores de elétrons mencionados na abertura. Em cada etapa, um elétron pode provocar a emissão de novos elétrons, que seguem para a etapa seguinte. Considere dois modelos, nos quais os números de elétrons emitidos por impactos diferentes são independentes e seguem, em todas as etapas, as distribuições:
Os dois equipamentos começam com dois elétrons e possuem três etapas de amplificação. Qual deles produz, em média, mais elétrons na saída? Em qual o sinal final é menos variável?
Se \(Y_A\) e \(Y_B\) representam o número de elétrons emitidos por um impacto, as médias são iguais:
As variâncias, porém, são diferentes. Calculando os segundos momentos, obtemos
Denote por \(Z_n\) o número de elétrons após a etapa \(n\), com \(Z_0=2\). Como \(m=2\) nos dois modelos, o tamanho esperado da terceira geração é o mesmo:
Para calcular a variância, usamos a recorrência da Proposição 4.8. Com \(k=m=2\) e \(v_0=0\), ela fornece
Portanto,
Embora os dois equipamentos produzam o mesmo sinal médio, o modelo A apresenta menor variabilidade.
Há ainda outra diferença. Para que não reste nenhum elétron após a primeira etapa, os dois elétrons iniciais precisam deixar zero descendentes. Pela independência, essa probabilidade é
Assim, a mesma média de reprodução pode acompanhar comportamentos bastante distintos, tanto na variabilidade do sinal quanto na chance de ele desaparecer. Para estudar a extinção em um número qualquer de gerações, precisaremos considerar toda a distribuição de descendentes.
4.3.2 Geradoras e extinção
Para calcular a probabilidade de extinção, precisamos ir além do crescimento médio. Compare duas regras: na primeira, cada indivíduo tem exatamente um filho; na segunda, ele tem zero ou dois filhos, cada possibilidade com probabilidade \(1/2\). Ambas têm média um, mas, na primeira, a população permanece sempre com o mesmo tamanho, enquanto, na segunda, veremos que a extinção é certa. Para entender essa diferença, precisamos levar em conta toda a distribuição de filhos.
Da definição, vemos que \(f(0)=p_0\) e \(f(1)=1\). Cada coeficiente \(p_j\) registra a probabilidade de um indivíduo ter exatamente \(j\) filhos.
A principal vantagem da função geradora aparece quando somamos os números de filhos de indivíduos diferentes. Se \(Y_1\) e \(Y_2\) são independentes e têm a mesma distribuição de \(Y\), então
A segunda igualdade decorre da independência. Assim, a soma dos números de filhos corresponde ao produto das funções geradoras. Para \(i\) indivíduos que se reproduzem independentemente, o mesmo argumento mostra que a geradora do número total de filhos é \(f(s)^i\).
Para estudar a extinção, usaremos também a continuidade e a convexidade de \(f\), além de uma relação entre sua derivada e o número médio de filhos.
A notação \(f'(1-)\) indica a derivada em \(1\) tomada pela esquerda. A identidade \(f'(1-)=m\) mostra como a geradora recupera a média dos filhos; a última desigualdade compara seu gráfico com a reta tangente em \(1\).
Continuidade. Separamos a série que define \(f\) em uma soma finita e uma cauda. Como \(|s^j-t^j|\leq 1\) para \(s,t\in [0,1]\), para qualquer inteiro \(J\geq 0\) temos
Dado \(\varepsilon \gt 0\), escolha primeiro \(J\) para que a segunda soma seja menor que \(\varepsilon /2\). Isso é possível porque \(\sum _jp_j=1\). A primeira soma é finita e tende a zero quando \(s\) se aproxima de \(t\). Assim, com \(s\) suficientemente próximo de \(t\), ela também é menor que \(\varepsilon /2\). Esse argumento vale inclusive nos extremos \(0\) e \(1\).
Monotonicidade e convexidade. Cada função \(s^j\) é não decrescente e convexa em \([0,1]\). Para \(0\lt \theta \lt 1\),
Multiplicar por \(p_j\) e somar primeiro até \(J\) produz a mesma desigualdade para as somas parciais de \(f\). Fazer \(J\) crescer preserva a desigualdade e dá a convexidade de \(f\); a monotonicidade segue do mesmo argumento termo a termo. Se algum \(p_j\gt 0\) com \(j\geq 2\), esse termo satisfaz a desigualdade estrita sempre que \(s\ne t\), e os demais termos não a desfazem.
Derivada em \(1\) e reta tangente. Para encontrar a inclinação da geradora em \(1\), usaremos o quociente de diferenças, sem pressupor que podemos derivar a série termo a termo. Para \(0\leq s\lt 1\), a identidade da soma geométrica fornece
A igualdade pode ser obtida somando \(p_j(1-s^j)\) até \(J\) e fazendo \(J\) crescer, com \(s\) fixo. Cada parêntese é no máximo \(j\), de modo que o quociente não excede \(m\). Para obter uma cota inferior, fixamos \(J\) e conservamos apenas os primeiros termos:
Quando \(s\) se aproxima de \(1\), a soma à direita se aproxima de \(\sum _{j=1}^{J}jp_j\). Escolhendo primeiro \(J\) suficientemente grande e depois \(s\) suficientemente próximo de \(1\), tornamos essa cota tão próxima de \(m\) quanto desejarmos. Como o quociente nunca excede \(m\), seu limite é \(m\).
A cota superior também dá \(1-f(s)\leq m(1-s)\), que é a desigualdade da reta tangente. Se algum \(p_j\gt 0\) com \(j\geq 2\) e \(s\lt 1\), então \(1+s+\cdots +s^{j-1}\lt j\) nesse termo; a cota superior é estrita, como afirmado.
Para acompanhar várias gerações, escreva
com \(\mathbb P_k\) e \(E_k\) na convenção do Capítulo 2 para a cadeia iniciada em \(k\).
Enquanto o coeficiente \(p_j\) de \(f\) representa a probabilidade de um indivíduo ter exatamente \(j\) filhos, o coeficiente de \(s^j\) em \(F_n\) representa a probabilidade de a geração \(n\) conter exatamente \(j\) indivíduos, partindo de um único ancestral. Assim, \(f\) descreve a reprodução individual, enquanto \(F_n\) descreve a distribuição do tamanho da geração \(n\). O resultado a seguir relaciona essas geradoras por meio da composição de funções.
Como \(Z_0=1\), temos \(F_0(s)=E_1(s^{Z_0})=s\).
Para relacionar duas gerações consecutivas, condicionamos ao tamanho da geração \(n\). Se \(Z_n=i\), os números de filhos dos \(i\) indivíduos são independentes e têm a mesma distribuição de \(Y\). Portanto,
A igualdade vale também para \(i=0\): nesse caso, a geração seguinte é vazia, e o produto vazio vale um, inclusive quando \(s=0\), pela convenção \(0^0=1\).
Retirando o condicionamento pela esperança total, obtemos
onde a última igualdade usa a definição de \(F_n\), pois \(f(s)\in [0,1]\).
Partindo de \(F_0(s)=s\), a recorrência fornece, por indução, \(F_n=f^{\circ n}\). Por fim, como \(f^{\circ (n+1)}=f\circ f^{\circ n}\), também obtemos \(F_{n+1}=f\circ F_n\).
Por exemplo, \(F_1(s)=f(s)\) e \(F_2(s)=f(f(s))\). A cada nova geração, aplicamos \(f\) mais uma vez: trata-se de composição, não da potência \(f(s)^n\).
Se a população começa com \(k\) indivíduos, a geradora inicial é \(s^k\). O mesmo condicionamento e uma indução em \(n\) fornecem
Essa potência expressa a propriedade de ramificação: o tamanho da geração \(n\), partindo de \(k\) indivíduos, tem a mesma distribuição que a soma dos tamanhos de \(k\) populações independentes, cada uma iniciada com um indivíduo.
Voltemos agora à probabilidade de extinção. Considere o tempo
e escreva
para a probabilidade de a população se extinguir até a geração \(n\).
Como zero é absorvente, a extinção até a geração \(n\) equivale a termos \(Z_n=0\). Portanto,
Como \(Z_0=1\), temos \(q_0=0\). Além disso, pela Proposição 4.10,
A recorrência tem uma leitura genealógica. Para a população se extinguir até a geração \(n+1\), cada família fundada por um filho da primeira geração precisa desaparecer em no máximo \(n\) gerações adicionais. Se há \(i\) filhos, a probabilidade é \(q_n^i\). Retirando o condicionamento sobre o número de filhos, obtemos \(\sum _i p_iq_n^i=f(q_n)\). Além disso, \(q_n\) não diminui quando damos à população mais uma geração para se extinguir.
Como \(f(1)=1\), a equação de ponto fixo sempre admite a solução \(1\). Isso não significa que a extinção seja certa: quando há outras soluções, precisamos identificar qual delas representa essa probabilidade. A sequência que começa em \(q_0=0\) faz exatamente essa seleção, pois considera horizontes finitos cada vez maiores. A fórmula \(q^k\), por sua vez, decorre da independência entre as \(k\) famílias iniciais.
Os eventos \(\{ H_0\leq n\} \) aumentam para \(\{ H_0\lt \infty \} \). Pela continuidade das probabilidades de eventos crescentes, recordada na Proposição 2.9, temos \(q_n\uparrow q\). A continuidade de \(f\), provada na Proposição 4.9, permite passar ao limite em \(q_{n+1}=f(q_n)\) e concluir que \(q=f(q)\).
Se \(r\in [0,1]\) satisfaz \(f(r)=r\), então \(q_0=0\leq r\). Suponha \(q_n\leq r\). Como \(f\) é não decrescente,
A indução mostra que \(q_n\leq r\) para todo \(n\); tomando o limite, obtemos \(q\leq r\). Assim, nenhum outro ponto fixo em \([0,1]\) pode ser menor que a probabilidade de extinção.
Por fim, para uma população iniciada com \(k\) indivíduos, a fórmula da geradora e o fato de zero ser absorvente dão
Fazendo \(n\to \infty \), a mesma continuidade das probabilidades e a continuidade da potência \(s\mapsto s^k\) fornecem \(\mathbb P_k(H_0\lt \infty )=q^k\). Equivalentemente, cada uma das \(k\) famílias iniciais precisa se extinguir; a independência dessas famílias produz o mesmo fator \(q^k\).
A média de um filho por indivíduo separa os regimes. No caso crítico não degenerado, a esperança do tamanho da população permanece constante e, ainda assim, a extinção é certa. Quando \(m\gt 1\), há uma probabilidade positiva de sobrevivência; essa probabilidade só é igual a um se nenhum indivíduo puder ter zero filhos.
A equação \(f(s)=s\) pede os pontos em que o gráfico de \(y=f(s)\) encontra a diagonal \(y=s\). Um encontro sempre ocorre em \(s=1\). Nesse ponto, a inclinação da geradora é \(f'(1-)=m\); junto com a convexidade, ela determina o que pode acontecer à esquerda.
Se \(m\lt 1\), a tangente em \(1\) tem inclinação menor que a diagonal e fica acima dela à esquerda de \(1\). Pela convexidade, o gráfico de \(f\) fica sobre a tangente ou acima dela e, portanto, estritamente acima da diagonal para \(s\lt 1\). Não há outro ponto fixo.
Se \(m=1\) e a reprodução não é degenerada, a curva tem a mesma inclinação que a diagonal em \(1\), mas é estritamente convexa. Ela continua acima da diagonal para \(s\lt 1\), e a extinção também é certa.
Se \(m\gt 1\), a inclinação em \(1\) supera a da diagonal. Imediatamente à esquerda, temos \(f(s)\lt s\). Já em \(s=0\) vale \(f(0)=p_0\geq 0\); pela continuidade, há um ponto fixo abaixo de \(1\): ele é \(0\) quando \(p_0=0\) e pertence a \((0,1)\) quando \(p_0\gt 0\). Esse menor ponto fixo é a probabilidade de extinção.
Para \(m\lt 1\) e \(s\lt 1\), a desigualdade da reta tangente, justificada na Proposição 4.9, fornece
A desigualdade estrita vale porque \(1+m(s-1)-s=(1-m)(1-s)\gt 0\). Logo o único ponto fixo é \(1\), e o Teorema 4.11 dá \(q=1\). Se \(m=1\) e \(Y\) não é identicamente um, necessariamente \(\mathbb {P}(Y\geq 2)\gt 0\): caso contrário, \(Y\) só assumiria os valores \(0\) e \(1\), e a média um forçaria \(\mathbb {P}(Y=1)=1\). A desigualdade da reta tangente é então estrita para \(s\lt 1\): \(f(s)\gt 1+(s-1)=s\). Novamente, o único ponto fixo é \(1\), e \(q=1\).
Se \(m\gt 1\), o quociente \((1-f(s))/(1-s)\) é maior que um para \(s\lt 1\) suficientemente próximo de \(1\), pois seu limite é \(m\). Isso equivale a \(f(s)\lt s\) nessa região. Por outro lado, \(f(0)-0=p_0\geq 0\). Se \(p_0\gt 0\), a função contínua \(f(s)-s\) muda de sinal entre \(0\) e um ponto próximo de \(1\), logo se anula em \((0,1)\). Se \(p_0=0\), o próprio zero é ponto fixo. Em ambos os casos, o menor ponto fixo é menor que um. Quando \(Y=1\) quase certamente, cada indivíduo é substituído por exatamente um filho. A recursão dá \(Z_{n+1}=Z_n\) em todas as gerações; como \(Z_0=1\), nunca se atinge zero e \(q=0\).
A mesma distinção pode ser vista tomando a probabilidade de sobrevivência, em vez da de extinção, como incógnita. Para isso, definimos
Se \(q\) é a probabilidade de extinção, então \(\rho =1-q\) é a probabilidade de sobrevivência. Como \(f(q)=q\), temos \(\lambda (\rho )=\rho \). Como \(q\) é o menor ponto fixo de \(f\), \(\rho \) é o maior ponto fixo de \(\lambda \) em \([0,1]\).
Além disso, \(\lambda (0)=0\) e \(\lambda '(0+)=f'(1-)=m\): a inclinação que antes observávamos em \(1\) passa a ser vista na origem.
A Figura 4.5 compara os três regimes para uma distribuição que atribui probabilidade \(1-p\) a nenhum filho e probabilidade \(p\) a três filhos.
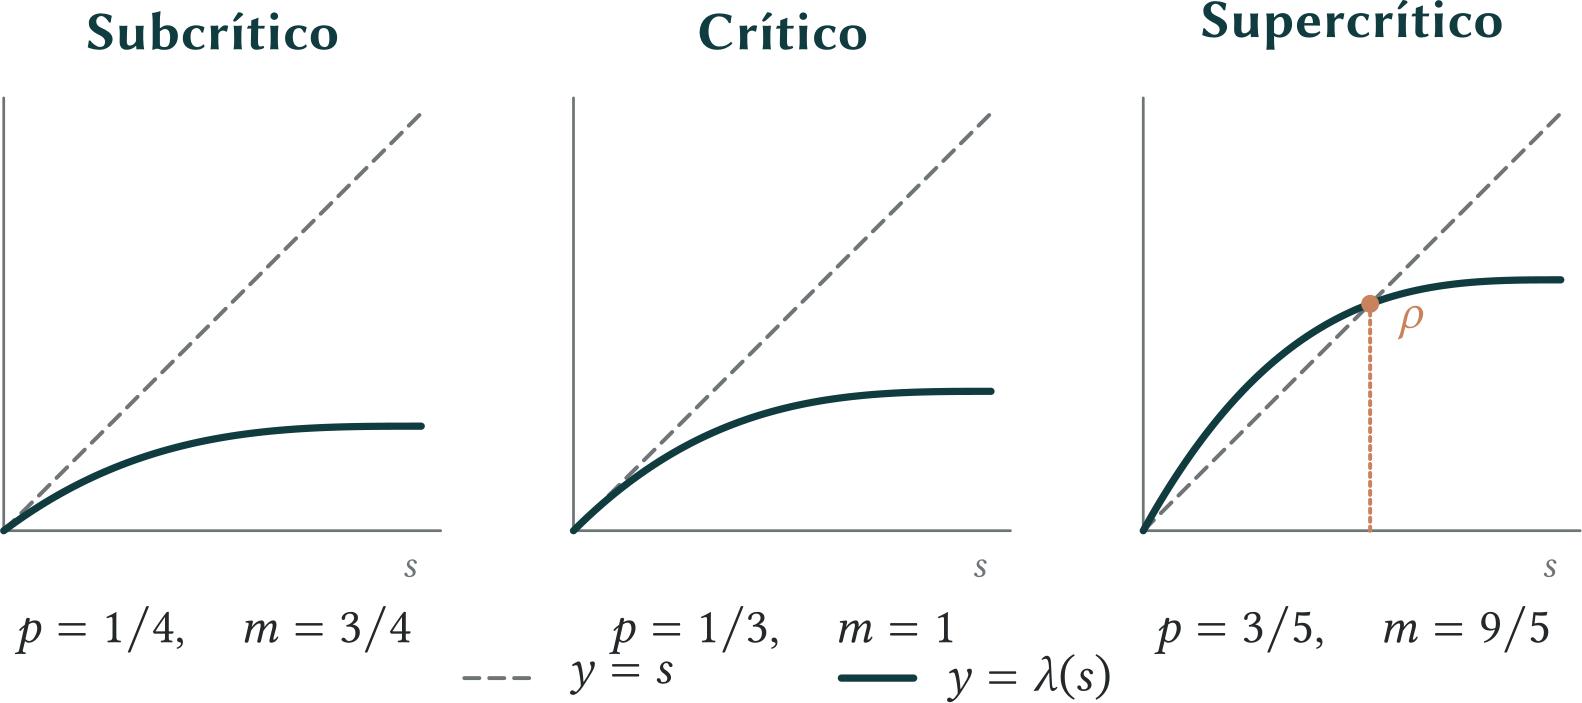
No último painel, com \(p=3/5\), obtemos \(\rho =(9-\sqrt{33})/6\approx 0{,}543\). A possibilidade de sobrevivência aparece, portanto, como um novo ponto de encontro entre a curva e a diagonal.
Podemos agora retomar as aplicações da abertura. Nas linhagens, a extinção significa não haver mais descendentes; nas reações em cadeia, significa que a sequência de fissões se encerrou. O critério se refere ao número médio de descendentes por indivíduo, contando também os que não deixam nenhum, e depende das hipóteses de reprodução independente e de uma mesma lei ao longo das gerações.
Nem toda aplicação, porém, acompanha um número ilimitado de gerações. Em um multiplicador com \(n\) etapas, iniciado por um elétron, a probabilidade de não haver elétrons na saída é \(q_n\), não \(q\). A quantidade \(q\) descreve a extinção eventual na idealização em que o mecanismo pode se repetir indefinidamente.
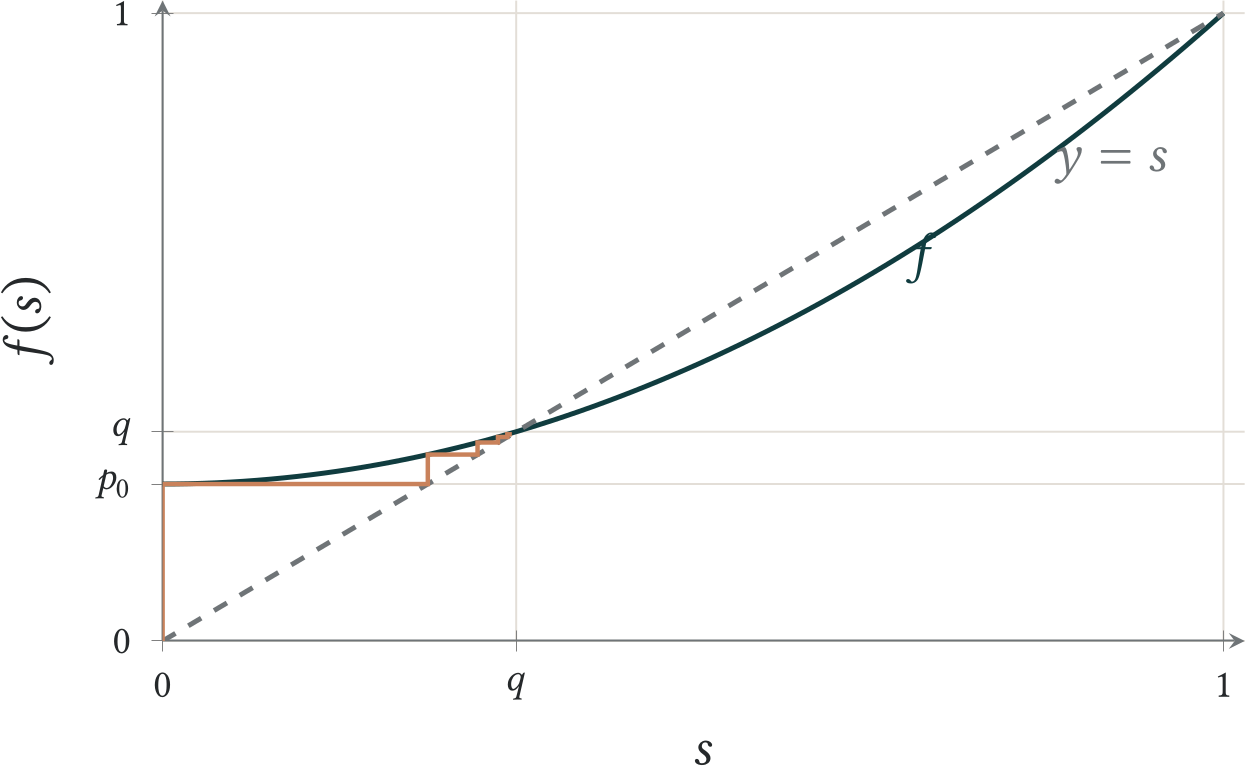
Na Figura 4.6, cada degrau parte de \((q_n,q_n)\), na diagonal, e sobe até \((q_n,q_{n+1})\), no gráfico de \(f\). O trecho horizontal leva então a \((q_{n+1},q_{n+1})\), de volta à diagonal. A iteração iniciada em zero se aproxima do menor ponto fixo sem ultrapassá-lo. Essa construção também permite visualizar o procedimento numérico usado no próximo exemplo.
Os exemplos anteriores mostram como calcular a probabilidade de extinção a partir de uma lei de descendentes. A próxima comparação mostra por que duas leis com a mesma média podem levar a respostas diferentes mesmo quando ambas são supercríticas.
Cada indivíduo produz dois descendentes, mas apenas os que sobrevivem até a idade de reprodução são contados na geração seguinte. Cada descendente tem probabilidade \(3/5\) de sobreviver. Compare duas regras para essa sobrevivência. Em ambas, famílias diferentes e gerações diferentes usam sorteios independentes.
Mortalidade independente. Os dois descendentes sobrevivem independentemente. O número \(Y_A\) dos que chegam à geração seguinte tem distribuição binomial com parâmetros \(2\) e \(3/5\), de modo que
Pode não sobreviver nenhum, apenas um ou ambos.
Mortalidade conjunta. Os dois descendentes sobrevivem juntos, com probabilidade \(3/5\), ou ambos morrem, com probabilidade \(2/5\). O número \(Y_B\) dos sobreviventes é, portanto, zero ou dois, e
Aqui a dependência está dentro de cada família: o resultado de uma família não determina o de outra.
As duas regras têm a mesma média,
Assim, começando com um indivíduo, ambas produzem o mesmo tamanho esperado \((6/5)^n\) na geração \(n\). Para comparar as probabilidades de extinção, procuramos os menores pontos fixos das geradoras. No primeiro caso,
logo \(q_A=4/9\). No segundo,
logo \(q_B=2/3\). A extinção é, portanto, mais provável sob a mortalidade conjunta, embora cada descendente tenha a mesma probabilidade individual de sobrevivência nos dois modelos.
As variâncias também diferem:
Na segunda regra, uma família inteira pode ser perdida de uma só vez; na primeira, um dos descendentes pode sobreviver mesmo quando o outro morre. A média de reprodução não distingue essas situações, mas a lei de descendentes e sua função geradora distinguem.
Até aqui, supusemos conhecida a distribuição de descendentes. Em uma aplicação, ela precisa ser estimada a partir das observações.
4.3.3 Cascatas: o que os dados permitem estimar
Em uma cascata de compartilhamentos, chamamos de filho uma transmissão direta. Se uma pessoa alcança outra e esta, por sua vez, alcança dez novas pessoas, a primeira teve um filho, não onze. Contar filhos não é o mesmo que contar todos os indivíduos atingidos: a primeira quantidade descreve a reprodução de cada participante; a segunda, o alcance acumulado da cascata.
Suponha que \(Y_1,\ldots ,Y_N\) sejam observações independentes, completamente acompanhadas, da mesma distribuição de filhos. Escreva \(N_j=\# \{ r:Y_r=j\} \), com \(N\gt 0\). A distribuição empírica e sua geradora são
Definimos \(\widehat q\) como a probabilidade de extinção do processo cuja distribuição de descendentes é \(\widehat p\). Pelo Teorema 4.11, ela é o menor ponto fixo de \(\widehat f\). Esses números descrevem o modelo ajustado; não quantificam a incerteza amostral, que não trataremos aqui.
A distribuição empírica também pode ser obtida procurando a lei que torna os resultados observados mais prováveis. Pela independência, a probabilidade desses resultados, sob uma lei \(p=(p_j)\), é
Vista como função da lei desconhecida \(p\), essa expressão é chamada de verossimilhança.
Uma categoria não observada recebe probabilidade zero no estimador, mas isso não prova que seja impossível na população. Se todas as categorias observadas têm probabilidade positiva, redistribuir entre elas, proporcionalmente, qualquer massa atribuída às demais aumenta a verossimilhança.
Seja \(J=\{ j:N_j\gt 0\} \) o conjunto das categorias observadas. Esse conjunto é finito, pois foram acompanhados apenas \(N\) indivíduos; assim, todas as somas de logaritmos a seguir são finitas. Se \(p_j=0\) para algum \(j\in J\), a verossimilhança se anula, enquanto \(\widehat p\) fornece um valor positivo. Basta, portanto, considerar distribuições com \(p_j\gt 0\) para todo \(j\in J\).
Escreva
para o logaritmo da verossimilhança. Como o logaritmo é crescente, maximizar \(\ell \) equivale a maximizar a verossimilhança. A desigualdade \(\log u\leq u-1\), para \(u\gt 0\), segue de que \(u-1-\log u\) decresce até \(u=1\) e cresce depois, atingindo ali o mínimo zero. Aplicando-a a cada razão positiva \(p_j/\widehat p_j\), obtemos
A última desigualdade usa apenas que a massa total de uma distribuição é um. A igualdade exige \(p_j=\widehat p_j\) para todo \(j\in J\), pois \(\log u=u-1\) apenas quando \(u=1\). Nesse caso, a massa em \(J\) já soma um, de modo que \(p_j=0\) fora de \(J\). Logo, \(p=\widehat p\), o que prova também a unicidade do maximizador.
Essa amostra não seria equivalente a reunir todos os indivíduos de uma única árvore que já terminou. Em uma árvore finita com \(N\) vértices, cada indivíduo, exceto a raiz, está ligado a seu pai por uma aresta. Há, portanto, \(N-1\) arestas, que correspondem aos \(N-1\) filhos contados na árvore inteira. A média observada seria forçosamente \((N-1)/N\lt 1\), independentemente da lei de reprodução subjacente. Selecionar apenas cascatas que terminaram pode, assim, esconder um mecanismo supercrítico; selecionar apenas cascatas grandes introduz outro viés.
Mesmo com uma amostra bem escolhida, precisamos examinar como os indivíduos foram acompanhados. Se a coleta termina antes de alguém ter oportunidade de produzir todos os seus filhos, há censura: um zero registrado pode ser apenas temporário. Em uma rede de contatos, duas linhagens também podem alcançar a mesma pessoa. Essas colisões rompem a estrutura de árvore do modelo.
Outras dificuldades dizem respeito à reprodução. Pessoas expostas ao mesmo contexto podem não se comportar de forma independente, e grupos ou gerações diferentes podem seguir leis distintas. Nesses casos, a dependência e a heterogeneidade limitam a descrição por uma única função geradora.
A interpretação de \(\widehat m\) e \(\widehat q\) depende, portanto, de como a amostra foi obtida. É preciso distinguir uma característica da reprodução de um efeito da seleção dos indivíduos ou da interrupção do acompanhamento.
Em uma rede finita, a sobrevivência eterna é uma idealização: o processo de Galton–Watson funciona sobretudo como uma aproximação inicial, antes que a saturação e as colisões passem a dominar a dinâmica. Depois dos problemas de síntese, a Seção 4.5 retoma essa limitação ao explorar grafos aleatórios. Para aprofundar a teoria clássica de ramificação e seus exercícios, veja Schinazi (1999, seção I.9).
4.4 Problemas de síntese
Os modelos deste capítulo levantam perguntas que não se resolvem olhando apenas uma transição. Na ruína sem barreira superior, precisamos escolher a solução correta de uma equação harmônica; no protocolo Aloha, determinar o crescimento de uma fila; na ramificação, distinguir tamanho esperado e probabilidade de extinção. Os três problemas a seguir retomam essas perguntas com as ferramentas já desenvolvidas.
Um jogador começa com \(i\geq 1\) unidades e, a cada rodada, ganha uma unidade com probabilidade \(p\in (0,1)\) ou perde uma unidade com probabilidade \(q=1-p\). O jogo termina ao atingir zero, mas não há limite superior para a fortuna.
Queremos \(h(i)=\mathbb P_i(H_0\lt \infty )\). Aqui \(h(i)\) representa a probabilidade de ruína sem uma barreira superior. Em contraste, \(u_i\) no Exemplo 2.33 representa a probabilidade de atingir a meta antes de zero no jogo com duas barreiras. Condicionando pelo primeiro passo,
No espaço infinito, essas equações não identificam sozinhas a probabilidade procurada: a função constante \(h(i)=1\) sempre as satisfaz. Precisamos de uma condição que selecione a solução correta.
Para isso, introduzimos provisoriamente uma barreira \(N\gt i\). A probabilidade \(h_N(i)=\mathbb P_i(H_0\lt H_N)\) já foi obtida na ruína finita:
Os eventos \(\{ H_0\lt H_N\} \) crescem com \(N\) e sua união é \(\{ H_0\lt \infty \} \): toda trajetória que chega a zero percorreu apenas um número finito de estados antes dessa chegada. A monotonicidade também pode ser vista diretamente: para atingir uma barreira mais distante antes de zero, o passeio precisa atravessar cada barreira mais próxima. Por outro lado, se \(H_0\lt \infty \), o máximo das posições até \(H_0\) é finito; qualquer \(N\) acima desse máximo satisfaz \(H_0\lt H_N\). Pela continuidade das probabilidades de eventos crescentes, basta, portanto, tomar \(N\to \infty \). Se \(p\lt q\), dividimos numerador e denominador de \(h_N(i)\) por \((q/p)^N\) e obtemos o limite um; se \(p\gt q\), usamos \((q/p)^N\to 0\). No caso \(p=q\), temos \(i/N\to 0\). Assim,
Por exemplo, se \(p=3/5\) e o jogador começa com duas unidades, a probabilidade de ruína é \((2/3)^2=4/9\). Logo, ele tem probabilidade \(5/9\) de nunca ficar sem dinheiro.
A resposta também é a menor solução não negativa das equações de primeiro passo com \(h(0)=1\). De fato, se \(u\geq 0\) é outra solução, seu valor no estado \(N\) é não negativo. Em \(\{ 0,\ldots ,N\} \), a função \(u\) é harmônica no interior. A chegada a uma das barreiras ocorre quase certamente: em qualquer bloco de \(N\) rodadas, uma sequência de \(N\) perdas, de probabilidade \(q^N\gt 0\), garante a chegada a zero se a chegada ainda não ocorreu. A probabilidade de permanecer no interior durante \(r\) blocos é, portanto, no máximo \((1-q^N)^r\), que tende a zero.
As probabilidades de atingir cada barreira são harmônicas no interior, por condicionamento no primeiro passo. A combinação dessas probabilidades com os valores de fronteira \(u(0)=1\) e \(u(N)\) tem os mesmos valores de \(u\) nas duas barreiras. Ela é a única função harmônica com esses dados: se a diferença entre duas soluções tivesse máximo positivo no interior, a equação de média ponderada, com \(p,q\gt 0\), obrigaria os dois vizinhos a terem o mesmo máximo. Repetindo o argumento, chegaríamos a uma barreira, onde a diferença é zero, uma contradição. Aplicar o mesmo raciocínio ao mínimo exclui uma diferença negativa. Logo, decompor segundo a primeira barreira atingida dá
Deixando \(N\to \infty \), obtemos \(u(i)\geq h(i)\). A condição de minimalidade seleciona, entre as soluções não negativas da equação harmônica, aquela que representa a probabilidade procurada.
O protocolo Aloha do Exemplo 4.2 tem chegadas independentes de uma mensagem com probabilidade \(3/4\) e de duas mensagens com probabilidade \(1/4\). Como vimos, o número total de transmissões bem-sucedidas é finito quase certamente, e a demonstração fornece
O diagrama da Figura 4.3 explica o mecanismo: quanto maior a fila de mensagens pendentes, mais provável é uma colisão.
A desigualdade da união e a série geométrica dão uma cota para os sucessos futuros:
Por exemplo, para \(n=22\) a cota é menor que \(0{,}05\). Portanto, com probabilidade superior a \(95\% \), não ocorre mais nenhuma transmissão bem-sucedida a partir desse instante, embora continuem chegando mensagens.
Para calcular o crescimento da fila, retomemos sua identidade:
A lei forte dos grandes números, aplicada às chegadas, dá
A soma de todos os \(I_k\) é finita quase certamente, logo sua contribuição dividida por \(n\) tende a zero. Concluímos que
Como o sistema realiza somente um número finito de transmissões bem-sucedidas, a fila cresce à taxa assintótica das próprias chegadas.
Duas populações começam com um único indivíduo. Em cada geração, seus descendentes reproduzem-se independentemente, segundo o modelo de Galton–Watson. Compare as seguintes leis para o número \(Y\) de filhos:
Nas duas populações a média de filhos é exatamente \(m=E(Y)=2\); portanto, o teorema do tamanho esperado da geração fornece
A igualdade das médias não implica igualdade das chances de sobrevivência. Na população A, todo indivíduo tem dois filhos. Começando com um indivíduo, \(Z_n=2^n\) em todas as trajetórias e a extinção é impossível.
Na população B, a função geradora é
Pelo teorema da extinção, a probabilidade \(q\) de desaparecimento é o menor ponto fixo de \(f\). A equação \(f(q)=q\) equivale a
As raízes são \(1\), \((-1+\sqrt3)/2\) e \((-1-\sqrt3)/2\). A última é negativa e, entre os dois pontos fixos de \([0,1]\), devemos escolher o menor:
Embora seu tamanho esperado cresça como \(2^n\), essa população desaparece com probabilidade superior a \(36\% \).
As probabilidades de extinção em horizontes finitos permitem acompanhar essa aproximação. Na primeira geração, a extinção tem probabilidade \(q_1=1/3\). Até a segunda geração,
e as iterações seguintes aumentam até \(q\). Com três indivíduos iniciais, cujas famílias são independentes, a extinção eventual tem probabilidade \(q^3\approx 0{,}049\).
A média \(m\) determina o crescimento esperado de cada geração e separa regimes de reprodução. Ela não determina, sozinha, a chance de extinção: essa probabilidade depende da distribuição completa de descendentes, resumida pela função geradora.
Nos três problemas, uma conta local só ganha sentido quando a relacionamos ao comportamento de longo prazo. Na ruína, a minimalidade seleciona a probabilidade correta; no Aloha, a soma dos sucessos determina a taxa de crescimento da fila; na ramificação, a distribuição dos filhos distingue crescimento esperado e chance de sobrevivência.
4.5 Percolação em árvores e grafos aleatórios*
Até aqui, usamos processos de ramificação para acompanhar o número de indivíduos de cada geração. Podemos fazer uma pergunta semelhante em uma rede: se cada ligação estiver disponível apenas com certa probabilidade, quantos vértices poderão ser alcançados a partir de um vértice inicial?
A resposta é particularmente simples quando a rede tem a forma de uma árvore. Nesse caso, os vértices alcançados se organizam em gerações, como em uma árvore genealógica, e a relação com Galton–Watson é exata. Em um grafo aleatório com ciclos, essa relação deixa de ser exata, mas ainda ajuda a explicar quando surge uma componente que reúne uma fração considerável dos vértices.
Denotaremos por \(C(v)\) a componente aberta de \(v\): o conjunto de vértices que podem ser alcançados a partir de \(v\) por caminhos de arestas abertas, incluindo o próprio \(v\). Se o grafo for infinito, uma questão natural será saber quando \(C(v)\) também pode ser infinita.
4.5.1 Percolação em uma árvore infinita
Considere uma árvore infinita enraizada em \(o\), na qual cada vértice tem exatamente \(b\geq 2\) filhos. Como se trata de uma árvore, cada vértice diferente da raiz tem um único pai. A raiz forma a geração zero, seus filhos formam a geração um, e assim por diante. Suponha que cada aresta seja aberta, independentemente das demais, com probabilidade \(p\).
Seja \(Z_n\) o número de vértices da geração \(n\) que podem ser alcançados a partir da raiz usando somente arestas abertas. Em particular, \(Z_0=1\). Um vértice alcançado pode dar acesso a alguns de seus \(b\) filhos: somente aqueles ligados a ele por uma aresta aberta.
A distribuição binomial aparece porque cada vértice possui \(b\) possibilidades de alcançar um filho, e cada uma delas ocorre com probabilidade \(p\). A independência das arestas garante a independência das reproduções.
Suponha conhecidos os vértices alcançados até a geração \(n\). Para cada um dos \(Z_n\) vértices alcançados nessa geração, examinamos as \(b\) arestas que o ligam aos filhos. Essas arestas ainda não foram examinadas e são independentes das utilizadas nas gerações anteriores.
Assim, o número \(Y_{n,r}\) de filhos alcançados a partir do \(r\)-ésimo vértice tem distribuição binomial de parâmetros \(b\) e \(p\). Dois vértices distintos têm conjuntos disjuntos de arestas para seus filhos. Além disso, em uma árvore, um filho só pode ser alcançado por meio de seu próprio pai: não há caminhos alternativos que levem a contá-lo duas vezes. A independência das arestas permite, portanto, associar a cada vértice uma reprodução independente, sempre com a mesma lei binomial. Assim, essas variáveis são independentes entre si e entre gerações, e
Esta é exatamente a construção da Definição 4.2. Por fim, a fórmula binomial fornece
Para calcular a média, escreva \(Y\) como a soma dos \(b\) indicadores de abertura das arestas que ligam um vértice a seus filhos. Cada indicador tem esperança \(p\); pela linearidade da esperança, \(m=E(Y)=bp\).
Como as gerações são disjuntas e cada uma contém no máximo \(b^n\) vértices, o tamanho da componente da raiz é
Essa componente é infinita precisamente quando \((Z_n)\) nunca se extingue. Se alguma geração está vazia, todas as seguintes também estarão, e a soma terá apenas um número finito de termos não nulos. Por outro lado, se \(Z_n\geq 1\) para todo \(n\), a soma é infinita.
A probabilidade crítica é o limiar
O teorema mostra que \(p_c=1/b\). Até esse valor, inclusive no ponto crítico, a componente da raiz é finita quase certamente. Acima dele, surge uma probabilidade positiva de ela ser infinita, embora a extinção continue possível enquanto \(p\lt 1\).
Pela Proposição 4.14, a média de descendentes é \(m=bp\). Se \(p\lt 1/b\), então \(m\lt 1\) e o processo se extingue quase certamente. No ponto \(p=1/b\), temos \(m=1\). Como \(b\geq 2\), a binomial correspondente não é a distribuição degenerada \(Y=1\): em particular, \(\mathbb P(Y=0)=(1-1/b)^b\gt 0\). Também nesse caso a extinção é certa.
Se \(p\gt 1/b\), então \(m\gt 1\) e a sobrevivência tem probabilidade positiva. Essas são exatamente as conclusões do Teorema 4.12. A equivalência entre sobrevivência e componente infinita dá as afirmações sobre \(\theta (p)\).
Pelo Teorema 4.11, a probabilidade de extinção é a menor solução de \(f(q)=q\). Como \(\theta (p)\) é a probabilidade do evento complementar à extinção, temos \(q=1-\theta (p)\). Substituir \(f(s)=(1-p+ps)^b\) fornece a equação indicada.
Também podemos escrever a equação em termos da probabilidade de percolação. Substituindo \(q=1-\theta (p)\), obtemos
Quando \(p\leq p_c\), a única solução em \([0,1]\) é zero. Quando \(p\gt p_c\), existe também uma solução positiva, e é ela que corresponde à probabilidade de percolação: trata-se da maior solução em \([0,1]\). Isso decorre da mudança de variável \(\theta =1-q\), que inverte a ordem das soluções: o menor ponto fixo na variável \(q\) corresponde à maior solução na variável \(\theta \).
Suponha que cada vértice tenha dois filhos e que cada aresta esteja aberta com probabilidade \(3/4\). Nesse caso,
A equação de extinção é
ou, equivalentemente,
Como a probabilidade de extinção é o menor ponto fixo, \(q=1/9\). Portanto,
Compare com o Exemplo 4.5, em que cada indivíduo tinha zero ou dois filhos, com probabilidades \(1/4\) e \(3/4\). A média de descendentes também era \(3/2\), mas a probabilidade de extinção era \(1/3\), não \(1/9\). A chance de alcançar infinitos vértices depende da distribuição dos descendentes, não apenas de sua média.
Há ainda uma distinção entre a extinção e o tamanho esperado da componente. Para calcular \(E(|C(o)|)\) a partir da soma das gerações, começamos pela contagem até uma geração finita:
A última igualdade usa o Teorema 4.7 e a linearidade da esperança. Como \(B_N\) cresce para \(|C(o)|\), a passagem ao limite para contagens crescentes, justificada no Lema 2.15, fornece
No ponto crítico \(p=1/b\), a componente da raiz é finita quase certamente, mas seu tamanho esperado é infinito. Não há contradição: o fato de uma variável aleatória ser finita quase certamente não obriga sua esperança a ser finita.
4.5.2 Erdős–Rényi: da exploração local à componente gigante
Uma árvore não tem ciclos: cada vértice distinto da raiz está ligado a ela por um único caminho simples, isto é, sem repetir vértices. Em uma rede geral, podemos encontrar um mesmo vértice por caminhos diferentes. Essas colisões impedem que a exploração da componente seja, exatamente, um processo de Galton–Watson.
Ainda assim, a ramificação descreve bem o início da exploração de certos grafos aleatórios. O exemplo mais conhecido é o modelo de Erdős–Rényi.
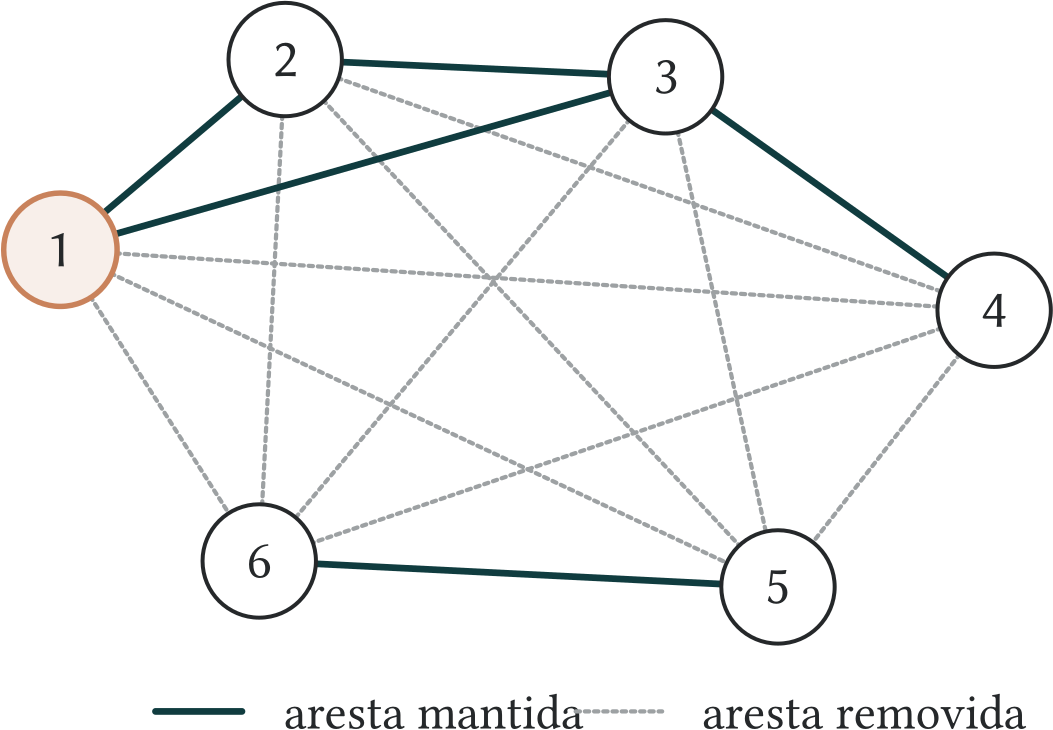
Trata-se da percolação por arestas no grafo completo com \(n\) vértices: começamos com todas as arestas possíveis e conservamos cada uma delas com probabilidade \(p\). A Figura 4.9 mostra uma realização com seis vértices.
Para estudar grafos grandes, escolheremos
com \(n\) suficientemente grande para que \(c/n\leq 1\). Essa escolha mantém o número médio de vizinhos por vértice próximo de \(c\). De fato, se \(D_v\) é o número de vizinhos, ou grau, de um vértice \(v\), então
Quando \(n\) cresce, temos muitas possibilidades de ligação, cada uma com probabilidade pequena. Para cada \(j\) fixo,
Para verificar esse limite, observe que
com produto vazio igual a um quando \(j=0\), enquanto \((1-c/n)^{n-1-j}\to e^{-c}\). Assim, o número de vizinhos de um vértice fixado tem, no limite, distribuição de Poisson de média \(c\).
Mas conhecer a distribuição do grau não basta para entender o tamanho de uma componente. Precisamos acompanhar sua exploração. Começamos por um vértice e o colocamos em uma fila. Ao examinar o primeiro vértice da fila, revelamos suas arestas para os vértices ainda não descobertos. Os novos vizinhos entram no fim da fila, e o vértice examinado sai dela. Repetimos esse procedimento até a fila ficar vazia; nesse momento, toda a componente inicial foi descoberta.
Suponha que a fila ainda não esteja vazia e que, até essa etapa, tenham sido descobertos \(r\) vértices: o inicial e todos os novos vizinhos encontrados nos passos anteriores. Esse total inclui os já examinados e os que ainda aguardam na fila. Restam \(n-r\) vértices não descobertos, e as arestas entre eles e o próximo vértice a ser examinado ainda não foram reveladas. Condicionalmente ao histórico da exploração, o número de novos vizinhos tem, portanto, distribuição
Ao contrário de uma ramificação com descendentes independentes, a distribuição dessas contagens muda ao longo da exploração: \(r\) depende dos resultados dos passos anteriores. Mas, enquanto \(r\) for pequeno em comparação com \(n\), a distribuição acima se aproxima de uma Poisson de média \(c\). Para um número fixo de etapas, essa aproximação pode ser tornada rigorosa quando \(n\to \infty \): a exploração é descrita, no limite, por uma ramificação com descendências independentes de lei Poisson de média \(c\), encerrada se não houver mais vértices por examinar.
Essa descrição é local. Em um grafo com ciclos, podem existir arestas entre vértices já descobertos, mas essas ligações não acrescentam novos elementos à fila. Na exploração, só podem ser novos vizinhos os \(n-r\) vértices ainda não descobertos. Quando \(r\) deixa de ser pequeno diante de \(n\), a média condicional \((n-r)c/n\) já não está próxima de \(c\), e a aproximação por Galton–Watson não descreve sozinha a exploração de uma componente grande.
Para a distribuição de Poisson de média \(c\), a função geradora é
O Teorema 4.12 sugere, portanto, uma mudança de comportamento em \(c=1\): abaixo desse valor a ramificação se extingue quase certamente; acima dele há probabilidade positiva de sobrevivência. O resultado para o grafo finito é mais forte e exige argumentos adicionais.
Componente gigante em Erdős–Rényi Considere \(G(n,c/n)\), com \(c\gt 0\) fixo, e denote por \(L_1(n)\geq L_2(n)\) os tamanhos das duas maiores componentes conexas, com \(L_2(n)=0\) se houver apenas uma componente.
Se \(0\lt c\lt 1\), existe uma constante \(A=A(c)\) tal que
\[ \mathbb {P}\bigl(L_1(n)\leq A\log n\bigr)\longrightarrow 1. \]Se \(c\gt 1\), então
\[ \frac{L_1(n)}n\longrightarrow \rho (c) \quad \text{em probabilidade}, \]onde \(\rho (c)\in (0,1)\) é a única solução positiva de
\[ \rho =1-e^{-c\rho }. \]Além disso, existe uma constante \(B=B(c)\) tal que
\[ \mathbb {P}\bigl(L_2(n)\leq B\log n\bigr)\longrightarrow 1. \]
A convergência em probabilidade no segundo item significa que, para todo \(\varepsilon \gt 0\),
Portanto, a fração de vértices na maior componente se concentra perto de \(\rho (c)\) quando o grafo cresce.
Uma componente que reúne uma proporção positiva dos vértices é chamada de componente gigante. O teorema afirma que ela não aparece no regime subcrítico e que, no supercrítico, existe uma única componente desse tipo: todas as demais têm tamanho muito menor que \(n\). No ponto crítico \(c=1\), não há componente gigante; o tamanho das maiores componentes está na escala \(n^{2/3}\), um comportamento mais delicado que não estudaremos aqui.
Não demonstraremos esse resultado; uma apresentação com demonstrações dos três regimes está em Frieze e Karoński (2016, capítulo 2). A aproximação local por Galton–Watson explica a origem da equação para \(\rho (c)\), mas não é suficiente para justificar a existência e a unicidade de uma componente gigante. Para isso, é necessário controlar a exploração também quando o número de vértices descobertos já é grande.
A equação do teorema é precisamente a equação de sobrevivência para um processo de Galton–Watson de descendência Poisson de média \(c\). Com efeito, se \(q\) é sua probabilidade de extinção,
Escrevendo \(\rho (c)=1-q\), encontramos
Essa coincidência tem uma interpretação probabilística. Depois de realizado o grafo, escolha um de seus \(n\) vértices uniformemente. A probabilidade de ele pertencer à maior componente, condicionada ao grafo, é \(L_1(n)/n\), que pelo teorema fica próxima de \(\rho (c)\) com alta probabilidade. Por outro lado, a exploração iniciada nesse vértice se aproxima, nas primeiras etapas, de uma ramificação Poisson: a chance de essa ramificação sobreviver sugere a proporção de vértices que pertencem à componente gigante. Essa interpretação não substitui os argumentos globais necessários à prova do teorema.
Considere \(G(n,2/n)\). No Exemplo 4.6, vimos que a probabilidade de extinção de uma ramificação com descendência Poisson de média \(2\) é aproximadamente \(q=0{,}203188\). Portanto,
Em um grafo suficientemente grande desse modelo, a maior componente ocupa uma proporção próxima de \(79{,}7\% \) dos vértices, com alta probabilidade.
Isso não significa que o grafo inteiro seja conexo. Um vértice específico é isolado quando nenhuma de suas \(n-1\) arestas possíveis está presente, o que ocorre com probabilidade
Pela linearidade da esperança, a proporção esperada de vértices isolados também se aproxima de \(13{,}5\% \). A existência de uma componente gigante não é o mesmo que a conectividade de todo o grafo.
Nos dois modelos, a média de descendentes igual a um marca a transição. Na árvore, alcançar novos vértices é exatamente um processo de ramificação. Em Erdős–Rényi, essa descrição vale aproximadamente no início da exploração, mas antecipa uma propriedade global do grafo. O que começou como uma pergunta sobre extinção torna-se uma pergunta sobre o aparecimento de grandes estruturas em uma rede.
4.6 Exercícios
4.6.1 Passeios e outras cadeias enumeráveis
4.6.2 Processos de ramificação