Cadeias de Markov finitas
Um jogo termina ao atingir uma barreira; uma rede de memória procura corrigir uma entrada; um usuário pode voltar a um serviço ou abandoná-lo. A descrição de cada sistema começa pela escolha do estado, que deve conservar a informação necessária para prever o próximo passo.
Os modelos finitos permitem construir matrizes de transição, classificar estados e estudar retornos e saídas por meio de contas explícitas. O equilíbrio e a convergência serão tratados no capítulo seguinte. Os modelos ocultos de Markov encerram o percurso como aplicação complementar; PageRank e colônias de formigas acompanham o estudo do comportamento limite.
Uma rede que recupera uma lembrança
Reconhecemos uma letra mesmo quando alguns traços estão apagados. Uma memória associativa recebe uma configuração incompleta ou corrompida e a modifica para aproximá-la de um padrão armazenado. Um modelo mínimo desse mecanismo introduz a escolha do estado e sua evolução aleatória.
Representamos cada neurônio por uma unidade que pode estar inativa ou ativa. A configuração de uma rede com \(N\) unidades neuronais no instante \(n\) é o vetor
Essa variável binária também é chamada de spin, por analogia com modelos da física. O peso \(w_{ij}\) mede a influência de \(j\) sobre \(i\); nesta primeira versão, \(w_{ij}=w_{ji}\) e \(w_{ii}=0\). O campo local na unidade \(i\) é
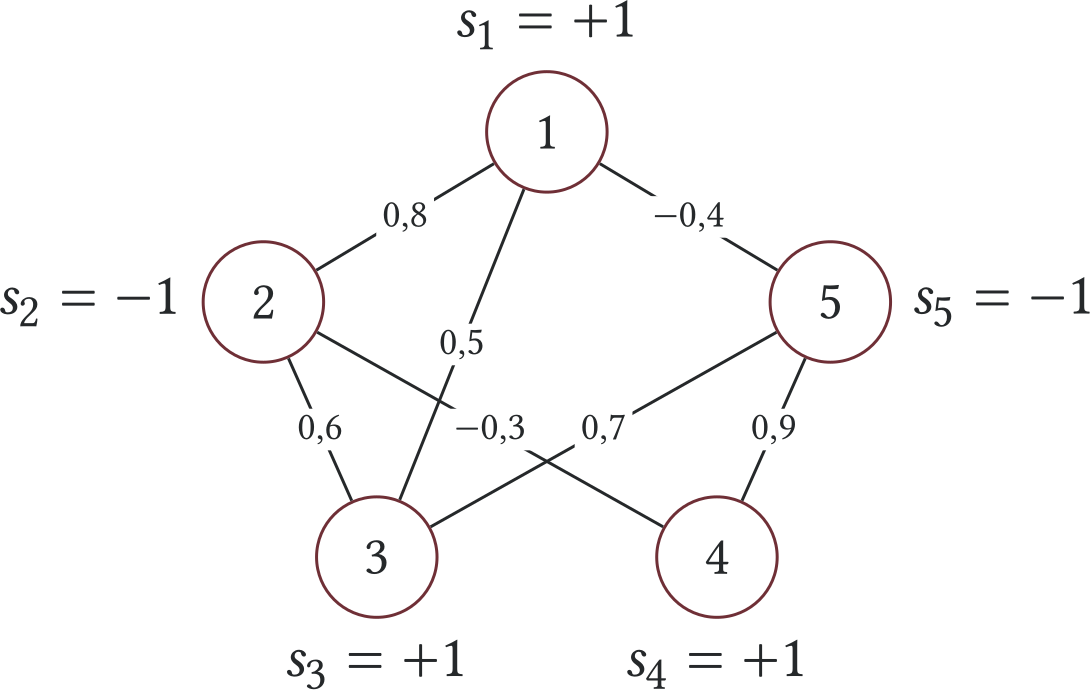
Em cada passo, escolhemos aleatoriamente uma das \(N\) unidades, todas com probabilidade \(1/N\), independentemente das escolhas anteriores. Apenas a unidade escolhida é atualizada: essa é uma dinâmica assíncrona. Se ela é a unidade \(i\), tomamos \(s_i(n+1)=+1\) quando \(h_i(s(n))\gt 0\) e \(s_i(n+1)=-1\) quando \(h_i(s(n))\lt 0\); se \(h_i(s(n))=0\), conservamos o valor anterior, \(s_i(n+1)=s_i(n)\). Para \(j\ne i\), fazemos \(s_j(n+1)=s_j(n)\).
A escolha aleatória da unidade a atualizar determina, a partir da configuração atual, a distribuição da configuração seguinte.
Aprendizado e recuperação são tarefas distintas. No aprendizado, escolhemos os pesos a partir dos padrões que desejamos guardar. Na recuperação, fixamos esses pesos e deixamos a configuração evoluir a partir da entrada recebida. A rede não precisa consultar uma lista de padrões a cada atualização: a informação foi incorporada às interações.
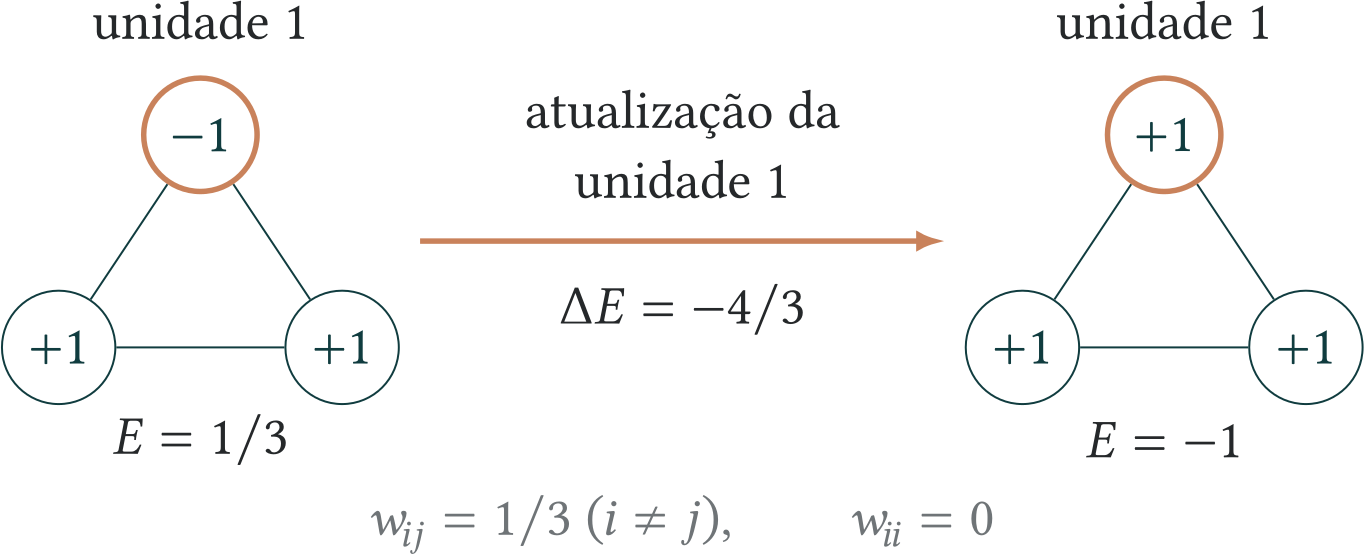
Para guardar o padrão \(\xi =(+1,+1,+1)\) em três unidades, tomemos \(w_{ij}=1/3\) para \(i\ne j\). Se a entrada é \(s(0)=(-1,+1,+1)\), então
A atualização da primeira unidade corrige o spin errado. Podemos acompanhar essa correção por uma energia,
As energias antes e depois da correção são
A mudança é \(-4/3\). Mais geralmente, ao alterar apenas a unidade \(i\), a simetria dos pesos dá
A energia não aumenta com a atualização. Isso não garante que toda entrada chegue ao padrão desejado: podem existir outros estados estáveis, e o armazenamento de muitos padrões pode gerar interferência entre eles.
Conhecida a configuração \(s(n)\), a escolha aleatória da unidade determina a lei de \(s(n+1)\) sem depender das configurações anteriores. O processo \((s(n))_{n\geq 0}\) é, portanto, uma cadeia de Markov no espaço \(\{ -1,+1\} ^N\).
O estudo da rede envolve a identificação de configurações estáveis, os tempos de chegada a essas configurações e a influência da aleatoriedade. O capítulo de MCMC retomará a rede de Hopfield com a definição completa, a demonstração de descida da energia, um exemplo com duas letras e a passagem para atualizações de Gibbs.
2.1 Definições e exemplos
As definições e vários resultados também valem para espaços enumeráveis, mas neste capítulo privilegiaremos os modelos finitos. O Capítulo 4 estudará os fenômenos próprios dos espaços infinitos. A seção opcional sobre colônias de formigas, no Capítulo 3, apresenta uma dinâmica com estado contínuo.
A distribuição inicial e as probabilidades de transição determinam a lei da trajetória. O estado \(X_n\) deve reunir a informação do passado relevante para prever o passo seguinte. Quando essa informação é insuficiente, pode ser necessário ampliar o estado.
Cadeia homogênea e matriz de transição A cadeia é homogênea no tempo quando
não depende de \(n\). A matriz \(P=(p(i,j))_{i,j\in S}\) é sua matriz de transição. Suas entradas são não negativas e cada linha soma \(1\).
Na entrada \(p(i,j)\), a linha \(i\) representa o estado atual e a coluna \(j\) representa o próximo estado. Portanto,
para cada \(i\): partindo de \(i\), a cadeia precisa estar em algum estado no passo seguinte.
A matriz descreve uma transição. Para calcular a probabilidade de uma trajetória inteira, basta aplicar repetidamente a regra do produto para probabilidades condicionais.
Para \(n=0\), a igualdade é a definição de \(\mu \). Suponha que ela valha até o instante \(n\). Quando a história \(X_0=i_0,\ldots ,X_n=i_n\) tem probabilidade positiva, a regra do produto e a propriedade de Markov dão
Se a história tem probabilidade zero, a trajetória mais longa também tem probabilidade zero, e o produto no enunciado já é nulo. Isso conclui a indução.
O mesmo cálculo explica por que podemos condicionar em informações parciais do passado, sem precisar conhecer todos os estados visitados.
Primeiro considere uma história completa \(X_0=i_0,\ldots ,X_n=i\). A regra do produto aplicada à história e à sua continuação mostra que a probabilidade condicional dos próximos \(m\) estados é o produto anunciado; os fatores anteriores ao instante \(n\) se cancelam.
Como \(S\) é finito, o evento \(A\cap \{ X_n=i\} \) é união disjunta de histórias completas até \(n\). Em cada história de probabilidade positiva, a probabilidade condicional da continuação é a mesma. Somando sobre essas histórias, obtemos a igualdade para \(A\), sem depender dos estados anteriores a \(n\).
A prova é por indução em \(m\). Para \(m=1\), a afirmação é exatamente a definição de homogeneidade.
Suponha agora que, para algum \(m\geq 1\), as probabilidades
não dependam de \(n\). Condicionando no estado intermediário \(X_{n+m}\) e usando o Corolário 2.2 para o passado \(X_n=i\),
Pela hipótese de indução, o lado direito não depende de \(n\). Isso conclui a indução.
A homogeneidade em um passo estende-se, portanto, a qualquer número fixo de passos.
Um sapo ocupa uma de quatro folhas, que chamaremos de \(A\), \(B\), \(C\) e \(D\). Nem toda folha está ao alcance de qualquer outra: as ligações possíveis são as indicadas no grafo abaixo. A cada passo, o sapo escolhe uniformemente uma das folhas ligadas à folha em que se encontra. Se \(X_n\) indica a folha ocupada depois do \(n\)-ésimo salto, então \((X_n)\) é uma cadeia de Markov: conhecida a folha atual, o próximo salto não depende do caminho percorrido antes.
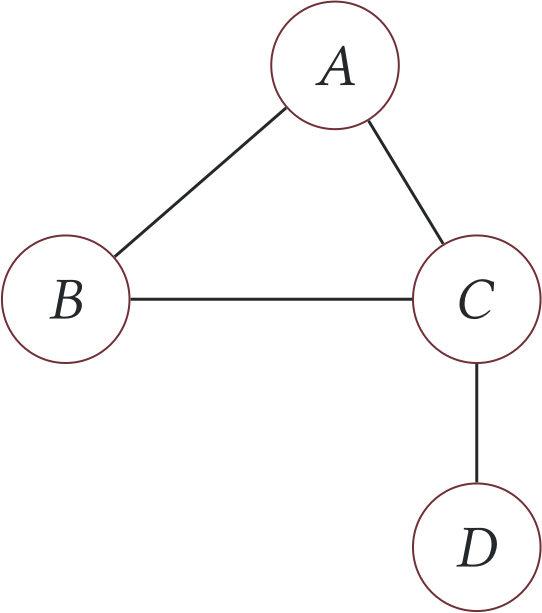
Na ordem \((A,B,C,D)\), as probabilidades são obtidas contando os vizinhos de cada folha. A matriz de transição é
Daqui em diante, salvo indicação contrária, consideraremos cadeias homogêneas no tempo. Nas fórmulas de probabilidades condicionais, entenderemos sempre que o evento condicionado tem probabilidade positiva. A matriz de transição especifica a dinâmica a partir de cada estado, inclusive daqueles que têm probabilidade inicial zero.
Considere um jogo com rodadas independentes. Em cada rodada, o jogador ganha uma unidade monetária com probabilidade \(p=0{,}4\) ou perde uma unidade com probabilidade \(1-p=0{,}6\). O jogo termina quando sua fortuna atinge \(0\) ou \(N\) unidades monetárias.
Se \(X_n\) é a fortuna depois de \(n\) rodadas, então, para \(0\lt i\lt N\) e qualquer histórico compatível,
O lado direito depende apenas da fortuna presente, de modo que a propriedade de Markov vale. As transições são
Para \(N=5\), o grafo de transição torna visíveis as duas possibilidades em cada estado interior e as duas barreiras absorventes:
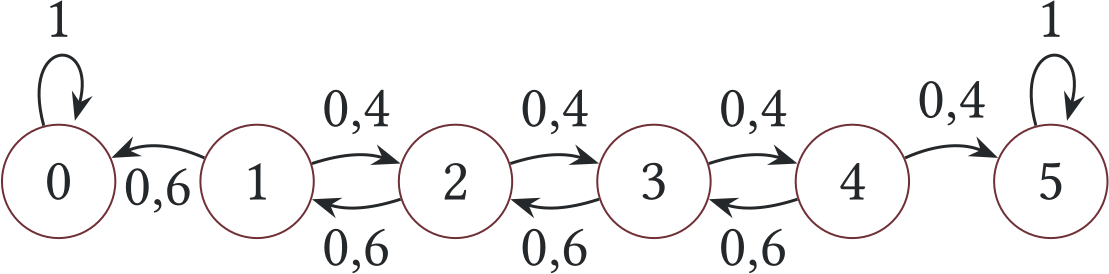
A matriz correspondente é
| 0 | 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|---|
| 0 | 1{,}0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 0{,}6 | 0 | 0{,}4 | 0 | 0 | 0 |
| 2 | 0 | 0{,}6 | 0 | 0{,}4 | 0 | 0 |
| 3 | 0 | 0 | 0{,}6 | 0 | 0{,}4 | 0 |
| 4 | 0 | 0 | 0 | 0{,}6 | 0 | 0{,}4 |
| 5 | 0 | 0 | 0 | 0 | 0 | 1{,}0 |
Os estados 0 e \(N\) são absorventes: quando a fortuna atinge uma das barreiras, o jogo termina.
Para distinguir um caminho particular de uma probabilidade de transição, considere a trajetória
Ela tem probabilidade \(0{,}4(0{,}6)^3=0{,}0864\). A figura mostra essa realização; outras sequências também podem levar à ruína.
Esta cadeia surgiu na física como um modelo simplificado da troca de partículas entre dois recipientes. Na versão matemática, distribuímos \(N\geq 1\) bolas entre duas urnas. A cada passo, escolhemos uma das \(N\) bolas ao acaso e a transferimos para a outra urna.
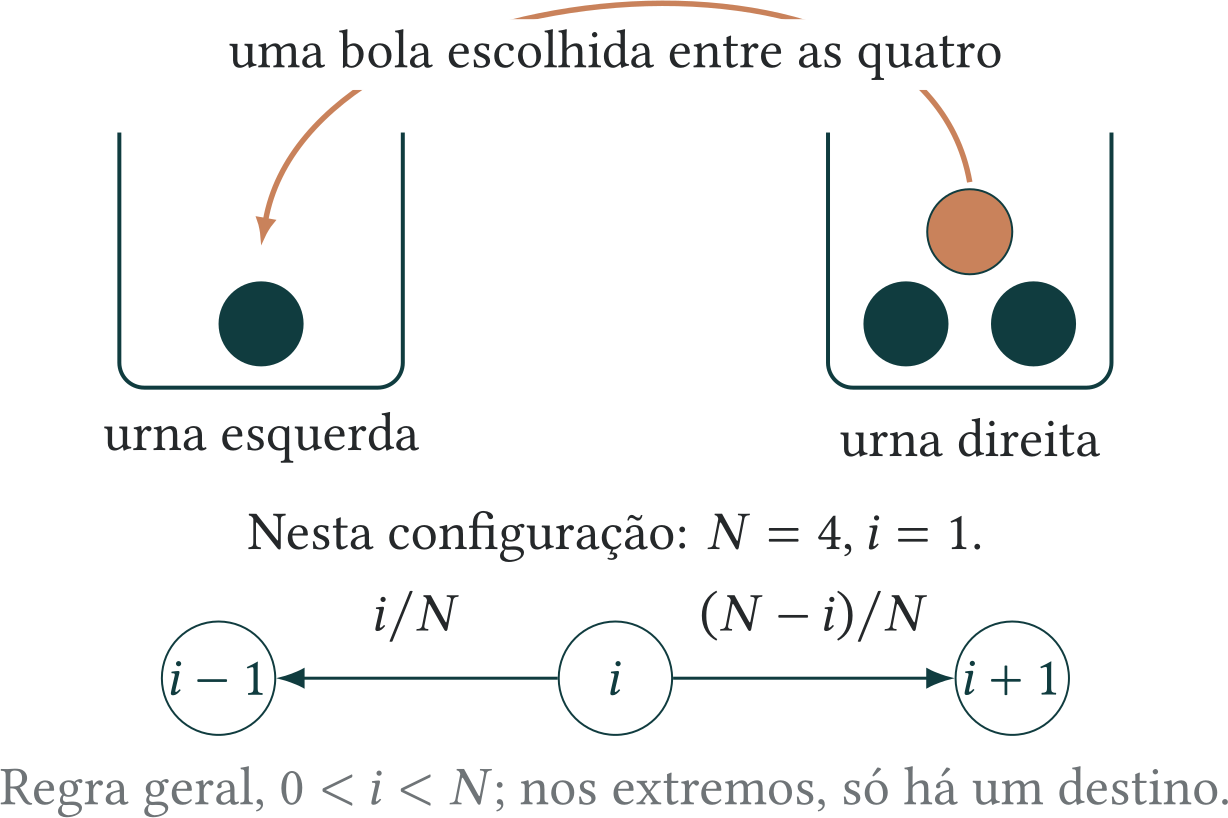
Seja \(X_n\) o número de bolas na urna esquerda depois do \(n\)-ésimo passo. Conhecer \(X_n=i\) basta para determinar as probabilidades do passo seguinte: há \(N-i\) bolas na urna direita e \(i\) na esquerda. Assim, para \(0\leq i\lt N\),
pois \(X_n\) aumenta quando a bola escolhida está na urna direita. Do mesmo modo, \(X_n\) diminui em uma unidade com probabilidade \(i/N\). Logo,
e \(p(i,j)=0\) nos demais casos. Quando \(N=4\), por exemplo, a matriz é
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 0 | 0 | 0 |
| 1 | 1/4 | 0 | 3/4 | 0 | 0 |
| 2 | 0 | 2/4 | 0 | 2/4 | 0 |
| 3 | 0 | 0 | 3/4 | 0 | 1/4 |
| 4 | 0 | 0 | 0 | 1 | 0 |
Nos exemplos da ruína do jogador e de Ehrenfest, partimos de uma descrição verbal e extraímos as probabilidades de transição. Reciprocamente, qualquer família \(p(i,j)\) que satisfaça
\(p(i,j)\geq 0\) para todos os estados \(i,j\);
\(\sum _jp(i,j)=1\) para cada estado \(i\),
define uma matriz de transição. Para construir a cadeia, estando em \(i\), sorteamos o próximo estado \(j\) segundo a distribuição dada pela linha \(i\) da matriz.
Outra maneira de descrever uma cadeia é por uma recorrência aleatória:
em que \(Z_1,Z_2,\ldots \) são novas entradas aleatórias, independentes e com a mesma distribuição, também independentes de \(X_0\). O próximo sorteio independe do passado; portanto, a lei de \(X_{n+1}\) depende apenas de \(X_n\), e a cadeia é homogênea.
Seja \(X_n\) o número de máquinas aguardando reparo no início do dia \(n\). A oficina conserta uma máquina por dia, quando há alguma esperando. Ao final do dia, chegam \(Z_{n+1}\) novas máquinas com defeito. A regra é
Suponha que as chegadas de dias diferentes sejam independentes, com
Se \(X_n=2\), a oficina conserta uma máquina e resta uma antes das novas chegadas. Logo,
Já se \(X_n=0\) ou \(X_n=1\), não sobra nenhuma máquina depois do reparo, e \(X_{n+1}=Z_{n+1}\). Assim, as linhas de transição correspondentes a \(0\) e \(1\) são iguais.
A recorrência determina o próximo estado a partir do número atual de máquinas e das novas chegadas, sem exigir a escrita de uma matriz infinita.
Um dígito binário atravessa sucessivas etapas de transmissão. Em cada etapa, um \(0\) é trocado por \(1\) com probabilidade \(a\), enquanto um \(1\) é trocado por \(0\) com probabilidade \(b\), independentemente do que ocorreu antes. Se \(X_n\in \{ 0,1\} \) é o dígito que entra na etapa \(n\), então \((X_n)\) é uma cadeia de Markov com matriz
Interessa calcular \(\mathbb {P}(X_n=X_0)\) e examinar se a informação sobre o bit original desaparece quando \(n\) cresce. O canal simétrico corresponde ao caso \(a=b=1-p\), em que cada etapa preserva o dígito com probabilidade \(p\).
Sejam \(Y_0,Y_1,\ldots \) Bernoulli independentes, com parâmetro \(1/2\), e ponha \(Z_n=Y_{n-1}+Y_n\) para \(n\geq 1\). Conhecer \(Z_2=1\) deixa duas possibilidades equiprováveis para \((Y_1,Y_2)\), de modo que
Mas, se sabemos também que \(Z_1=0\), então \(Y_1=0\) e \(Y_2=1\); portanto
Os eventos condicionados têm probabilidade positiva. Assim, \((Z_n)\) não é uma cadeia de Markov: a soma esconde informação que o passado ajuda a reconstruir. O processo dos pares \((Y_{n-1},Y_n)\) tem a propriedade de Markov, pois o próximo par é \((Y_n,Y_{n+1})\) e a nova variável \(Y_{n+1}\) é independente das anteriores.
Escrevendo \(W_n=(Y_{n-1},Y_n)\), enumeramos os estados na ordem \(00,01,10,11\). Como \(W_{n+1}=(Y_n,Y_{n+1})\), apenas o segundo algarismo do estado atual e o novo sorteio importam. A matriz de transição é
Por exemplo, para passar de \(00\) a \(11\) em dois passos, o único caminho possível é \(00\to 01\to 11\); logo,
A soma \(Z_n\) pode ser recuperada de \(W_n\), mas não o contrário: \(Z_n=1\) não distingue \(01\) de \(10\), que levam a distribuições diferentes para o próximo valor da soma. A distinção entre esses estados conserva a informação necessária ao próximo passo.
2.2 Probabilidades de transição em vários passos
A matriz \(P\) descreve um passo. Para descrever \(m\) passos, precisamos somar sobre todos os estados intermediários possíveis. A multiplicação de matrizes faz exatamente essa contabilidade.
Distribuição inicial e lei da cadeia A matriz de transição descreve como a cadeia se move, mas ainda é preciso dizer onde ela começa. A distribuição inicial é a distribuição \(\mu \) de \(X_0\):
Escrevemos \(\mathbb {P}_\mu \) para a lei da trajetória quando \(X_0\) tem distribuição \(\mu \) e \(E_\mu \) para a esperança correspondente.
Quando o estado inicial é fixo, usamos uma notação mais curta: \(\mathbb {P}_x\) é a lei da cadeia que começa em \(x\), isto é, \(\mathbb {P}_x(X_0=x)=1\), e \(E_x\) é a esperança sob essa lei. Assim, para qualquer evento \(A\) determinado pela trajetória,
A fórmula apenas separa os casos possíveis para o estado inicial. Quando \(\mu (x)\gt 0\), \(\mathbb {P}_x\) também pode ser visto como a lei condicional \(\mathbb {P}_\mu (\, \cdot \mid X_0=x)\).
Pela Proposição 2.3 e pela propriedade de Markov,
sempre que o condicionamento estiver definido.
Voltemos ao sapo do Exemplo 2.1. Se ele começa em \(A\), para estar novamente em \(A\) depois de dois saltos há exatamente duas possibilidades:
As probabilidades desses caminhos são, respectivamente,
Portanto,
Para o sapo partir de \(A\) e chegar a \(B\) depois de três saltos, há três caminhos possíveis:
Desta vez os caminhos não têm todos a mesma probabilidade:
Logo,
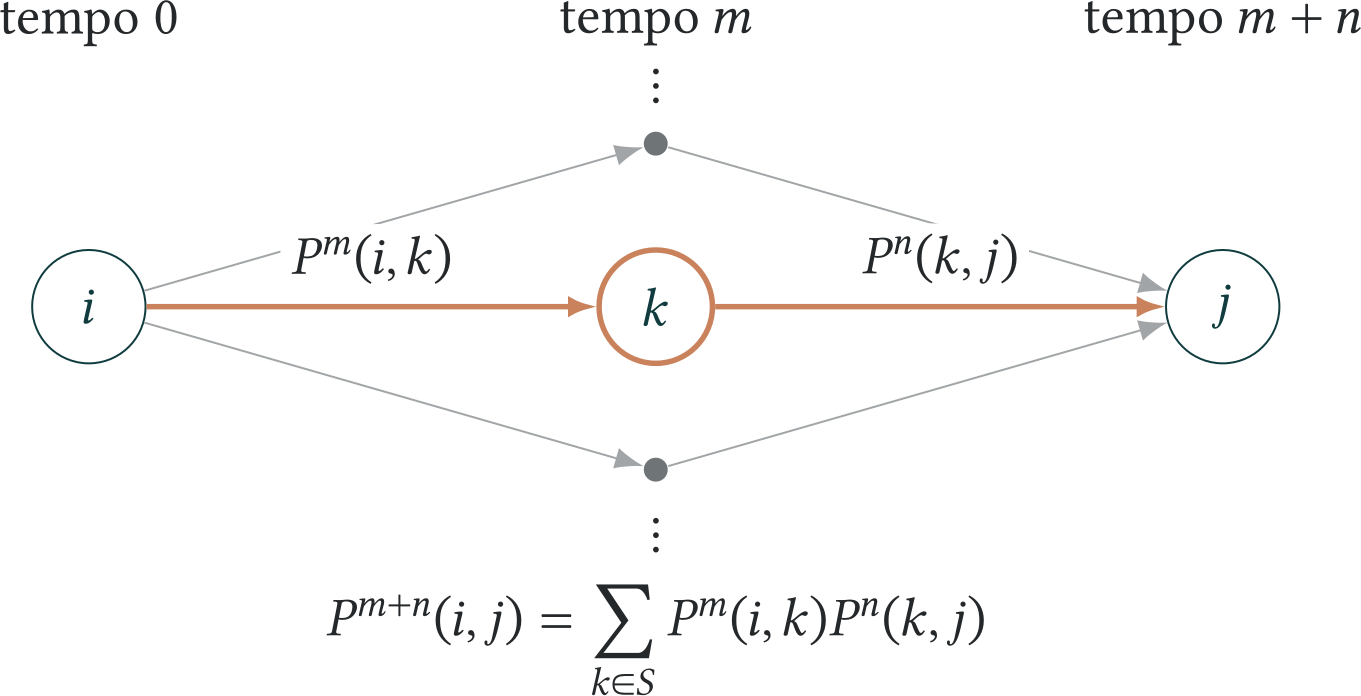
Equação de Chapman–Kolmogorov Para \(m,n\geq 0\),
Em notação matricial, \(P^{m+n}=P^mP^n\). Em particular, as probabilidades em \(m\) passos são as entradas da potência usual \(P^m\).
Condicionamos pelo estado ocupado após os primeiros \(m\) passos. Os eventos \(\{ X_m=k\} \), para \(k\in S\), são disjuntos e cobrem todas as possibilidades, de modo que
O primeiro fator é, por definição, \(P^m(i,k)\). Para o segundo, o Corolário 2.2 permite esquecer os estados anteriores a \(m\) depois que conhecemos \(X_m=k\); pela homogeneidade, podemos ainda deslocar a origem do tempo. Portanto,
Substituindo esses dois fatores obtemos
Se \(\mathbb {P}_i(X_m=k)=0\), o termo correspondente já é zero, por isso esses estados podem ser incluídos sem restrição na soma final.
Uma loja acompanha seu estoque no fim do dia, entre \(0\) e \(3\) unidades. Se terminou o dia com \(0\) ou \(1\), repõe o estoque até \(3\) antes de vender novamente; se terminou com \(2\) ou \(3\), não encomenda nada. A demanda diária, independente de um dia para outro, é \(0\), \(1\) ou \(2\) unidades, com probabilidades \(1/4\), \(1/2\) e \(1/4\), respectivamente.
Começando com \(X_0=2\), qual é a chance de o estoque ser exatamente zero no fim do segundo dia? Para terminar com zero, a loja precisa começar esse segundo dia com \(2\) unidades e vender as duas. Se a primeira demanda foi \(1\) ou \(2\), haverá reposição a \(3\) e não será possível terminar em zero, pois a demanda máxima é \(2\). Assim, há somente o caminho \(2\to 2\to 0\), que exige demanda zero no primeiro dia e demanda dois no segundo:
Mais adiante, no Exemplo 3.5, estudaremos a mesma política para calcular o estoque e o lucro médios no longo prazo.
Uma pessoa circula por duas salas, representadas pelos estados \(1\) e \(2\). A cada passo, ela permanece na mesma sala com probabilidade \(1/2\), passa para a outra com probabilidade \(1/4\) ou sai do edifício com probabilidade \(1/4\). A saída é definitiva e corresponde ao estado absorvente \(3\). A matriz de transição é
Por Chapman–Kolmogorov, para estar na sala \(2\) após dois passos, começando na sala \(1\), a pessoa pode permanecer primeiro na sala \(1\) ou passar imediatamente à sala \(2\). Assim,
A diagonalização permite calcular \(P^n\) para um número qualquer de passos. Os vetores
são autovetores de \(P\), com autovalores \(3/4\), \(1/4\) e \(1\), respectivamente. Tomando-os como colunas, obtemos
Portanto, \(P=S\, \operatorname {diag}(3/4,1/4,1)\, S^{-1}\) e
onde \(a_n=(3/4)^n\) e \(b_n=(1/4)^n\).
Em cada passo anterior à saída, a chance de continuar no edifício é \(3/4\). Logo,
esta é a probabilidade de já ter saído até o instante \(n\). Além disso,
A diferença entre as probabilidades de ocupar as duas salas diminui rapidamente: a cadeia perde a preferência pela sala em que começou. Como \(a_n,b_n\to 0\), a probabilidade de estar no estado \(3\) tende a \(1\). Voltaremos a esta cadeia para contar quantas vezes a pessoa visita uma das salas antes de sair.
Se a distribuição inicial é o vetor-linha \(\mu _0\), então a distribuição de \(X_m\) é \(\mu _0P^m\). Essa identidade será o ponto de partida para o estudo do comportamento de longo prazo.
2.2.1 Estimação de transições e retenção de usuários
Em aplicações, a matriz de transição costuma ser estimada a partir de observações. Suponha que registremos, ao fim de cada semana, o número de dias em que cada usuário acessou um serviço. Fixamos antes da análise os estados \(A=\) ativo (quatro ou mais dias), \(P=\) pouco ativo (um a três dias), \(I=\) inativo (nenhum acesso) e \(B=\) abandono (conta encerrada). Aqui o encerramento é definitivo; inatividade, por si só, permite retorno.
Considere a seguinte tabela didática de contagens, obtida a partir de pares de semanas consecutivas de vários usuários acompanhados no mesmo período:
Os estados \(A\), \(P\), \(I\) e \(B\) representam, respectivamente, usuários ativos, pouco ativos, inativos e que abandonaram o serviço. A entrada \(N_{ij}\) conta quantas vezes foi observada uma transição do estado \(i\) para o estado \(j\):
Um mesmo usuário pode contribuir com vários pares de semanas consecutivas. A última observação de um usuário não é ligada à primeira de outro, e uma semana sem observação não deve ser registrada como inatividade.
A tabela permite estimar diretamente as probabilidades de transição. Se
é o número total de transições observadas a partir do estado \(i\), tomamos
Essa estimativa é a frequência das transições de \(i\) para \(j\) entre todas as transições iniciadas em \(i\).
Por exemplo, das \(100\) transições observadas a partir de \(A\), \(70\) terminaram novamente em \(A\), \(20\) em \(P\) e \(10\) em \(I\). Assim,
Procedendo da mesma forma nas demais linhas, obtemos
As três primeiras linhas foram estimadas a partir das observações. A última é uma hipótese do modelo: depois do abandono não são coletadas novas transições, e consideramos \(B\) um estado absorvente.
Suponha agora que um usuário esteja ativo no instante inicial. Sua distribuição inicial é \((1,0,0,0)\) e, portanto,
A última coordenada da primeira expressão pode também ser obtida diretamente. Para que um usuário inicialmente ativo tenha abandonado o serviço em até dois passos, ele deve seguir um dos caminhos
Logo,
Como \(B\) é absorvente, a última coordenada de \((1,0,0,0)\widehat P^3\) representa a probabilidade estimada de abandono até o terceiro passo:
O abandono de usuários ou clientes é frequentemente chamado de churn. A fração ou probabilidade de abandono em um período é a taxa de churn, usada em serviços por assinatura e plataformas digitais para acompanhar a permanência dos usuários. O modelo relaciona a atividade observada nas semanas anteriores à probabilidade de abandono nas semanas seguintes.
Há mais de uma maneira de definir retenção. Se consideramos retido todo usuário que ainda não atingiu \(B\), então a retenção até o terceiro passo é
Se quisermos medir apenas a probabilidade de o usuário estar ativo ou pouco ativo exatamente no terceiro passo, obtemos
As duas quantidades respondem a perguntas diferentes: a primeira mede a permanência no serviço, enquanto a segunda mede a presença de alguma atividade no período considerado.
Se uma linha não contém transições observadas, sua distribuição não é identificada pelos dados: não podemos dividir por zero nem concluir que o estado seja absorvente. Uma suavização simples, para \(d_i\) destinos admissíveis, substitui as proporções por
nesses destinos, conservando os zeros estruturais. Ela evita previsões nulas baseadas em poucas observações, mas acrescenta uma escolha ao modelo; já não é o estimador de máxima verossimilhança sem restrições adicionais.
A hipótese de Markov pode ser examinada comparando a atividade na semana seguinte entre usuários com o mesmo estado atual, mas estados anteriores distintos. Diferenças persistentes sugerem que o estado resume mal o histórico. Para examinar a homogeneidade, podem-se estimar matrizes em períodos separados e comparar suas previsões em semanas posteriores, inclusive a fração de contas encerradas. Uma campanha, uma mudança no produto ou diferenças entre coortes podem alterar as probabilidades de transição. Nesses casos, uma única matriz fixa deixa de representar bem a evolução dos usuários. Mesmo quando o ajuste é razoável, as probabilidades obtidas são previsões do modelo: não expressam a incerteza da estimação nem demonstram o efeito causal de uma intervenção voltada à retenção.
2.3 Classificação dos estados
Para compreender as trajetórias, surgem duas perguntas diferentes: quando a cadeia visita \(y\) pela primeira vez e quando volta a \(y\) depois do instante inicial. Se começamos em \(y\), a entrada já ocorreu, mas o retorno ainda está por acontecer.
Quando a cadeia começa em \(y\), \(T_y^+\) é o primeiro retorno: o instante inicial não conta. Quando ela começa em \(x\ne y\), temos \(T_y^+=H_y\). Assim, \(\rho _{xy}\) é a probabilidade de atingir \(y\) em tempo positivo e \(\rho _{yy}\) é a probabilidade de retornar a \(y\).
Retornos, entradas e saídas fornecem exemplos básicos de tempos de parada.
A regra de parada depende apenas da informação já observada.
A propriedade forte de Markov diz que a cadeia pode ser reiniciada em um tempo de parada: dali em diante, importa o estado em que ela parou, e não o caminho usado para chegar até ele.
Propriedade forte de Markov Se \(T\) é um tempo de parada, então, no evento \(\{ T\lt \infty \} \) e condicionalmente ao estado \(X_T=y\), a trajetória futura \((X_{T+k})_{k\geq 0}\) tem a lei da cadeia iniciada em \(y\) e é independente do caminho observado até \(T\). Mais precisamente, se \(A\) é um evento determinado pelo caminho observado até \(T\), então, para \(r\geq 1\),
sempre que o condicionamento estiver definido.
Em particular, para \(m\geq 0\),
sempre que o condicionamento estiver definido.
A hipótese de parada é essencial: uma escolha baseada em acontecimentos futuros poderia favorecer certas trajetórias e alterar a lei do processo reiniciado.
Fixe \(r\geq 1\), estados \(z_1,\ldots ,z_r\) e um evento \(A\) determinado pelo caminho observado até \(T\), no sentido de que, para cada \(n\), o evento \(A\cap \{ T=n\} \) é determinado por \(X_0,\ldots ,X_n\). O argumento tem três passos.
1. Fixar o valor da parada. No evento \(\{ T=n\} \), a regra que determina a parada já pode ser decidida com a informação disponível até o instante \(n\). Assim,
é um evento determinado por \(X_0,\ldots ,X_n\). O instante aleatório foi, portanto, reduzido a um instante determinístico.
2. Aplicar a propriedade de Markov em \(n\). Como no Corolário 2.2, podemos somar sobre as histórias completas compatíveis com \(A\cap \{ T=n,X_n=y\} \). Em cada uma, a probabilidade do bloco futuro depende apenas do estado \(X_n=y\). Logo,
O segundo fator é exatamente a probabilidade de a cadeia iniciada em \(y\) seguir o caminho \(y,z_1,\ldots ,z_r\); em particular, ele não depende de \(A\) nem de \(n\).
3. Somar sobre os valores possíveis de \(T\). Somando a identidade anterior em \(n\) e usando que os eventos \(\{ T=n\} \) são disjuntos, obtemos
Quando a probabilidade condicionante é positiva, a divisão mostra que a lei do futuro, dado \(X_T=y\), não depende do caminho observado até \(T\). Como as probabilidades de blocos finitos determinam a lei da trajetória futura, obtemos a propriedade forte de Markov.
Se \(\rho _{yy}=1\), cada retorno \(T_y^{(k)}\) é finito com probabilidade um; como isso vale para todo \(k\), a cadeia retorna a \(y\) infinitas vezes quase certamente. Se \(\rho _{yy}\lt 1\), a probabilidade de ocorrerem pelo menos \(k\) retornos é \(\rho _{yy}^k\), que tende a zero. Nesse caso, o número de retornos é finito quase certamente.
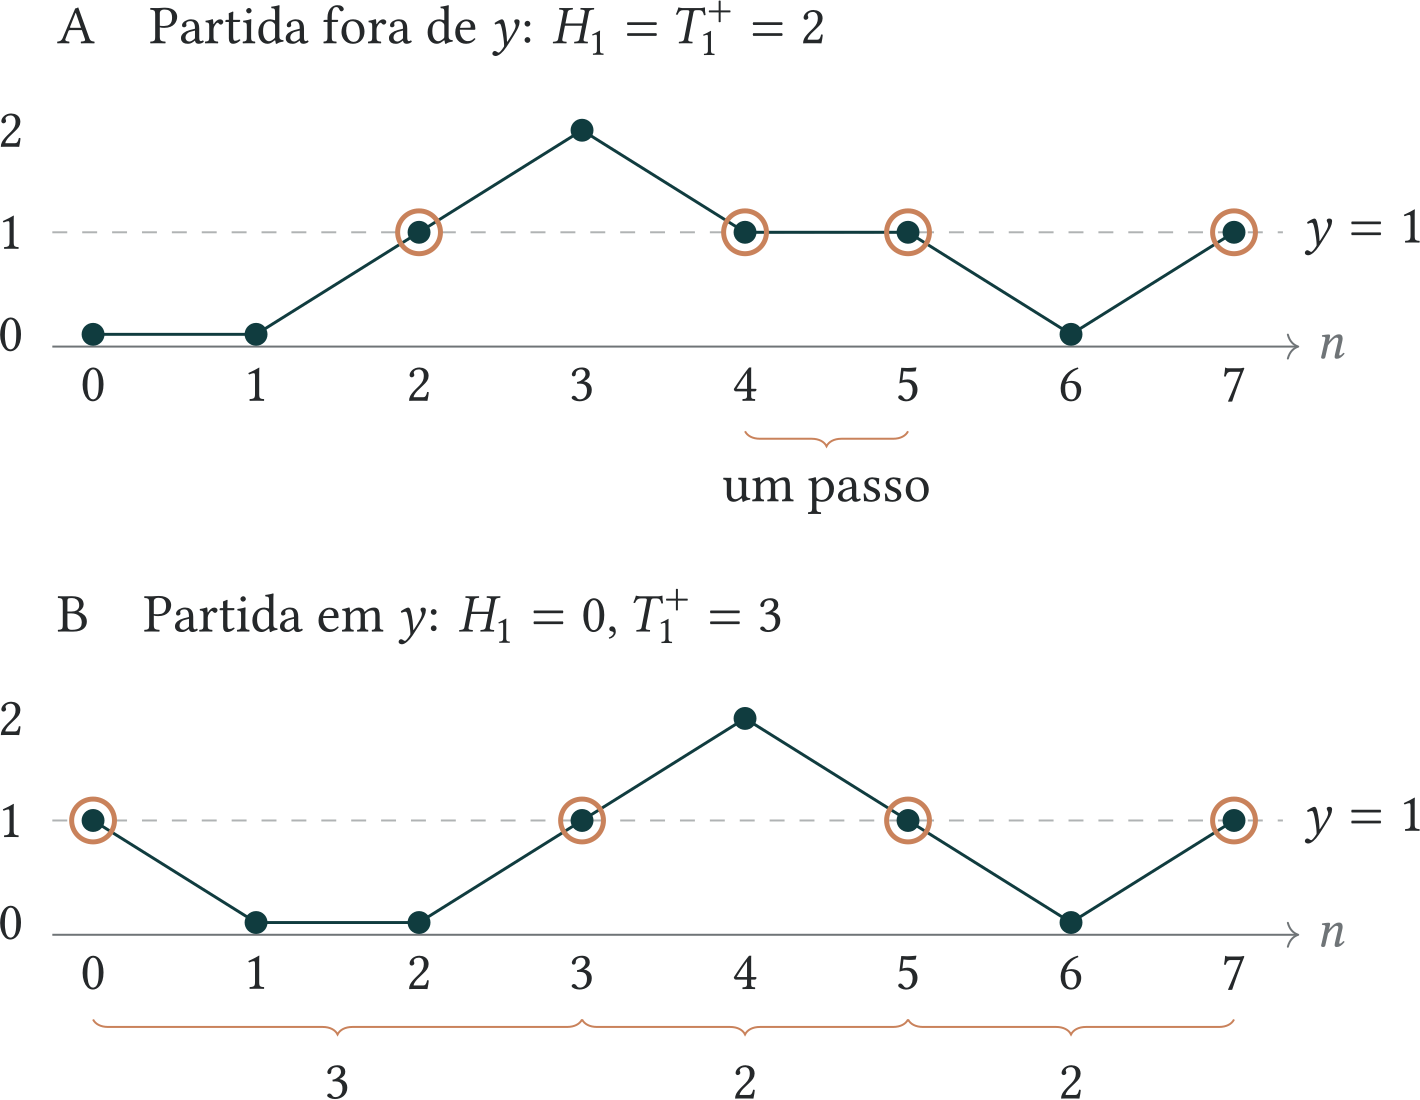
Estados recorrentes e transientes Um estado \(y\) é recorrente se \(\rho _{yy}=1\); nesse caso, a cadeia iniciada em \(y\) retorna a \(y\) infinitas vezes com probabilidade \(1\). O estado é transiente se \(\rho _{yy}\lt 1\); nesse caso, o número de visitas a \(y\) é finito com probabilidade \(1\).
Considere a cadeia em \(\{ 1,2,3\} \) que, a cada passo, salta para cada um dos outros dois vértices com probabilidade \(1/2\):
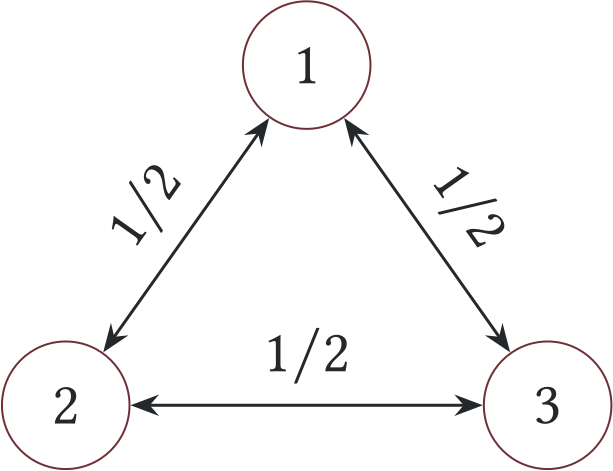
Partindo de \(1\), depois do primeiro passo a cadeia está em \(2\) ou \(3\). Enquanto não retorna a \(1\), em cada passo há probabilidade \(1/2\) de continuar no outro vértice sem visitar \(1\). Portanto, para \(n\geq 1\),
Logo \(\mathbb P_1(T_1^+\lt \infty )=1\), e o estado \(1\) é recorrente. Por simetria, os três estados são recorrentes.
Assim, recorrência não significa “permanecer perto” de \(y\): ela afirma apenas que, partindo de \(y\), a cadeia retorna a \(y\) com probabilidade um. A definição, por si só, não impõe que esse retorno seja rápido. Transiência significa que, partindo de \(y\), há probabilidade positiva de nunca mais retornar.
A diferença aparece já na ruína do jogador: os estados absorventes são recorrentes, enquanto os estados internos são transientes.
No jogo do Exemplo 2.2 com \(N=5\), os estados 0 e 5 são absorventes e, portanto, recorrentes. Os estados internos são transientes. De fato, a partir de cada um deles existe um caminho de probabilidade positiva até uma barreira absorvente sem retornar ao ponto de partida:
Por exemplo,
O mesmo argumento vale para 1, 3 e 4. Assim, cada estado interno tem probabilidade positiva de nunca retornar.
A estrutura do grafo fornece critérios para identificar estados transientes e recorrentes.
Duas noções do grafo de transições serão usadas repetidamente. A primeira é orientada: pergunta se existe algum caminho possível de \(x\) até \(y\). A segunda exige caminhos nos dois sentidos.
Acessibilidade e comunicação Dizemos que \(y\) é acessível a partir de \(x\), e escrevemos \(x\to y\), se
Equivalentemente, \(x\to y\) se e somente se \(P^m(x,y)\gt 0\) para algum \(m\geq 0\): atingir \(y\) em tempo finito com probabilidade positiva equivale à existência de um caminho finito de \(x\) até \(y\) cujas transições tenham probabilidade positiva. Usaremos as duas formulações indistintamente.
Dizemos que \(x\) e \(y\) se comunicam, e escrevemos \(x\leftrightarrow y\), se \(x\to y\) e \(y\to x\). Os conjuntos de estados que se comunicam entre si são chamados de classes de comunicação da cadeia.
Transitividade da acessibilidade Se \(x\to y\) e \(y\to z\), então \(x\to z\).
Existem \(m,n\) tais que \(P^{m}(x,y)\gt 0\) e \(P^{n}(y,z)\gt 0\). Por Chapman–Kolmogorov,
Como \(H_x=0\) sob \(\mathbb P_x\), temos \(x\to x\) para todo estado \(x\). A comunicação é simétrica por definição e, pelo lema, também é transitiva. Portanto, \(\leftrightarrow \) é uma relação de equivalência: as classes de comunicação formam uma partição do espaço de estados.
Um caminho sem retorno Se \(\rho _{xy}\gt 0\) e \(\rho _{yx}\lt 1\), então \(x\) é transiente.
Se \(x=y\), a hipótese \(\rho _{xx}\lt 1\) já afirma que \(x\) é transiente. Suponha, portanto, \(x\ne y\). Seja \(K\geq 1\) o menor comprimento de um caminho de probabilidade positiva de \(x\) até \(y\). Escreva esse caminho como
Pela minimalidade de \(K\), nenhum dos estados \(x_1,\ldots ,x_{K-1}\) é igual a \(x\): caso contrário, poderíamos eliminar o trecho entre duas visitas a \(x\) e obter um caminho mais curto até \(y\). Depois de chegar a \(y\), há probabilidade \(1-\rho _{yx}\gt 0\) de nunca atingir \(x\). Logo,
e \(x\) é transiente.
Uma consequência imediata é a seguinte.
Retorno a partir de estados alcançáveis Se \(x\) é recorrente e \(\rho _{xy}\gt 0\), então \(\rho _{yx}=1\).
Se \(\rho _{y x}\lt 1\), então o Teorema 2.7 implicaria que \(x\) é transiente, uma contradição.
Um conjunto fechado é uma região da qual a cadeia não sai. A irredutibilidade significa que cada estado pode ser alcançado a partir de qualquer outro. Na definição de um subconjunto \(B\), os caminhos são considerados na cadeia original; quando \(B\) também é fechado, esses caminhos permanecem em \(B\). Em uma cadeia finita, veremos que as classes fechadas são exatamente as regiões recorrentes da cadeia.
Considere a cadeia em \(\{ 0,1,2,3\} \), com matriz
O estado \(0\) é absorvente; os estados \(2\) e \(3\) se comunicam e formam uma classe fechada. Já o estado \(1\) é transiente: depois de chegar a \(0\), \(2\) ou \(3\), a cadeia não volta a \(1\).
Podemos calcular a probabilidade \(h\) de alcançar \(0\) antes de entrar em \(\{ 2,3\} \), partindo de \(1\). No primeiro passo, a cadeia vai a \(0\) com probabilidade \(1/4\), fica em \(1\) com probabilidade \(1/4\) ou entra em \(2\) com probabilidade \(1/2\). Logo,
A chance de entrar primeiro na classe \(\{ 2,3\} \) é \(2/3\). A decomposição em classes reduziu o cálculo a uma equação de primeiro passo.
As classes fechadas podem ser reconhecidas diretamente no grafo de transições, como na cadeia a seguir.
Considere a matriz de transição:
Desenhe uma seta de \(i\) para \(j\) quando \(p(i,j)\gt 0\) e \(i\ne j\). Os laços correspondentes a \(p(i,i)\gt 0\) foram omitidos: eles não alteram quais estados são alcançáveis, embora sejam relevantes para a periodicidade.
A Figura 2.14 destaca as duas classes fechadas.
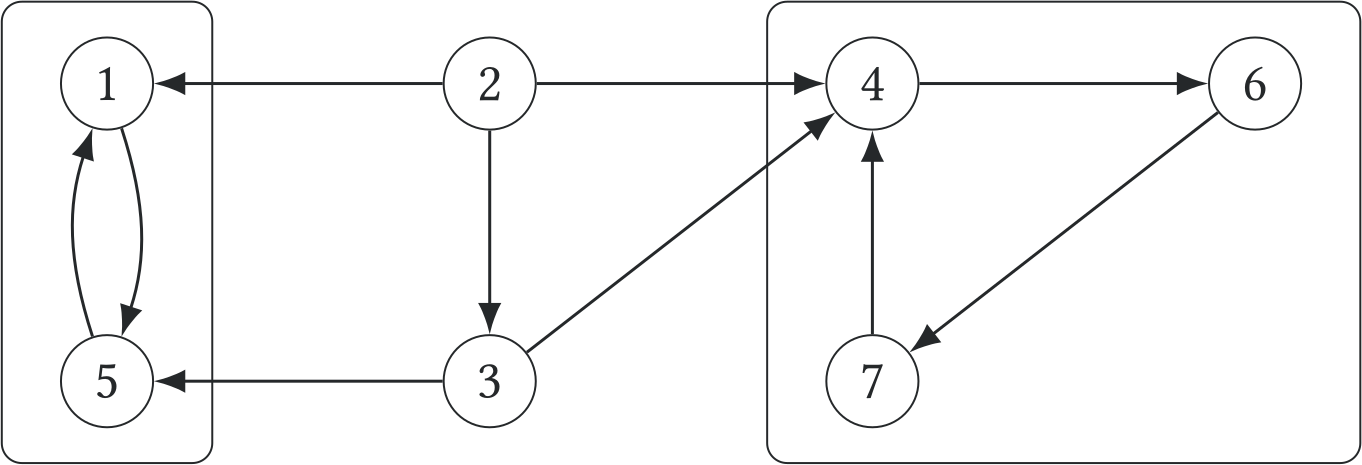
O estado 2 alcança 1, mas 1 não alcança 2; pelo Teorema 2.7, o estado 2 é transiente. Do mesmo modo, 3 alcança 4, mas 4 não alcança 3, e portanto 3 é transiente.
As classes \(\{ 1,5\} \) e \(\{ 4,6,7\} \) são fechadas e irredutíveis. Há conjuntos fechados maiores — por exemplo, a união \(\{ 1,4,5,6,7\} \) e o espaço inteiro —, mas são as classes fechadas que determinam os estados recorrentes. A recorrência dessas classes será demonstrada por meio de tentativas repetidas.
Antes de aplicar a estimativa de tentativas repetidas, recordemos a continuidade das probabilidades e uma regra de somação não negativa. Essas ferramentas também serão usadas na contagem de visitas e em espaços enumeráveis.
Uma série de números não negativos é o supremo de suas somas parciais; seu valor pode ser \(+\infty \). Para uma família \(a_{ij}\geq 0\), podemos somar por linhas ou por colunas:
Para verificar a afirmação sobre eventos crescentes, escreva \(D_1=A_1\) e \(D_m=A_m\setminus A_{m-1}\) para \(m\geq 2\). Esses eventos são disjuntos, e a aditividade enumerável dá
Aplicando essa identidade aos complementares, obtemos a continuidade para eventos decrescentes. Para um tempo de parada \(T\), os eventos \(\{ T\leq n\} \) crescem para \(\{ T\lt \infty \} \), enquanto \(\{ T\gt n\} \) decrescem para \(\{ T=\infty \} \). As duas identidades finais seguem das duas formas de continuidade.
Fixe \(x\in D\) e, para \(n\geq 0\), escreva
O evento \(A_n\) significa que a cadeia chegou ao instante \(nk\) sem visitar \(y\) em tempo positivo. Como \(D\) é fechado e a cadeia começou em \(D\), no evento \(A_n\) temos necessariamente
Reiniciamos a análise no instante \(nk\). Fixe \(z\in D\) e suponha que o condicionamento abaixo esteja definido. O instante determinístico \(nk\) é um tempo de parada, e \(A_n\) é determinado pelo caminho observado até esse instante. Pela propriedade forte de Markov,
Sabendo que a cadeia sobreviveu até \(nk\) e que está em \(z\), a probabilidade de evitar \(y\) durante os próximos \(k\) passos é a mesma que para uma nova cadeia iniciada em \(z\). O caminho percorrido antes de \(nk\) não entra mais no cálculo.
Pela hipótese do lema,
Tomando complementares,
Portanto, qualquer que seja o estado ocupado no instante \(nk\), a probabilidade de sobreviver ao próximo bloco de \(k\) passos é no máximo \(1-\alpha \).
Se \(\mathbb P_x(A_n)=0\), então também \(\mathbb P_x(A_{n+1})=0\) e a desigualdade que queremos é imediata. Suponha, pois, \(\mathbb P_x(A_n)\gt 0\). Condicionando pelos possíveis valores de \(X_{nk}\) no evento \(A_n\), obtemos
Assim, como \(A_{n+1}\subseteq A_n\),
Iterando essa desigualdade e usando \(\mathbb P_x(T_y^+\gt 0)\leq 1\), concluímos que
Por fim, os eventos \(\{ T_y^+\gt nk\} \) decrescem para \(\{ T_y^+=\infty \} \). Pela continuidade das probabilidades (pela Proposição 2.9),
Logo \(\mathbb P_x(T_y^+\lt \infty )=1\).
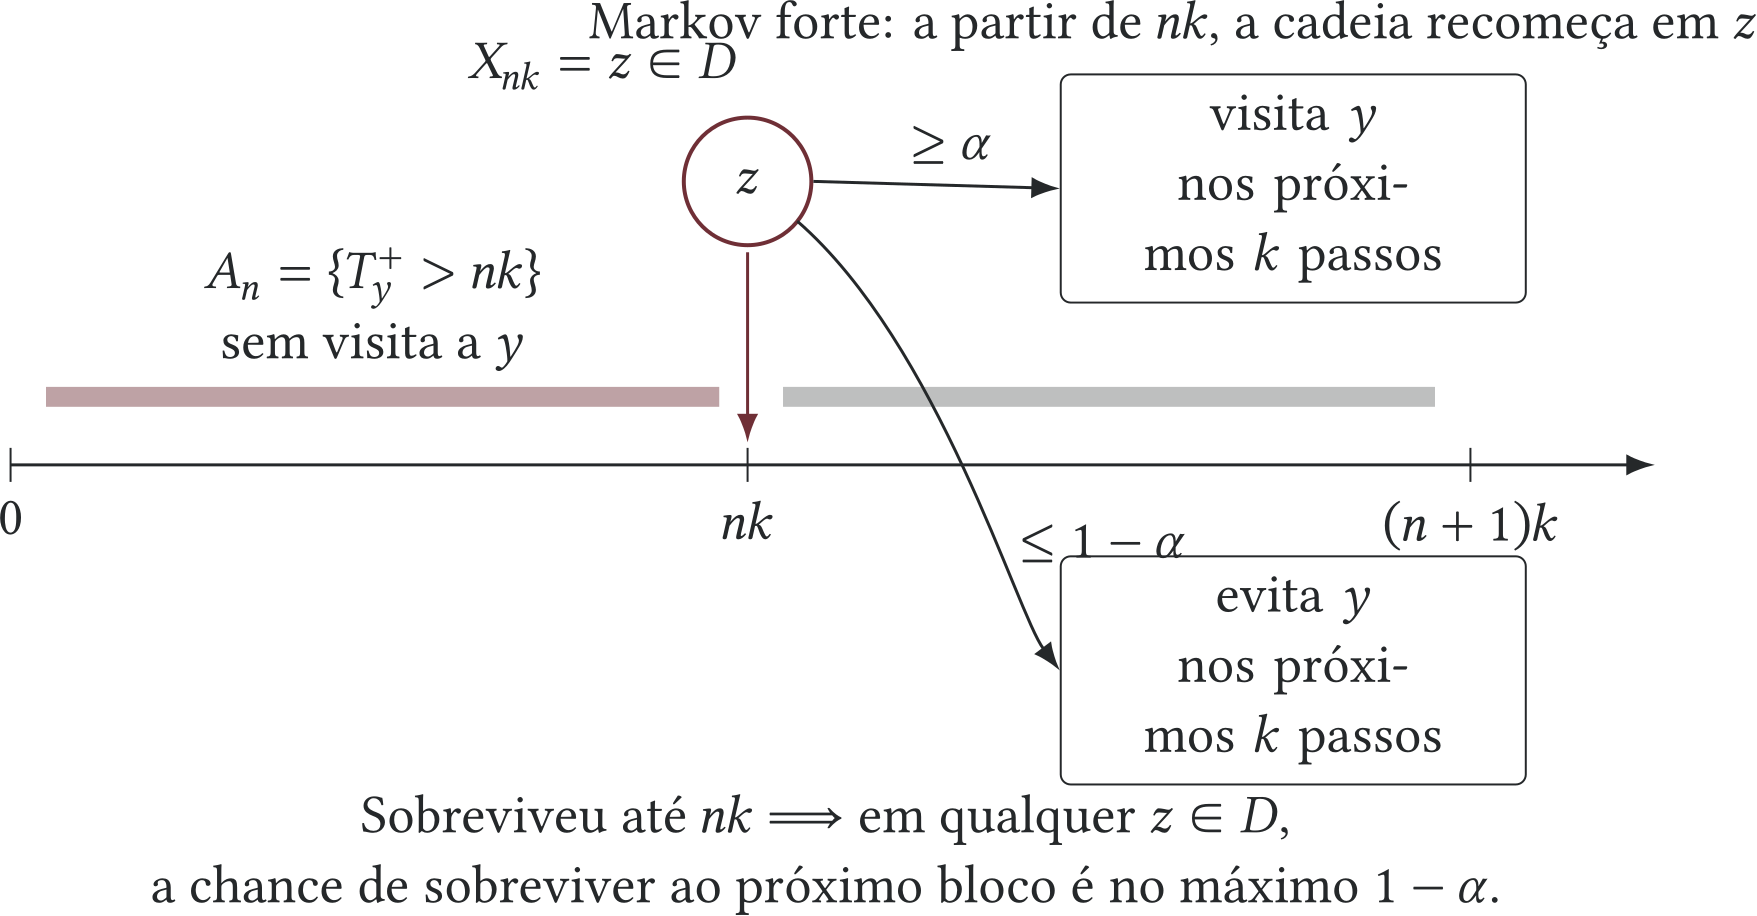
Dentro de uma classe finita sem saída, há sempre uma nova oportunidade de voltar a qualquer estado fixado. A finitude permite tornar essa oportunidade uniforme, independentemente do ponto de partida.
Fixe \(y\in C\). Para cada \(x\in C\), escolha um caminho de probabilidade positiva que, partindo de \(x\), visite \(y\) em tempo positivo. Quando \(x\ne y\), isso é possível pela irredutibilidade. Para \(x=y\), precisamos de um caminho de retorno: se \(C=\{ y\} \), o fato de \(C\) ser fechado implica \(p(y,y)=1\); se \(C\) tem mais de um estado, podemos ir de \(y\) a outro estado da classe e depois voltar a \(y\).
Denote por \(\ell _x\geq 1\) o comprimento do caminho escolhido e por \(q_x\gt 0\) a probabilidade de segui-lo. Como \(C\) é finito,
Consequentemente,
Como \(C\) é fechado, o Lema 2.10 se aplica e dá
Logo \(y\) é recorrente. Como \(y\) foi arbitrário, todos os estados de \(C\) são recorrentes.
No exemplo de sete estados, isso mostra imediatamente que todos os estados das classes \(\{ 1,5\} \) e \(\{ 4,6,7\} \) são recorrentes.
Em uma cadeia finita, as classes fechadas são precisamente as classes recorrentes. Isso permite decompor o espaço de estados.
Contraia cada classe de comunicação a um único vértice e mantenha uma seta entre duas classes distintas quando existe uma transição de probabilidade positiva da primeira para a segunda. O grafo resultante é finito e não possui circuitos dirigidos: se várias classes formassem um circuito, seus estados se comunicariam e pertenceriam à mesma classe.
As classes sem seta de saída são exatamente as classes fechadas. Como o grafo é finito e não possui circuitos dirigidos, seguindo sucessivamente as setas a partir de qualquer classe chegamos, após um número finito de passos, a uma classe da qual não sai nenhuma seta. Portanto, existe pelo menos uma classe fechada. Pelo Teorema 2.11, todos os estados dessas classes são recorrentes.
Considere agora uma classe \(C\) que não é fechada. Seguindo setas no grafo das classes, chegamos depois de um número finito de passos a alguma classe fechada \(R\). Assim, para \(x\in C\) e algum \(y\in R\), temos \(x\to y\). Por outro lado, \(y\not\to x\): caso contrário, \(x\) e \(y\) se comunicariam e pertenceriam à mesma classe. Pelo Teorema 2.7, \(x\) é transiente. Como \(x\) era arbitrário em \(C\), toda classe não fechada é formada por estados transientes.
As classes de comunicação particionam \(S\). Reunindo as classes não fechadas em \(\mathcal T\) e enumerando as classes fechadas como \(R_1,\ldots ,R_k\), obtemos a decomposição afirmada.
2.4 Contagem de visitas e critério de recorrência
A probabilidade de retorno informa se a cadeia volta a um estado; agora queremos contar quantas vezes ela volta. A fórmula da cauda liga essa contagem à esperança.
Se \(\mathbb {P}(Z=+\infty )\gt 0\), a esperança é infinita e cada termo da primeira série é pelo menos essa probabilidade. A identidade vale nesse caso.
Suponha agora \(\mathbb {P}(Z=+\infty )=0\) e escreva \(p_j=\mathbb {P}(Z=j)\). Pela definição de esperança de uma variável discreta, \(E Z=\sum _{j\geq 1}j p_j\). Para cada \(M\), uma soma finita dá
Tomando o supremo em \(M\), obtemos uma das desigualdades. Na direção oposta, para cada \(K\), particionamos os resultados em \(Z=1,\ldots ,K-1\) e \(Z\geq K\):
Tomar o supremo em \(K\) fornece a desigualdade restante. A segunda série do enunciado é a primeira com o índice deslocado, pois \(Z\) assume valores inteiros.
A versão truncada é a identidade finita
Cada nível alcançado por \(Z\) contribui uma unidade para a esperança truncada.
Retomemos agora os tempos de retorno sucessivos definidos em (2.3). Pela propriedade forte de Markov, para \(x,y\in S\) e \(k\geq 1\),
Seja \(N(y)\) o número de visitas a \(y\) nos instantes \(n\geq 1\). A identidade acima permite calcular \(E_xN(y)\).
Número esperado de visitas Vale
Aplicaremos a fórmula da cauda do Lema 2.13 à contagem \(N(y)\), que pode ser infinita. Para cada \(k\geq 1\),
Usando (2.5), obtemos
Se \(\rho _{xy}=0\), cada parcela é zero. Se \(\rho _{xy}\gt 0\) e \(\rho _{yy}\lt 1\), então
pela soma da série geométrica. Se \(\rho _{xy}\gt 0\) e \(\rho _{yy}=1\), todas as parcelas valem \(\rho _{xy}\gt 0\) e, portanto, a soma é infinita.
Visitas e probabilidades de transição O número esperado de visitas também satisfaz
Conte primeiro as visitas até o instante \(m\):
pela linearidade da esperança de uma soma finita. Para cada \(k\geq 1\), os eventos \(\{ N_m(y)\geq k\} \) crescem para \(\{ N(y)\geq k\} \). Pela continuidade das probabilidades, \(\mathbb P_x(N(y)\geq k)=\sup _m\mathbb P_x(N_m(y)\geq k)\). Essas probabilidades são não negativas e crescem com \(m\); por isso, os supremos que definem as somas podem ser tomados em qualquer ordem:
Usamos apenas a fórmula da cauda e o princípio de que uma soma de termos não negativos é o supremo de suas somas finitas. O argumento também vale quando a esperança é infinita.
Critério de recorrência Um estado \(y\) é recorrente se, e somente se,
Se \(x=y\), nada há a provar. Caso contrário, o Lema 2.8 garante \(y\to x\). Escolha \(j,\ell \geq 1\) tais que \(P^{j}(y,x)\gt 0\) e \(P^{\ell }(x,y)\gt 0\). Por Chapman–Kolmogorov,
Somando em \(n\),
Como \(x\) é recorrente, o critério anterior mostra que \(\sum _{n\geq 1}P^n(x,x)=\infty \); acrescentar o termo \(P^0(x,x)=1\) não altera a divergência. Logo a série no lado direito é infinita. Portanto a série de retornos a \(y\) também diverge, e o mesmo critério implica que \(y\) é recorrente.
A recorrência informa se voltamos a um estado; a periodicidade descreve em quais instantes esses retornos são possíveis.
2.5 Periodicidade dos estados
Período e aperiodicidade Para um estado \(x\), considere o conjunto dos possíveis tempos de retorno
Quando \(I_x\) é não vazio, o período de \(x\) é o máximo divisor comum de seus elementos. Se \(I_x=\varnothing \), não há retorno possível e não atribuímos período ao estado. O estado é aperiódico quando seu período é \(1\).
O período não mede quanto tempo a cadeia costuma levar para voltar. Ele detecta um ritmo obrigatório: período \(d\gt 1\) significa que todo retorno só pode ocorrer em tempos múltiplos de \(d\).
Na cadeia de Ehrenfest, uma bola muda de urna a cada passo. Portanto, o número de bolas na urna esquerda troca de paridade em todos os instantes: de um estado par a cadeia vai para um estado ímpar, e vice-versa.
Consequentemente, um retorno ao estado inicial só pode ocorrer após um número par de passos. Por outro lado, de qualquer estado há probabilidade positiva de mover uma bola e devolvê-la no passo seguinte. Assim,
para todo estado \(x\). Como \(2\) é um tempo possível de retorno e todos os tempos de retorno são pares, o período é \(2\).
Considere a cadeia da Figura 2.17. A partir de 0, escolhemos com probabilidade \(1/2\) um circuito de comprimento 3 ou um circuito de comprimento 4; depois de escolhido o circuito, o percurso de volta a 0 é determinístico.
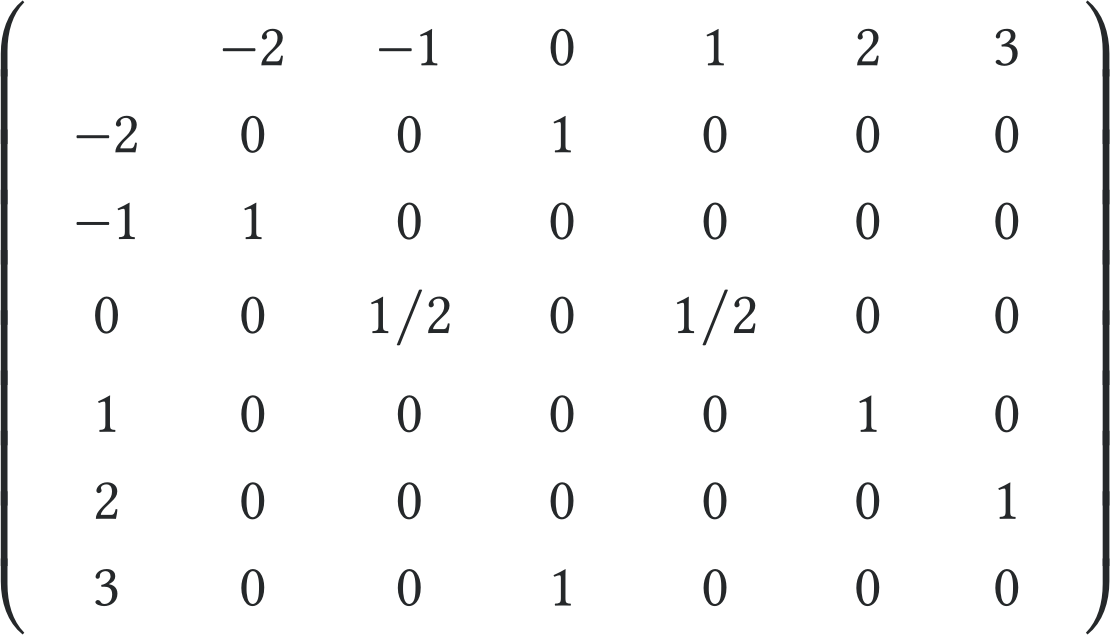
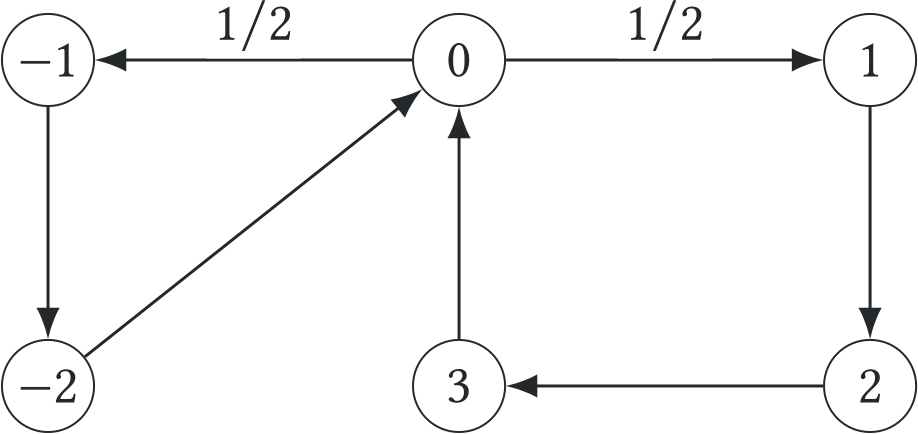
Temos \(P^{3}(0,0)\gt 0\) e \(P^{4}(0,0)\gt 0\). Como o máximo divisor comum de 3 e 4 é 1, o estado 0 é aperiódico, mesmo que \(p(0,0)=0\). O exemplo mostra que a existência de uma permanência é suficiente, mas não necessária, para aperiodicidade.
Períodos em uma classe Estados que se comunicam e admitem retorno em tempo positivo têm o mesmo período.
Escolha \(k,m\) tais que \(P^{k}(x,y)\gt 0\) e \(P^{m}(y,x)\gt 0\). Então
Logo, o período de \(x\) divide \(k+m\). Para qualquer \(\ell \in I_y\),
de modo que \(k+\ell +m\in I_x\). Subtraindo \(k+m\), concluímos que o período de \(x\) divide todo \(\ell \in I_y\); portanto, ele divide o período de \(y\). Trocando \(x\) e \(y\), obtemos a divisibilidade oposta. Os dois períodos são iguais.
Nesse caso, \(1\in I_x\), e o máximo divisor comum de um conjunto que contém \(1\) só pode ser \(1\).
No canal de comunicação do Exemplo 2.7, se \(0\lt a,b\lt 1\), ambos os estados possuem permanência positiva; portanto, a cadeia é aperiódica. Em uma cadeia irredutível, basta encontrar um único estado aperiódico, pois o Lema 2.18 transfere o período para toda a classe.
Voltaremos à periodicidade no próximo capítulo, ao investigar o comportamento das potências \(P^n\).
A classificação descreve a possibilidade de retorno. Em problemas de saída, interessa identificar por qual parte da fronteira a cadeia deixa uma região.
2.6 Distribuições de saída
Se \(A\subseteq S\), definimos o tempo de entrada em \(A\) por
Se \(A\) e \(B\) são disjuntos, escrevemos \(C=S\setminus (A\cup B)\). Partindo de \(x\in C\), a cadeia pode visitar vários estados de \(C\) antes de entrar em \(A\) ou em \(B\). Queremos saber qual conjunto ela atinge primeiro, e não onde estará em um instante fixo.
A probabilidade de atingir \(A\) primeiro é \(h(x)=\mathbb P_x(H_A\lt H_B)\). Ela vale \(1\) em \(A\) e \(0\) em \(B\); dentro de \(C\), o valor é determinado pela análise do primeiro passo. O próximo teorema torna essas condições precisas.
Problema de Dirichlet para cadeias de Markov Sejam \(A,B\subseteq S\) disjuntos e suponha que \(C=S\setminus (A\cup B)\) seja finito. Admita que \(H_A\wedge H_B\lt \infty \) quase certamente a partir de todo estado de \(C\). Então
é a única função que satisfaz
As condições na fronteira são imediatas: se a cadeia começa em \(A\), já atingiu \(A\) antes de \(B\); se começa em \(B\), ocorre o contrário. Para \(x\in C\), condicionando pelo primeiro passo e usando a propriedade de Markov,
Logo, \(h\) satisfaz as equações do enunciado.
Para a unicidade, seja \(u\) outra solução e ponha \(T=H_A\wedge H_B\). Mostraremos primeiro que, para todo \(n\geq 0\),
Para \(n=0\), isso é simplesmente \(u(x)=u(X_0)\). Para passar de \(n\) a \(n+1\), distinguimos dois casos. Se \(T\leq n\), a cadeia já chegou à fronteira e o valor observado em \(T\wedge (n+1)\) é o mesmo observado em \(T\wedge n\). Se \(T\gt n\), então \(X_n\in C\) e podemos usar a equação harmônica \(u(X_n)=\sum _y p(X_n,y)u(y)\). Essa passagem pode ser justificada sem introduzir esperança condicional em relação a toda a trajetória. Para \(z\in C\) e qualquer \(y\), o evento \(\{ T\gt n,X_n=z\} \) depende apenas dos estados até o instante \(n\), de modo que a propriedade de Markov fornece
Somando sobre \(z\) e \(y\), e separando o evento \(\{ T\leq n\} \), obtemos
A identidade segue, portanto, por indução.
Como \(u=1\) em \(A\), \(u=0\) em \(B\) e \(C\) é finito, existe \(M\lt \infty \) tal que \(|u(z)|\leq M\) em todos os estados. Em \(\{ T\leq n\} \) temos \(u(X_{T\wedge n})=u(X_T)\); em \(\{ T\gt n\} \), a diferença entre esses valores é no máximo \(2M\). Portanto,
A última passagem usa \(T\lt \infty \) quase certamente e a continuidade das probabilidades para eventos decrescentes. Como \(X_T\) pertence a \(A\cup B\),
Assim, a solução é única.
O adjetivo harmônica descreve a terceira equação: em cada estado interior, o valor de \(h\) é a média dos valores depois de um passo. Se \(R\) é a submatriz de \(P\) com linhas e colunas em \(C\) e
a contribuição da fronteira é exatamente \(v(x)\), pois \(h=1\) em \(A\) e \(h=0\) em \(B\). Assim, as equações interiores podem ser escritas como
Um rato percorre cinco salas ligadas pelas passagens indicadas na figura. A cada passo ele escolhe uniformemente uma das salas vizinhas. Na sala \(3\) está um gato; na sala \(5\), um pedaço de queijo. O passeio termina assim que o rato entra em uma dessas duas salas. Se ele começa na sala \(1\), qual é a probabilidade de encontrar o queijo antes do gato?
Escreva \(u(i)=\mathbb P_i(H_5\lt H_3)\). As condições de fronteira são \(u(3)=0\) e \(u(5)=1\). Pelas passagens desenhadas, a análise do primeiro passo fornece
Substituindo as duas últimas expressões na primeira,
e portanto
Embora existam duas salas de destino, a chance de sucesso não é \(1/2\): ela depende das passagens entre as salas. O desenho permite montar as equações sem escrever a matriz de transição completa.
Este problema é uma adaptação de um exemplo de Brémaud (2020).
Uma pessoa acompanha um saldo mensal limitado aos valores \(0,1,2,3\). A cada mês recebe uma unidade e tem uma despesa \(D_n\) independente dos meses anteriores, com
O saldo do fim do mês é limitado inferiormente por \(0\) e superiormente por \(3\):
Começando com saldo \(2\), qual é a probabilidade de atingir \(0\) em algum dos próximos quatro meses? Não basta calcular \(\mathbb P_2(X_4=0)\): a pessoa pode chegar a zero e depois voltar a ter saldo positivo. Para registrar se a falta de saldo já ocorreu, modificamos a cadeia tornando \(0\) absorvente. A matriz da cadeia assim parada, na ordem \((0,1,2,3)\), é
Por exemplo, partindo de \(1\), chegar a zero no próximo mês exige \(D_{n+1}=2\), o que ocorre com probabilidade \(1/4\). Elevando a matriz à quarta potência, obtemos a linha de interesse:
Como \(0\) é absorvente na nova cadeia,
Transformar em absorvente o conjunto cuja visita queremos registrar converte uma pergunta sobre toda a trajetória em uma probabilidade de transição em tempo fixo.
Voltemos ao jogo em que, a cada aposta, o capital aumenta uma unidade com probabilidade \(p\in (0,1)\) ou diminui uma unidade com probabilidade \(q=1-p\). O jogo termina ao atingir \(0\) (ruína) ou \(N\) (meta), com \(N\geq 2\). Seu tempo de término é \(H_{\{ 0,N\} }=H_0\wedge H_N\).
Se o capital inicial é \(i\), com \(0\leq i\leq N\), escrevemos
a probabilidade de alcançar a meta antes da ruína. Como a absorção em uma das barreiras é quase certa, a probabilidade de ruína é seu complemento, \(1-u_i\).
A análise de primeiro passo, demonstrada a seguir, fornece
No jogo justo, a chance de atingir a meta é a proporção do capital inicial em relação a ela, e não necessariamente \(1/2\). Quando há deriva, as diferenças sucessivas dessa chance formam uma progressão geométrica.
De qualquer estado interior, uma sequência de \(N\) perdas leva a uma barreira com probabilidade pelo menos \(q^N\gt 0\). Em blocos de \(N\) passos,
Assim, a absorção ocorre quase certamente e tem esperança finita. Pelo problema de Dirichlet,
A equação de primeiro passo pode ser reescrita como
Para aproveitar essa relação, ponha \(d_i=u_i-u_{i-1}\), a variação da probabilidade de sucesso quando a fortuna inicial aumenta de \(i-1\) para \(i\). Então
Portanto, as diferenças sucessivas formam uma progressão geométrica.
Se \(p=q=1/2\), temos \(d_{i+1}=d_i\), ou seja, todas as diferenças são iguais a \(d_1\). Como \(u_0=0\),
A condição \(u_N=1\) determina \(d_1=1/N\), e assim \(u_i=i/N\): no jogo justo, a probabilidade cresce linearmente com a fortuna inicial.
Se \(p\ne q\), escreva \(r=q/p\ne 1\). Pela recorrência, \(d_k=d_1r^{k-1}\) e, somando as diferenças,
Falta determinar \(d_1\). Usando a outra condição de fronteira,
Substituindo na expressão de \(u_i\), encontramos
Como a absorção em \(0\) ou \(N\) ocorre quase certamente, a probabilidade de ruína é \(1-u_i\).
2.7 Tempos de saída
Probabilidades de saída resolvem um problema de fronteira harmônico. Tempos esperados de saída resolvem uma equação quase igual, mas com um termo \(1\): cada passo realizado antes de atingir o conjunto de destino acrescenta uma unidade de tempo.
Se \(C=S\setminus A\) e começamos em \(x\in C\), a cadeia pode visitar vários estados de \(C\) antes de entrar em \(A\). O relógio para na primeira entrada, no instante \(H_A\).
Equação de Poisson para o tempo de saída Seja \(A\subseteq S\), suponha que \(C=S\setminus A\) seja finito e que \(H_A\lt \infty \) quase certamente a partir de todo \(x\in C\). Então
é a única solução de
Se \(C\) é vazio, a afirmação é imediata. Suponha \(C\) não vazio e escreva \(T=H_A\). Mostraremos primeiro que \(E_xT\) é finita. Para cada \(z\in C\), a hipótese de chegada quase certa permite escolher \(k_z\geq 1\) tal que \(\mathbb P_z(T\leq k_z)\gt 1/2\). Como \(C\) é finito, podemos tomar \(k=\max _{z\in C}k_z\), de modo que
Se a cadeia ainda não chegou a \(A\) no instante \(jk\), ela está em algum estado de \(C\). Condicionando nesse estado e usando a propriedade de Markov,
Repetindo a desigualdade, obtemos \(\mathbb P_x(T\gt jk)\leq 2^{-j}\). Agrupando os instantes \(j k,\ldots ,(j+1)k-1\) na fórmula da cauda,
Como \(T\geq 1\) quando \(x\in C\), a análise do primeiro passo dá
e \(E_xT=0\) em \(A\). Portanto, \(g\) satisfaz as equações.
Para provar a unicidade, seja \(u\) outra solução real, com \(u=0\) em \(A\). A equação de primeiro passo pode ser iterada enquanto a cadeia não atingiu \(A\). Mais precisamente, para cada \(n\geq 0\),
No instante inicial a identidade é trivial. Para passar de \(n\) a \(n+1\), em \(\{ T\leq n\} \) não há outro passo a contar; em \(\{ T\gt n\} \) temos \(X_n\in C\). Particionando esse evento segundo \(X_n=z\in C\), a propriedade de Markov dá
A equação \(u(z)=1+\sum _y p(z,y)u(y)\) acrescenta então uma unidade e substitui \(u(X_n)\) pela média de \(u(X_{n+1})\). Isso estabelece a identidade por indução. Como a soma das indicadoras conta exatamente os instantes anteriores a \(T\),
Como \(u=0\) em \(A\) e \(C\) é finito, existe \(M\lt \infty \) tal que \(|u|\leq M\). No evento \(\{ T\leq n\} \), o valor \(u(X_{T\wedge n})\) é zero. Assim,
Para o primeiro termo, a identidade de caudas truncadas dá
É o limite das somas parciais de uma série não negativa de soma finita. Logo, \(u(x)=E_xT=g(x)\), o que prova a unicidade.
Além da duração média até a saída, interessa o número esperado de visitas a cada estado antes de atingir \(A\). A matriz fundamental reúne essas contagens.
Ao formar \(R\), conservamos apenas as transições entre estados de \(C\). Partindo de \(x\in C\), a cadeia pode permanecer em \(C\) no próximo passo ou entrar em \(A\). Por isso,
A diferença entre essa soma e \(1\) é a probabilidade de entrar em \(A\) no primeiro passo. Assim, as linhas de \(R\) podem somar menos que \(1\).
Isso é importante ao calcular as potências de \(R\). Por exemplo,
Só aparecem caminhos que, no primeiro passo, passam por um estado \(z\) de \(C\) e, no segundo, chegam a \(y\). Um caminho que entrasse em \(A\) e depois retornasse a \(C\) ficaria de fora. De modo geral, pela propriedade de Markov,
Portanto, \(R^n(x,y)\) é a probabilidade de estar em \(y\) no instante \(n\) sem ter atingido \(A\) até esse instante. A fórmula inclui \(n=0\): como a cadeia começa em \(x\in C\), temos \(H_A\gt 0\) e \(R^0(x,y)=I(x,y)\).
Convergência da série. Pelo teorema anterior, \(E_xH_A\lt \infty \) para todo \(x\in C\). Como
a fórmula da cauda fornece
Logo, a série que define \(N\) converge entrada por entrada. A mesma desigualdade mostra que \(R^n\to 0\). Para cada \(m\), a multiplicação de uma soma finita de matrizes dá
Passando ao limite, obtemos \((I-R)N=I\). Como \(I-R\) é uma matriz quadrada, isso mostra que é inversível e que
Interpretação das entradas. Fixemos um estado \(y\in C\). Antes de chegar a \(A\), a cadeia pode visitar \(y\) nenhuma, uma ou várias vezes. O número dessas visitas é a variável aleatória
Somamos apenas os instantes \(0,1,\ldots ,H_A-1\): o estado ocupado no instante \(H_A\) já pertence a \(A\) e não entra na contagem. Em particular, quando \(x=y\), a observação inicial é uma visita. Esta contagem difere de \(N(y)\), usada no estudo da recorrência: aquela começa em \(n=1\) e não é interrompida na saída; aqui contamos desde o instante inicial até a primeira chegada a \(A\).
Para passar das probabilidades às visitas esperadas, lembremos que a esperança de uma indicadora é a probabilidade do evento correspondente: \(E_x\mathbf1_B=\mathbb P_x(B)\). Além disso,
O segundo fator faz com que uma visita só seja contada quando ocorre antes da chegada a \(A\). De fato, ele vale \(1\) exatamente para \(n=0,\ldots ,H_A-1\) e vale \(0\) depois disso. Consequentemente,
Podemos agora passar das probabilidades às visitas esperadas:
A troca da soma pela esperança é permitida porque as indicadoras são não negativas (Lema 2.15). A última igualdade usa a identidade anterior, isto é, a definição de \(V_y\). Portanto, a entrada \(N(x,y)\) é o número esperado de visitas a \(y\) antes de atingir \(A\), quando partimos de \(x\). Ela não é, em geral, uma probabilidade.
Da contagem de visitas ao tempo de saída. Em cada instante \(n\lt H_A\), a cadeia ocupa exatamente um estado de \(C\). Nesse instante, portanto, exatamente uma das indicadoras \(\mathbf1_{\{ X_n=y\} }\), com \(y\in C\), vale \(1\); todas as outras valem \(0\). Assim, somar as visitas a todos os estados de \(C\) conta uma vez cada instante anterior à saída:
Tomando esperanças, encontramos
Em outras palavras, somar a linha de \(N\) correspondente ao estado inicial \(x\) fornece o tempo médio até a chegada a \(A\).
Também podemos reunir as equações de primeiro passo em notação matricial. Escrevamos \(C=\{ x_1,\ldots ,x_m\} \), na mesma ordem das linhas e colunas de \(R\), e definamos os vetores-coluna
Assim, \(g_C\) não é uma matriz de transição: cada uma de suas \(m\) coordenadas é a duração média da cadeia até \(A\) para um estado inicial diferente. Para \(x\in C\), a equação de primeiro passo é
O termo \(1\) representa o primeiro passo; se ele levar a \(A\), o tempo restante será zero. Reunindo essas equações e usando \(N=(I-R)^{-1}\), temos
A coordenada de \(N\mathbf1\) associada a \(x\) é justamente a soma da linha de \(N\) correspondente a \(x\), como já havíamos obtido pela contagem de visitas.
Retomemos o curso de dois anos do Exemplo 2.32. Os estados \(1\) e \(2\) são transientes; \(G\) (conclusão) e \(D\) (abandono) são absorventes. Separemos a matriz de transição em dois blocos: \(R\) reúne as transições dentro dos estados transientes, e \(K\) registra as transições desses estados para \(G\) e \(D\):
A matriz fundamental pode ser calculada invertendo \(I-R\):
A primeira linha de \(N\) responde a duas perguntas: partindo do primeiro ano, quantas vezes, em média, o estudante estará em cada ano antes de concluir ou abandonar? Temos \(N(1,1)=4/3\) visitas esperadas ao primeiro ano, incluindo a observação inicial, e \(N(1,2)=1\) visita esperada ao segundo ano.
O valor \(N(1,2)=1\) é uma contagem média, não uma probabilidade. A chance de alcançar o segundo ano antes de abandonar é
Uma vez no segundo ano, o número médio de visitas a ele, incluindo a primeira, é \(1/(1-1/5)=5/4\), porque em cada passo há probabilidade \(1/5\) de permanecer nesse estado. O produto
mostra como uma probabilidade de chegada pode se transformar num número esperado de visitas.
Para calcular a probabilidade de terminar em cada estado absorvente, podemos sair de um estado transiente após \(0,1,2,\ldots \) transições dentro do conjunto \(\{ 1,2\} \). Somando essas possibilidades, obtemos
Assim, começando no primeiro ano, a probabilidade de conclusão é \(7/10\), como havíamos encontrado por análise de primeiro passo, e a de abandono é \(3/10\).
Finalmente, a soma das entradas de cada linha de \(N\) dá o tempo esperado até chegar a \(G\) ou \(D\):
A mesma matriz fornece, portanto, visitas esperadas, probabilidades de absorção e duração média.
Voltemos ao computador do Exemplo 2.6. Antes do descarte, ele pode estar funcionando (\(F\)) ou em reparo (\(R\)). A matriz das transições entre esses dois estados é
O descarte ocorre quase certamente. De fato, partindo de \(F\), há probabilidade positiva de passar por \(F\to R\to D\) em dois dias; partindo de \(R\), há probabilidade \(0{,}05\) de ser descartado no próximo. Como o conjunto \(\{ F,R\} \) é finito, essas possibilidades permitem uma cota geométrica uniforme para o tempo de absorção.
A matriz fundamental é
Por exemplo, a primeira linha mostra que um computador inicialmente em funcionamento passa, em média, \(\boxed {3800}\) dias funcionando e \(\boxed {20}\) dias em reparo antes do descarte, contando também a observação inicial. Assim,
Se começamos com o computador em reparo, a segunda linha fornece \(E_RH_D=3600+20=3620\) dias.
Como verificação independente, as equações de primeiro passo para \(g_F=E_FH_D\) e \(g_R=E_RH_D\) são
A primeira dá \(g_F=g_R+200\); a segunda então dá \(g_R=3620\) e \(g_F=3820\), confirmando a matriz fundamental. O mesmo modelo fornece dois tipos de informação: duração total e tempo passado em cada estado.
No jogo justo, dobrar simultaneamente o capital inicial e a meta conserva a probabilidade de sucesso, mas multiplica por quatro a duração média. Quando há deriva, a duração depende também da direção favorecida pelas apostas.
Já verificamos que o tempo \(H_{\{ 0,N\} }\) tem esperança finita. Como nenhuma rodada é necessária quando o jogo começa numa barreira, \(v_0=v_N=0\). Nos estados interiores, o primeiro passo consome uma rodada e deixa o capital em \(i+1\) ou \(i-1\). Portanto,
Jogo justo: \(p=q=1/2\). Reorganizando a equação, obtemos
A segunda diferença é constante; por isso, procuramos uma solução quadrática \(v_i=-i^2+Ai+B\). De \(v_0=0\) vem \(B=0\) e, de \(v_N=0\),
Assim,
Jogo com deriva: \(p\ne q\). A equação homogênea associada é \(w_i=pw_{i+1}+qw_{i-1}\). Reescrevendo-a como
vemos que, quando \(p\ne q\), suas soluções são \(w_i=A+B(q/p)^i\). Precisamos ainda de uma solução particular da equação que contém o termo \(1\). A função
serve, pois uma substituição direta fornece
Portanto, a solução geral pode ser escrita como
Impondo \(v_0=0\), obtemos \(A=-B\), isto é,
A outra fronteira, \(v_N=0\), determina a constante:
Substituindo essa expressão em \(v_i\), chegamos a
pois a fração é exatamente a probabilidade \(u_i\) encontrada no exemplo anterior. A unicidade da equação de Poisson garante que essa solução é a esperança procurada.
No capítulo de martingais, obteremos essas probabilidades por uma segunda demonstração. A nova ferramenta conservará esperanças até a saída e evitará resolver novamente as equações de diferenças.
2.8 Problemas de síntese
O sapo em quatro folhas, uma rede elétrica e a manutenção de um computador reúnem as técnicas de transição, chegada e absorção. As soluções a seguir mostram como as mesmas equações respondem a perguntas sobre percursos, tempos e custos.
Retomemos o sapo do Exemplo 2.1. As folhas \(A\), \(B\) e \(C\) formam um triângulo, e a folha \(D\) está ligada somente a \(C\). O sapo parte de \(A\), escolhe uniformemente uma folha vizinha em cada salto e quer chegar a \(D\).
Quanto tempo levará, em média, para chegar a \(D\)? Escreva \(e_x=E_xH_D\). O problema de Poisson dá \(e_D=0\) e
Os estados \(A\) e \(B\) desempenham papéis simétricos, logo \(e_A=e_B=t\). Se escrevermos \(e_C=v\), as equações se reduzem a
A primeira fornece \(t=2+v\). Substituindo na segunda,
Portanto,
E qual é a chance de atingir \(D\) antes de voltar pela primeira vez a \(A\)? Comecemos em \(B\) ou \(C\) e definamos \(u_x=\mathbb P_x(H_D\lt H_A)\). As condições de fronteira são \(u_A=0\), \(u_D=1\); pelo problema de Dirichlet,
Daí \(u_C=2/5\) e \(u_B=1/5\). Partindo de \(A\), o primeiro salto vai para \(B\) ou \(C\), cada um com probabilidade \(1/2\). Assim,
O tempo médio até o alvo e a chance de alcançá-lo antes do primeiro retorno descrevem aspectos distintos do percurso nesse grafo.
Considere o grafo à esquerda da figura: entre \(a\) e \(b\) existem dois caminhos de comprimento dois, passando por \(x\) e \(y\). Em cada vértice o passeio escolhe um vizinho uniformemente. Perguntamos pela probabilidade de voltar a \(a\) antes de atingir \(b\).
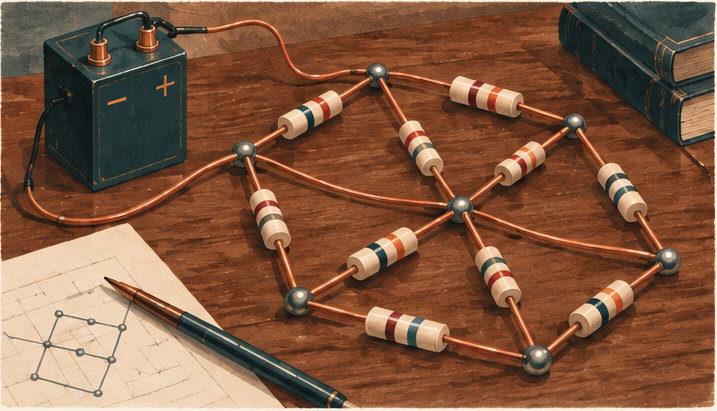
Seja \(h(z)=\mathbb P_z(H_a\lt H_b)\), de modo que \(h(a)=1\) e \(h(b)=0\). No grafo A, pela análise de primeiro passo,
Partindo de \(a\), a primeira transição chega a \(x\) ou \(y\) com probabilidade \(1/2\). Portanto,
Substitua agora cada aresta por um resistor de \(1\, \Omega \) e mantenha os potenciais \(v(a)=1\) e \(v(b)=0\). A lei de Kirchhoff nos vértices interiores exige que a soma das correntes seja zero:
São exatamente as equações satisfeitas por \(h\). Logo, os potenciais são as probabilidades de atingimento. Os dois caminhos possuem resistência \(2\, \Omega \) cada e estão em paralelo; a resistência efetiva entre \(a\) e \(b\) é, assim, \(1\, \Omega \).
Na rede B, eliminamos a aresta \(y\)–\(b\). A partir de \(y\), a próxima transição leva obrigatoriamente a \(a\), de modo que \(h(y)=1\), enquanto \(h(x)=1/2\) permanece igual. Consequentemente,
A resistência efetiva passa a ser \(2\, \Omega \): o ramo que termina em \(y\) não conduz corrente até \(b\).
Podemos tornar exata a conexão entre resistência e probabilidade, para qualquer um desses grafos com resistores de \(1\, \Omega \). Com potenciais \(v(a)=1\) e \(v(b)=0\), a corrente total que sai de \(a\) é
Como \(v(z)=\mathbb P_z(H_a\lt H_b)\), a análise do primeiro passo fornece
A diferença de potencial entre \(a\) e \(b\) é uma unidade; pela definição de resistência efetiva, \(R_{\mathrm{ef}}(a,b)=1/I\). Portanto,
Nos dois grafos, \(d(a)=2\). Com resistência \(1\, \Omega \) recuperamos a probabilidade \(1/2\); com resistência \(2\, \Omega \), obtemos \(3/4\). Retirar a ligação aumentou a resistência e a chance de voltar a \(a\) antes de atingir \(b\). A identidade explica a relação, em vez de apenas compará-las.
Retomemos o computador do Exemplo 2.6. Em cada dia ele está funcionando (\(F\)), em reparo (\(R\)) ou definitivamente descartado (\(D\)). Antes do descarte, a submatriz das transições é
As entradas de \(N\) contam os dias esperados em cada estado antes do descarte, incluindo o dia inicial. Assim, começando em funcionamento, o computador passa, em média, \(3800\) dias em \(F\) e \(20\) dias em \(R\).
Suponha que cada dia de funcionamento produza um resultado líquido de R\$ \(5\), cada dia em reparo custe R\$ \(120\) e o descarte tenha custo fixo de R\$ \(500\). A empresa pode pagar os reparos por dia ou contratar, no início, um plano de R\$ \(2000\) que cobre todos os dias de reparo até o descarte. Admitimos que a contratação não altere as probabilidades de transição nem os demais custos.
Sem contrato, o valor esperado do resultado acumulado é
Com o plano de manutenção, pagamos uma única vez pelos reparos, de modo que
Portanto, segundo o critério do resultado esperado, o contrato é preferível por R\$ \(400\). A vantagem não se repete necessariamente em cada trajetória, pois o número efetivo de dias em reparo é aleatório.
A comparação desconsidera juros, inflação, aversão ao risco e mudanças na qualidade dos reparos. Para comparar com a compra imediata de outro computador, precisaríamos também modelar seu custo e seu funcionamento. A comparação econômica obtida pela matriz fundamental permanece condicionada a essas hipóteses.
A análise de primeiro passo relaciona, assim, percursos, tempos e custos. A interpretação das respostas acompanha a modelagem de cada situação.
2.9 Modelos ocultos de Markov*
O engajamento de um usuário não é observado diretamente: registramos ações, como cliques ou dias sem acesso. Um usuário engajado pode passar um dia sem clicar, e um usuário pouco engajado pode clicar por acaso. O modelo distingue, assim, o estado que evolui da observação imperfeita desse estado.
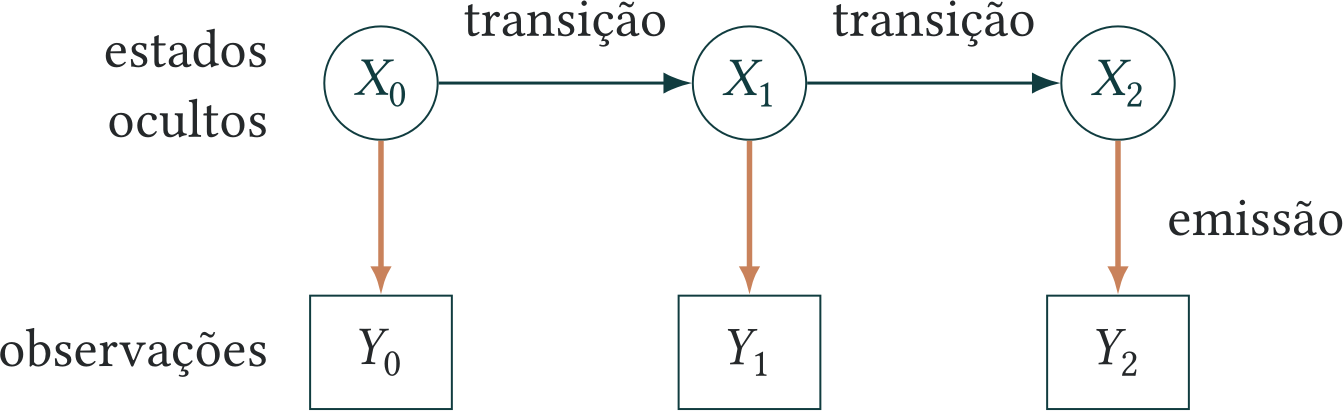
Se observássemos \(X_n\), bastaria usar a matriz \(P\) para prever o próximo estado. Como vemos apenas \(Y_n\), não sabemos com certeza onde a cadeia está. Em vez de um estado, precisamos carregar uma distribuição sobre os estados possíveis.
A descrição acima determina a lei conjunta. A Proposição 2.1 fornece a probabilidade da trajetória oculta; multiplicamos essa probabilidade pelas emissões condicionalmente independentes. Escrevendo \(x_{0:n}=(x_0,\ldots ,x_n)\) e analogamente \(y_{0:n}\),
Os fatores correspondem à distribuição inicial, às transições e às emissões. Essa fatoração permite calcular a distribuição do estado oculto a partir das observações.
O problema de filtragem é o seguinte: depois de observar \(Y_0,\ldots ,Y_n\), qual é a nossa distribuição para o estado atual \(X_n\)? Definimos
Quando chega uma nova observação, a atualização ocorre em dois movimentos. Primeiro deixamos a cadeia evoluir, sem ainda olhar o novo dado. Depois usamos o novo dado para corrigir a previsão:
O primeiro passo combina as transições da cadeia com a hipótese de que cada emissão depende apenas do estado oculto do mesmo instante; o segundo usa a regra de Bayes para incorporar a nova observação.
Comecemos pela previsão. Condicionamos segundo o estado atual:
A propriedade de Markov descreve a relação entre os estados ocultos. Para incluir as observações, usamos também a hipótese de emissão. Na fatoração da lei conjunta, com \(x_n=i\), o fator final é \(p_{ij}\), que não depende dos estados ou das observações anteriores. Para \(n\geq 1\),
Para \(n=0\), a mesma igualdade é simplesmente \(\mu _0(i)b_i(y_0)p_{ij}=p_{ij}\mathbb P(X_0=i,Y_0=y_0)\). Quando o evento condicionado tem probabilidade positiva, a divisão mostra que o primeiro fator da soma anterior é \(p_{ij}\); o segundo é \(r_n(i)\). Estados com \(r_n(i)=0\) não contribuem para a soma. Obtemos, portanto,
Agora chega a observação \(Y_{n+1}=y_{n+1}\). Pela regra de Bayes,
A hipótese de emissão transforma o primeiro fator do numerador em \(b_j(y_{n+1})\). Para obter o denominador, somamos o numerador sobre todos os estados possíveis. Surge exatamente
A fórmula para \(r_0\) é o mesmo argumento de Bayes aplicado à primeira observação.
A multiplicação por \(P\) faz a previsão: mesmo sem receber informação nova, nossa crença sobre o estado muda porque o próprio sistema evolui. A multiplicação por \(b_j(y_{n+1})\) faz a correção: estados que explicam melhor a observação recebem mais peso. A normalização final apenas faz esses novos pesos somarem um.
Toda a história \(y_0,\ldots ,y_n\) influencia o futuro através de \(r_n\). Depois de calcular essa distribuição, não precisamos refazer os cálculos desde o início quando chega o próximo dado. O vetor \(r_n\) é o nosso estado de conhecimento sobre a cadeia oculta. Essa recursão é frequentemente chamada de algoritmo forward.
Tome \(X_n\in \{ E,D\} \), onde \(E\) significa engajado e \(D\), desengajado, e \(Y_n\in \{ C,S\} \), onde \(C\) significa clique e \(S\), silêncio no dia. Suponha
Considere a sequência de observações
Antes de qualquer observação, atribuímos probabilidades iguais aos dois estados. O primeiro dado é um clique. Como um clique é muito mais provável em \(E\) do que em \(D\), Bayes produz
Assim, depois do clique, a probabilidade de engajamento é aproximadamente \(0{,}818\).
No dia seguinte, antes de observar qualquer ação, fazemos a previsão:
A probabilidade prevista de engajamento é agora aproximadamente \(0{,}709\). Ela mudou mesmo antes de chegar um novo dado: o estado oculto também pode ter mudado.
Observamos então silêncio. Sob \(E\), essa observação tem probabilidade \(0{,}1\); sob \(D\), probabilidade \(0{,}8\). Multiplicamos a previsão por esses dois pesos:
Normalizando,
A probabilidade de engajamento cai para aproximadamente \(0{,}234\). Ela não cai a zero: silêncio é evidência contra engajamento, não uma observação direta do estado.
Antes da terceira observação,
A probabilidade prevista de engajamento sobe para aproximadamente \(0{,}417\), pois a matriz permite que um usuário desengajado volte a se engajar. Agora observamos um clique. A correção dá
A probabilidade de engajamento volta a aproximadamente \(0{,}763\).
O percurso completo pode ser lido em duas etapas:
Entre observações, a matriz de transição atualiza a previsão; cada nova observação a corrige. A filtragem repete essas duas operações.
Em uma cadeia observada, registramos o próprio \(X_n\). No HMM, registramos \(Y_n\) e mantemos uma distribuição sobre \(X_n\). Por isso, \((Y_n)\) em geral não é uma cadeia de Markov: saber apenas a última observação pode perder informação que as observações anteriores forneceram sobre o estado oculto.
Para ir além. A filtragem é apenas uma das perguntas possíveis em modelos ocultos de Markov. Podemos usar observações futuras para rever o que acreditávamos sobre estados passados (smoothing), procurar uma trajetória oculta particularmente plausível (problema associado ao algoritmo de Viterbi) ou estimar a matriz de transição e as probabilidades de emissão a partir dos próprios dados, por exemplo com o algoritmo de Baum–Welch. Esses temas são tratados em Rabiner (1989) e, com numerosos exemplos de séries temporais, em Zucchini et al. (2016).
2.10 Exercícios
Os exercícios retomam a construção de matrizes, a probabilidade de trajetórias, os critérios de recorrência, a propriedade forte de Markov e os problemas de absorção.
2.11 Exercícios complementares*