Cadeias de Markov
Um jogo termina ao atingir uma barreira; uma rede de memória tenta corrigir uma entrada; um usuário pode voltar a usar um serviço ou abandoná-lo. Em cada caso, a primeira decisão é escolher o que chamaremos de estado. Que informação do passado precisa ser guardada para prever o próximo passo?
Partiremos dessa escolha para construir matrizes de transição, classificar estados e estudar retornos e saídas. Em seguida, passaremos ao equilíbrio, à convergência e à velocidade com que a cadeia perde a memória do estado inicial. As seções com asterisco apresentam modelos ocultos de Markov, PageRank e otimização por colônias de formigas como aplicações complementares; a última antecipa ideias desenvolvidas nos capítulos de tempo contínuo e martingais.
Uma rede que recupera uma lembrança
Reconhecemos uma letra mesmo quando alguns traços estão apagados. Uma memória associativa procura fazer algo semelhante: recebe uma configuração incompleta ou corrompida e a modifica até aproximá-la de um padrão armazenado. Antes de formalizar cadeias de Markov, vale acompanhar um modelo mínimo dessa ideia.
Representaremos cada neurônio por uma unidade que pode estar inativa ou ativa. A configuração de uma rede com \(N\) unidades neuronais no instante \(n\) é o vetor
Essa variável binária também é chamada de spin, por analogia com modelos da física. O peso \(w_{ij}\) mede a influência de \(j\) sobre \(i\); nesta primeira versão, \(w_{ij}=w_{ji}\) e \(w_{ii}=0\). O campo local na unidade \(i\) é
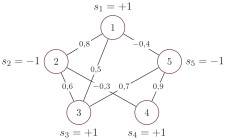
Em cada passo, escolhemos aleatoriamente uma das \(N\) unidades, todas com probabilidade \(1/N\), independentemente das escolhas anteriores. Apenas a unidade escolhida é atualizada. Se ela é a unidade \(i\), tomamos \(s_i(n+1)=+1\) quando \(h_i(s(n))\gt 0\) e \(s_i(n+1)=-1\) quando \(h_i(s(n))\lt 0\); se \(h_i(s(n))=0\), conservamos o valor anterior, \(s_i(n+1)=s_i(n)\). Para \(j\ne i\), fazemos \(s_j(n+1)=s_j(n)\).
A aleatoriedade dessa dinâmica vem da escolha da unidade que será atualizada. Conhecida a configuração atual, essa escolha determina a distribuição da configuração seguinte.
Aprendizado e recuperação são tarefas distintas. No aprendizado, escolhemos os pesos a partir dos padrões que desejamos guardar. Na recuperação, fixamos esses pesos e deixamos a configuração evoluir a partir da entrada recebida. A rede não precisa consultar uma lista de padrões a cada atualização: a informação foi incorporada às interações.
Para guardar o padrão \(\xi =(+1,+1,+1)\) em três unidades, tomemos \(w_{ij}=1/3\) para \(i\ne j\). Se a entrada é \(s(0)=(-1,+1,+1)\), então
A atualização da primeira unidade corrige o spin errado. Podemos acompanhar essa correção por uma energia,
As energias antes e depois da correção são
A mudança é \(-4/3\). Mais geralmente, ao alterar apenas a unidade \(i\), a simetria dos pesos dá
Essa conta sugere uma dinâmica que desce a energia. Ela não garante que toda entrada chegue ao padrão desejado: podem existir outros estados estáveis, e armazenar muitos padrões pode gerar interferência entre eles.
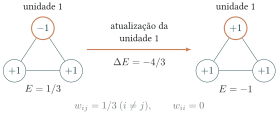
Atualizar uma unidade por vez é uma dinâmica assíncrona.
Como, conhecida a configuração \(s(n)\), a escolha aleatória da unidade determina a lei de \(s(n+1)\) sem depender das configurações anteriores, o processo \((s(n))_{n\geq 0}\) é uma cadeia de Markov no espaço \(\{ -1,+1\} ^N\).
Essa pequena rede antecipa perguntas que retornam ao longo do livro: quais configurações são estáveis, quanto tempo a dinâmica leva para chegar a elas e como a aleatoriedade altera esse comportamento. A Seção ?? retomará a rede de Hopfield com a definição completa, a demonstração de descida da energia, um exemplo com duas letras e a passagem para atualizações de Gibbs.
2.1 Definições e exemplos
Nas seções teóricas deste capítulo, o espaço de estados \(S\) será finito ou enumerável. A seção opcional sobre colônias de formigas amplia pontualmente essa linguagem para um vetor de estados contínuo.
A distribuição inicial e as probabilidades de transição determinam a lei da trajetória. Para usar essa descrição, o estado \(X_n\) deve reunir a informação do passado relevante para prever o passo seguinte. A propriedade de Markov afirma que, conhecido esse estado, o restante do histórico não melhora a previsão. Se a escolha do estado deixa de fora informação relevante, podemos precisar ampliá-lo, como veremos em um dos exemplos.
Cadeia homogênea e matriz de transição A cadeia é homogênea no tempo quando
não depende de \(n\). A matriz \(P=(p(i,j))_{i,j\in S}\) é sua matriz de transição. Suas entradas são não negativas e cada linha soma \(1\).
Na entrada \(p(i,j)\), a linha \(i\) representa o estado atual e a coluna \(j\) representa o próximo estado. Portanto,
para cada \(i\): partindo de \(i\), a cadeia precisa estar em algum estado no passo seguinte.
A prova é por indução em \(m\). Para \(m=1\), a afirmação é exatamente a definição de homogeneidade.
Suponha agora que, para algum \(m\geq 1\), as probabilidades
não dependam de \(n\). Condicionando no estado intermediário \(X_{n+m}\) e usando a propriedade de Markov,
Pela hipótese de indução, o lado direito não depende de \(n\). Isso conclui a indução.
Assim, exigir homogeneidade nas transições de um passo é suficiente: a mesma homogeneidade vale automaticamente para transições em qualquer número fixo de passos.
Um sapo ocupa uma de quatro folhas, que chamaremos de \(A\), \(B\), \(C\) e \(D\). Nem toda folha está ao alcance de qualquer outra: as ligações possíveis são as indicadas no grafo abaixo. A cada passo, o sapo escolhe uniformemente uma das folhas ligadas à folha em que se encontra. Se \(X_n\) indica a folha ocupada depois do \(n\)-ésimo salto, então \((X_n)\) é uma cadeia de Markov: conhecida a folha atual, o próximo salto não depende do caminho percorrido antes.
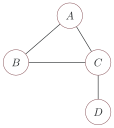
Na ordem \((A,B,C,D)\), as probabilidades são obtidas contando os vizinhos de cada folha. A matriz de transição é
Daqui em diante, salvo indicação contrária, consideraremos cadeias homogêneas no tempo. Nas fórmulas de probabilidades condicionais, entenderemos sempre que o evento condicionado tem probabilidade positiva. A matriz de transição especifica a dinâmica a partir de cada estado, inclusive daqueles que têm probabilidade inicial zero.
Considere um jogo com rodadas independentes. Em cada rodada, o jogador ganha uma unidade monetária com probabilidade \(p=0{,}4\) ou perde uma unidade com probabilidade \(1-p=0{,}6\). O jogo termina quando sua fortuna atinge \(0\) ou \(N\) unidades monetárias.
Se \(X_n\) é a fortuna depois de \(n\) rodadas, então, para \(0\lt i\lt N\) e qualquer histórico compatível,
O lado direito depende apenas da fortuna presente. Portanto, a propriedade de Markov vale e a matriz de transição contém todas as regras do jogo. Neste caso,
Para \(N=5\), o grafo de transição torna visíveis as duas possibilidades em cada estado interior e as duas barreiras absorventes:
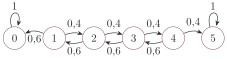
A matriz correspondente é
| 0 | 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|---|
| 0 | 1{,}0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 0{,}6 | 0 | 0{,}4 | 0 | 0 | 0 |
| 2 | 0 | 0{,}6 | 0 | 0{,}4 | 0 | 0 |
| 3 | 0 | 0 | 0{,}6 | 0 | 0{,}4 | 0 |
| 4 | 0 | 0 | 0 | 0{,}6 | 0 | 0{,}4 |
| 5 | 0 | 0 | 0 | 0 | 0 | 1{,}0 |
Os estados 0 e \(N\) são absorventes: quando a fortuna atinge uma das barreiras, o jogo termina.
Esta cadeia surgiu na física como um modelo simplificado da troca de partículas entre dois recipientes. Na versão matemática, distribuímos \(N\geq 1\) bolas entre duas urnas. A cada passo, escolhemos uma das \(N\) bolas ao acaso e a transferimos para a outra urna.
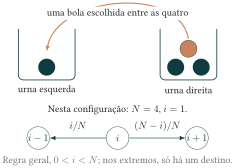
Seja \(X_n\) o número de bolas na urna esquerda depois do \(n\)-ésimo passo. Conhecer \(X_n=i\) basta para determinar as probabilidades do passo seguinte: há \(N-i\) bolas na urna direita e \(i\) na esquerda. Assim, para \(0\leq i\lt N\),
pois \(X_n\) aumenta quando a bola escolhida está na urna direita. Do mesmo modo, \(X_n\) diminui em uma unidade com probabilidade \(i/N\). Logo,
e \(p(i,j)=0\) nos demais casos. Quando \(N=4\), por exemplo, a matriz é
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 0 | 1 | 0 | 0 | 0 |
| 1 | 1/4 | 0 | 3/4 | 0 | 0 |
| 2 | 0 | 2/4 | 0 | 2/4 | 0 |
| 3 | 0 | 0 | 3/4 | 0 | 1/4 |
| 4 | 0 | 0 | 0 | 1 | 0 |
Nos exemplos da ruína do jogador e de Ehrenfest, partimos de uma descrição verbal e extraímos as probabilidades de transição. Reciprocamente, qualquer família \(p(i,j)\) que satisfaça
\(p(i,j)\geq 0\) para todos os estados \(i,j\);
\(\sum _jp(i,j)=1\) para cada estado \(i\),
define uma matriz de transição. Para construir a cadeia, estando em \(i\), sorteamos o próximo estado \(j\) segundo a distribuição dada pela linha \(i\) da matriz.
Um dígito binário atravessa sucessivas etapas de transmissão. Em cada etapa, um \(0\) é trocado por \(1\) com probabilidade \(a\), enquanto um \(1\) é trocado por \(0\) com probabilidade \(b\), independentemente do que ocorreu antes. Se \(X_n\in \{ 0,1\} \) é o dígito que entra na etapa \(n\), então \((X_n)\) é uma cadeia de Markov com matriz
Uma questão natural é calcular \(\mathbb {P}(X_n=X_0)\) e investigar se a informação sobre o bit original desaparece quando \(n\) cresce. O canal simétrico corresponde ao caso \(a=b=1-p\), em que cada etapa preserva o dígito com probabilidade \(p\).
2.2 Probabilidades de transição em vários passos
A matriz \(P\) descreve um passo. Para descrever \(m\) passos, precisamos somar sobre todos os estados intermediários possíveis. A multiplicação de matrizes faz exatamente essa contabilidade.
Distribuição inicial e lei da cadeia A matriz de transição descreve como a cadeia se move, mas ainda é preciso dizer onde ela começa. A distribuição inicial é a distribuição \(\mu \) de \(X_0\):
Escrevemos \(\mathbb {P}_\mu \) para a lei da trajetória quando \(X_0\) tem distribuição \(\mu \) e \(E_\mu \) para a esperança correspondente.
Quando o estado inicial é fixo, usamos uma notação mais curta: \(\mathbb {P}_x\) é a lei da cadeia que começa em \(x\), isto é, \(\mathbb {P}_x(X_0=x)=1\), e \(E_x\) é a esperança sob essa lei. Assim, para qualquer evento \(A\) determinado pela trajetória,
A fórmula apenas separa os casos possíveis para o estado inicial. Quando \(\mu (x)\gt 0\), \(\mathbb {P}_x\) também pode ser visto como a lei condicional \(\mathbb {P}_\mu (\, \cdot \mid X_0=x)\).
Voltemos ao sapo do Exemplo 2.1. Se ele começa em \(A\), para estar novamente em \(A\) depois de dois saltos há exatamente duas possibilidades:
As probabilidades desses caminhos são, respectivamente,
Portanto,
Consideremos agora a probabilidade de o sapo, partindo de \(A\), estar em \(B\) depois de três saltos. Há três caminhos possíveis:
Desta vez os caminhos não têm todos a mesma probabilidade:
Logo,
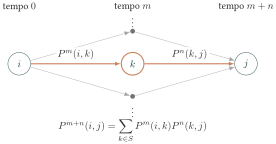
Equação de Chapman–Kolmogorov Para \(m,n\geq 0\),
Em notação matricial, \(P^{m+n}=P^mP^n\). Em particular, as probabilidades em \(m\) passos são as entradas da potência usual \(P^m\).
Condicionamos pelo estado ocupado após os primeiros \(m\) passos. Os eventos \(\{ X_m=k\} \), para \(k\in S\), são disjuntos e cobrem todas as possibilidades, de modo que
O primeiro fator é, por definição, \(P^m(i,k)\). Para o segundo, uma vez conhecido \(X_m=k\), a propriedade de Markov permite esquecer os estados anteriores a \(m\); pela homogeneidade, podemos ainda deslocar a origem do tempo. Portanto,
Substituindo esses dois fatores obtemos
Se \(\mathbb {P}_i(X_m=k)=0\), o termo correspondente já é zero, por isso esses estados podem ser incluídos sem restrição na soma final.
Se a distribuição inicial é o vetor-linha \(\mu _0\), então a distribuição de \(X_m\) é \(\mu _0P^m\). Essa identidade será o ponto de partida para o estudo do comportamento de longo prazo.
2.2.1 Estimação de transições e retenção de usuários
Uma matriz útil raramente chega pronta. Suponha que registremos, ao fim de cada semana, o número de dias em que cada usuário acessou um serviço. Fixamos antes da análise os estados \(A=\) ativo (quatro ou mais dias), \(P=\) pouco ativo (um a três dias), \(I=\) inativo (nenhum acesso) e \(B=\) abandono (conta encerrada). Aqui o encerramento é definitivo; inatividade, por si só, permite retorno.
Considere a seguinte tabela didática de contagens, obtida a partir de pares de semanas consecutivas de vários usuários acompanhados no mesmo período:
Os estados \(A\), \(P\), \(I\) e \(B\) representam, respectivamente, usuários ativos, pouco ativos, inativos e que abandonaram o serviço. A entrada \(N_{ij}\) conta quantas vezes foi observada uma transição do estado \(i\) para o estado \(j\):
Um mesmo usuário pode contribuir com vários pares de semanas consecutivas. Naturalmente, não conectamos a última observação de um usuário à primeira de outro e não interpretamos uma semana sem observação como inatividade.
A tabela permite estimar diretamente as probabilidades de transição. Se
é o número total de transições observadas a partir do estado \(i\), tomamos
Ou seja, estimamos a probabilidade de passar de \(i\) para \(j\) pela frequência com que essa transição apareceu entre todas as transições iniciadas em \(i\).
Por exemplo, das \(100\) transições observadas a partir de \(A\), \(70\) terminaram novamente em \(A\), \(20\) em \(P\) e \(10\) em \(I\). Assim,
Procedendo da mesma forma nas demais linhas, obtemos
As três primeiras linhas foram estimadas a partir das observações. A última é uma hipótese do modelo: depois do abandono não são coletadas novas transições, e consideramos \(B\) um estado absorvente.
Suponha agora que um usuário esteja ativo no instante inicial. Sua distribuição inicial é \((1,0,0,0)\) e, portanto,
A última coordenada da primeira expressão pode também ser obtida diretamente. Para que um usuário inicialmente ativo tenha abandonado o serviço em até dois passos, ele deve seguir um dos caminhos
Logo,
Como \(B\) é absorvente, a última coordenada de \((1,0,0,0)\widehat P^3\) representa a probabilidade estimada de abandono até o terceiro passo:
Em aplicações, o abandono de usuários ou clientes é frequentemente chamado de churn. A fração ou probabilidade de abandono em um período é então chamada de taxa de churn; ela é uma medida importante em serviços por assinatura, plataformas digitais e outros sistemas nos quais se deseja acompanhar a permanência dos usuários ao longo do tempo. Neste exemplo, o modelo fornece uma maneira simples de relacionar o comportamento observado nas semanas anteriores com a probabilidade de abandono nas semanas seguintes.
Há mais de uma maneira de definir retenção. Se consideramos retido todo usuário que ainda não atingiu \(B\), então a retenção até o terceiro passo é
Se quisermos medir apenas a probabilidade de o usuário estar ativo ou pouco ativo exatamente no terceiro passo, obtemos
As duas quantidades respondem a perguntas diferentes: a primeira mede a permanência no serviço, enquanto a segunda mede a presença de alguma atividade no período considerado.
Se uma linha não contém transições observadas, sua distribuição não é identificada pelos dados: não podemos dividir por zero nem concluir que o estado seja absorvente. Uma suavização simples, para \(d_i\) destinos admissíveis, substitui as proporções por
nesses destinos, conservando os zeros estruturais. Ela evita previsões nulas baseadas em poucas observações, mas acrescenta uma escolha ao modelo; já não é o estimador de máxima verossimilhança sem restrições adicionais.
A hipótese de Markov merece uma verificação concreta: entre usuários no mesmo estado atual, compare a próxima semana segundo o estado da semana anterior. Diferenças persistentes sugerem que o estado resume mal o histórico. Para examinar homogeneidade, estime matrizes em períodos separados e compare as previsões em semanas posteriores, inclusive a fração de contas encerradas. Campanhas, mudanças no produto e diferenças entre coortes podem invalidar uma única matriz fixa. As probabilidades calculadas acima são previsões ajustadas; não incorporam a incerteza da estimação e não medem o efeito causal de uma intervenção de retenção.
2.3 Modelos ocultos de Markov*
Como acompanhar o engajamento de alguém quando só observamos suas ações? Um clique é um dado; estar engajado é uma interpretação sobre um estado que não vemos diretamente. Um usuário engajado pode passar um dia sem clicar, e um usuário pouco engajado pode clicar por acaso. Há, portanto, duas camadas: um estado que evolui e uma observação imperfeita desse estado.
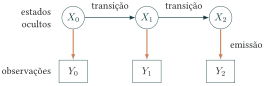
A palavra “oculto” é importante. Se observássemos \(X_n\), bastaria usar a matriz \(P\) para prever o próximo estado. Como vemos apenas \(Y_n\), não sabemos com certeza onde a cadeia está. Em vez de um estado, precisamos carregar uma distribuição sobre os estados possíveis.
A descrição acima determina a lei conjunta. Escrevendo \(x_{0:n}=(x_0,\ldots ,x_n)\) e analogamente \(y_{0:n}\),
Cada fator tem uma função: começar, transitar e emitir. Essa fatoração permite formular vários problemas diferentes. Aqui vamos perseguir apenas um deles, porque ele contém a ideia central que queremos compreender.
O problema de filtragem é o seguinte: depois de observar \(Y_0,\ldots ,Y_n\), qual é a nossa distribuição para o estado atual \(X_n\)? Definimos
Quando chega uma nova observação, a atualização ocorre em dois movimentos. Primeiro deixamos a cadeia evoluir, sem ainda olhar o novo dado. Depois usamos o novo dado para corrigir a previsão:
É útil separar esses dois passos. O primeiro combina as transições da cadeia com a hipótese de que cada emissão depende apenas do estado oculto do mesmo instante; o segundo usa a regra de Bayes para incorporar a nova observação.
Comecemos pela previsão. Condicionamos segundo o estado atual:
A propriedade de Markov descreve a relação entre os estados ocultos. Para condicionar também pelas observações, precisamos usar a hipótese de emissão. Na fatoração da lei conjunta, somar sobre os estados anteriores a \(X_n=i\) deixa o fator \(p_{ij}\) fora da soma: ele não depende desses estados nem das observações já realizadas. Assim,
Quando o evento condicionado tem probabilidade positiva, a divisão mostra que o primeiro fator da soma anterior é \(p_{ij}\); o segundo é \(r_n(i)\). Estados com \(r_n(i)=0\) não contribuem para a soma. Obtemos, portanto,
Agora chega a observação \(Y_{n+1}=y_{n+1}\). Pela regra de Bayes,
A hipótese de emissão transforma o primeiro fator do numerador em \(b_j(y_{n+1})\). Para obter o denominador, somamos o numerador sobre todos os estados possíveis. Surge exatamente
A fórmula para \(r_0\) é o mesmo argumento de Bayes aplicado à primeira observação.
A interpretação é tão importante quanto as fórmulas. A multiplicação por \(P\) faz a previsão: mesmo sem receber informação nova, nossa crença sobre o estado muda porque o próprio sistema evolui. A multiplicação por \(b_j(y_{n+1})\) faz a correção: estados que explicam melhor a observação recebem mais peso. A normalização final apenas faz esses novos pesos somarem um.
Há ainda uma economia de informação importante. Toda a história \(y_0,\ldots ,y_n\) influencia o futuro através de \(r_n\). Depois de calcular essa distribuição, não precisamos refazer os cálculos desde o início quando chega o próximo dado. O vetor \(r_n\) é o nosso estado de conhecimento sobre a cadeia oculta. Essa recursão é frequentemente chamada de algoritmo forward.
Tome \(X_n\in \{ E,D\} \), onde \(E\) significa engajado e \(D\), desengajado, e \(Y_n\in \{ C,S\} \), onde \(C\) significa clique e \(S\), silêncio no dia. Suponha
Vamos acompanhar a sequência de observações
Antes de qualquer observação, atribuímos probabilidades iguais aos dois estados. O primeiro dado é um clique. Como um clique é muito mais provável em \(E\) do que em \(D\), Bayes produz
Assim, depois do clique, a probabilidade de engajamento é aproximadamente \(0{,}818\).
No dia seguinte, antes de observar qualquer ação, fazemos a previsão:
A probabilidade prevista de engajamento é agora aproximadamente \(0{,}709\). Ela mudou mesmo antes de chegar um novo dado: o estado oculto também pode ter mudado.
Observamos então silêncio. Sob \(E\), essa observação tem probabilidade \(0{,}1\); sob \(D\), probabilidade \(0{,}8\). Multiplicamos a previsão por esses dois pesos:
Normalizando,
A probabilidade de engajamento cai para aproximadamente \(0{,}234\). Ela não cai a zero: silêncio é evidência contra engajamento, não uma observação direta do estado.
Façamos mais um passo. Antes da terceira observação,
A probabilidade prevista de engajamento sobe para aproximadamente \(0{,}417\), pois a matriz permite que um usuário desengajado volte a se engajar. Agora observamos um clique. A correção dá
A probabilidade de engajamento volta a aproximadamente \(0{,}763\).
O percurso completo pode ser lido assim:
A cadeia move a crença entre observações; cada nova ação a corrige. Essa é a ideia que a filtragem repete, passo após passo.
Em uma cadeia observada, registramos o próprio \(X_n\). No HMM, registramos \(Y_n\) e mantemos uma distribuição sobre \(X_n\). Por isso, \((Y_n)\) em geral não é uma cadeia de Markov: saber apenas a última observação pode perder informação que as observações anteriores forneceram sobre o estado oculto.
Para ir além. A filtragem é apenas uma das perguntas possíveis em modelos ocultos de Markov. Podemos usar observações futuras para rever o que acreditávamos sobre estados passados (smoothing), procurar uma trajetória oculta particularmente plausível (problema associado ao algoritmo de Viterbi) ou estimar a matriz de transição e as probabilidades de emissão a partir dos próprios dados, por exemplo com o algoritmo de Baum–Welch. Não desenvolveremos esses temas aqui. Para continuar, uma introdução clássica e muito acessível é Rabiner (1989); para uma apresentação moderna, com numerosos exemplos de séries temporais, veja Zucchini et al. (2016).
2.4 Classificação dos estados
De volta às cadeias em que o estado é observado, surgem duas perguntas diferentes: quando a cadeia visita \(y\) pela primeira vez e quando volta a \(y\) depois do instante inicial. Se começamos em \(y\), a entrada já ocorreu, mas o retorno ainda está por acontecer.
Tempo de parada Uma variável aleatória \(T\) com valores em \(\{ 0,1,2,\ldots \} \cup \{ \infty \} \) é um tempo de parada para a informação gerada pela cadeia se, para cada \(n\), é possível decidir se \(T=n\) observando somente \(X_0,\ldots ,X_n\). Por exemplo, para \(n\geq 1\),
logo \(T_{y}^{+}\) é um tempo de parada.
O ponto essencial é que a regra não pode consultar o futuro. O primeiro instante em que a cadeia entra em \(y\) é um tempo de parada; o último instante em que ela visita \(y\), em geral, não é, pois no instante atual ainda não sabemos se haverá outra visita.
A propriedade forte de Markov diz que a cadeia pode ser reiniciada em um tempo de parada: dali em diante, importa o estado em que ela parou, e não o caminho usado para chegar até ele.
Podemos reiniciar a cadeia quando uma condição observável ocorre. A hipótese de parada é essencial: escolher o instante usando acontecimentos futuros poderia favorecer trajetórias que satisfazem essa escolha.
Fixe \(r\geq 1\), estados \(z_1,\ldots ,z_r\) e um evento \(A\) determinado pelo caminho observado até \(T\), no sentido de que, para cada \(n\), o evento \(A\cap \{ T=n\} \) é determinado por \(X_0,\ldots ,X_n\). O argumento tem três passos.
1. Fixar o valor da parada. No evento \(\{ T=n\} \), a regra que determina a parada já pode ser decidida com a informação disponível até o instante \(n\). Assim,
é um evento determinado por \(X_0,\ldots ,X_n\). O instante aleatório foi, portanto, reduzido a um instante determinístico.
2. Aplicar a propriedade de Markov em \(n\). Pela propriedade de Markov usual, o bloco futuro depende do passado somente pelo estado \(X_n=y\). Logo,
O segundo fator é exatamente a probabilidade de a cadeia iniciada em \(y\) seguir o caminho \(y,z_1,\ldots ,z_r\); em particular, ele não depende de \(A\) nem de \(n\).
3. Somar sobre os valores possíveis de \(T\). Somando a identidade anterior em \(n\) e usando que os eventos \(\{ T=n\} \) são disjuntos, obtemos
Quando a probabilidade condicionante é positiva, a divisão mostra que a lei do futuro, dado \(X_T=y\), não depende do caminho observado até \(T\). Como as probabilidades de blocos finitos determinam a lei da trajetória futura, obtemos a propriedade forte de Markov.
Defina \(T_y^{(1)}=T_{y}^{+}\) e, recursivamente,
Pela propriedade forte de Markov, após cada retorno a cadeia recomeça em \(y\) sob a lei \(\mathbb {P}_y\). Portanto,
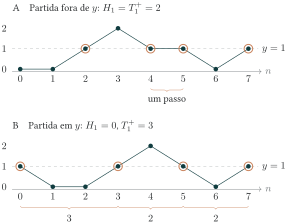
Estados recorrentes e transientes Um estado \(y\) é recorrente se \(\rho _{yy}=1\); nesse caso, a cadeia iniciada em \(y\) retorna a \(y\) infinitas vezes com probabilidade \(1\). O estado é transiente se \(\rho _{yy}\lt 1\); nesse caso, o número de visitas a \(y\) é finito com probabilidade \(1\).
Assim, recorrência não significa “permanecer perto” de \(y\): a cadeia pode fazer excursões arbitrariamente longas, desde que volte com probabilidade um. Transiência significa que existe uma probabilidade positiva de partir e nunca mais retornar.
A diferença aparece já na ruína do jogador: os estados absorventes são recorrentes, enquanto os estados internos são transientes.
No jogo do Exemplo 2.2 com \(N=5\), os estados 0 e 5 são absorventes e, portanto, recorrentes. Os estados internos são transientes. De fato, a partir de cada um deles existe um caminho de probabilidade positiva até uma barreira absorvente sem retornar ao ponto de partida:
Por exemplo,
O mesmo argumento vale para 1, 3 e 4. Assim, cada estado interno tem probabilidade positiva de nunca retornar.
Passamos agora a resultados gerais que ajudam a identificar estados transientes e recorrentes.
Acessibilidade e comunicação Duas noções do grafo de transições serão usadas repetidamente. A primeira é orientada: pergunta se existe algum caminho possível de \(x\) até \(y\). A segunda exige caminhos nos dois sentidos.
Dizemos que \(y\) é acessível a partir de \(x\), e escrevemos \(x\to y\), se
Equivalentemente, \(x\to y\) se e somente se \(P^m(x,y)\gt 0\) para algum \(m\geq 0\): atingir \(y\) em tempo finito com probabilidade positiva equivale à existência de um caminho finito de probabilidade positiva. Usaremos as duas formulações indistintamente.
Dizemos que \(x\) e \(y\) se comunicam, e escrevemos \(x\leftrightarrow y\), se \(x\to y\) e \(y\to x\). As classes de equivalência dessa relação são as classes de comunicação da cadeia.
Transitividade da acessibilidade Se \(x\to y\) e \(y\to z\), então \(x\to z\).
Existem \(m,n\) tais que \(P^{m}(x,y)\gt 0\) e \(P^{n}(y,z)\gt 0\). Por Chapman–Kolmogorov,
Um caminho sem retorno Se \(\rho _{xy}\gt 0\) e \(\rho _{yx}\lt 1\), então \(x\) é transiente.
Se \(x=y\), a hipótese \(\rho _{xx}\lt 1\) já afirma que \(x\) é transiente. Suponha, portanto, \(x\ne y\). Seja \(K\) o menor número de passos de um caminho com probabilidade positiva de \(x\) até \(y\). Existe uma sequência \(y_1,\ldots ,y_{K-1}\) tal que
Pela minimalidade, esse caminho não volta a \(x\) antes de atingir \(y\). Depois de chegar a \(y\), há probabilidade \(1-\rho _{yx}\gt 0\) de nunca atingir \(x\). Logo,
e \(x\) é transiente.
Uma consequência imediata é a seguinte.
Retorno a partir de estados alcançáveis Se \(x\) é recorrente e \(\rho _{xy}\gt 0\), então \(\rho _{yx}=1\).
Se \(\rho _{y x}\lt 1\), então o Teorema 2.6 implicaria que \(x\) é transiente, uma contradição.
Conjuntos fechados e irredutibilidade Um conjunto \(A\subseteq S\) é fechado se não é possível sair dele:
Um conjunto \(B\subseteq S\) é irredutível se quaisquer dois estados de \(B\) se comunicam. A cadeia é irredutível quando o próprio espaço \(S\) é irredutível.
Um conjunto fechado é uma região da qual a cadeia não sai. A irredutibilidade significa que cada estado pode ser alcançado a partir de qualquer outro. Na definição de um subconjunto \(B\), os caminhos são considerados na cadeia original; quando \(B\) também é fechado, esses caminhos permanecem em \(B\). Em uma cadeia finita, a trajetória entra em alguma classe fechada em tempo finito, com probabilidade um, e permanece nela.
O exemplo seguinte mostra como o grafo de transições revela as classes fechadas e, com elas, a decomposição entre estados recorrentes e transientes.
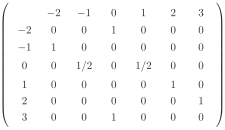
Considere a matriz de transição:
Desenhe uma seta de \(i\) para \(j\) quando \(p(i,j)\gt 0\) e \(i\ne j\). Os laços correspondentes a \(p(i,i)\gt 0\) foram omitidos: eles não alteram quais estados são alcançáveis, embora sejam relevantes para a periodicidade.
A Figura 2.9 destaca as duas classes fechadas.
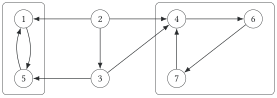
O estado 2 alcança 1, mas 1 não alcança 2; pelo Teorema 2.6, o estado 2 é transiente. Do mesmo modo, 3 alcança 4, mas 4 não alcança 3, e portanto 3 é transiente.
As classes \(\{ 1,5\} \) e \(\{ 4,6,7\} \) são fechadas e irredutíveis. Há conjuntos fechados maiores — por exemplo, a união \(\{ 1,4,5,6,7\} \) e o espaço inteiro —, mas são as classes fechadas que determinam os estados recorrentes. O próximo resultado torna essa afirmação precisa.
Para controlar retornos e contar visitas, usaremos dois fatos sobre séries e probabilidades. Recordá-los agora permite justificar os limites seguintes diretamente por somas finitas.
De fato, para um número finito de linhas, as somas dessas linhas são aproximadas simultaneamente por retângulos suficientemente grandes. Além disso, qualquer conjunto finito de pares de índices cabe em algum retângulo. As duas ordens de soma têm, portanto, o mesmo supremo de somas finitas. Esse argumento também justifica reagrupar termos não negativos por diagonais ou por outros conjuntos disjuntos de índices.
Para verificar a afirmação sobre eventos crescentes, escreva \(D_1=A_1\) e \(D_m=A_m\setminus A_{m-1}\) para \(m\geq 2\). Esses eventos são disjuntos, e a aditividade enumerável dá
Aplicando essa identidade aos complementares, obtemos também a continuidade para eventos decrescentes. Os eventos \(\{ T\gt n\} \) decrescem para \(\{ T=\infty \} \), que tem probabilidade zero quando \(T\lt \infty \) quase certamente.
Se \(\mathbb {P}(Z=+\infty )\gt 0\), a esperança é infinita e cada termo da primeira série é pelo menos essa probabilidade. A identidade vale nesse caso.
Suponha agora \(\mathbb {P}(Z=+\infty )=0\) e escreva \(p_j=\mathbb {P}(Z=j)\). Pela definição de esperança de uma variável discreta, \(E Z=\sum _{j\geq 1}j p_j\). Para cada \(M\), uma soma finita dá
Tomando o supremo em \(M\), obtemos uma das desigualdades. Na direção oposta, para cada \(K\), particionamos os resultados em \(Z=1,\ldots ,K-1\) e \(Z\geq K\):
Tomar o supremo em \(K\) fornece a desigualdade restante. A segunda série do enunciado é a primeira com o índice deslocado, pois \(Z\) assume valores inteiros.
Para uso posterior, observe ainda a identidade finita
Ela mostra exatamente como cada nível alcançado por \(Z\) contribui uma unidade para a esperança truncada.
No evento \(\{ T_y^+\gt nk\} \), a cadeia ainda não visitou \(y\) em tempo positivo até \(nk\). Como \(D\) é fechado, o estado atual continua em \(D\). Pela propriedade de Markov no instante \(nk\), a probabilidade de não visitar \(y\) durante os próximos \(k\) passos é, portanto, no máximo \(1-\alpha \). Assim,
A desigualdade desejada segue por indução.
Dentro de uma classe finita sem saída, sempre há uma nova oportunidade de voltar. Como há apenas um número finito de estados de partida, podemos encontrar um mesmo número de passos e uma mesma probabilidade positiva de retorno válidos para todos eles. Em particular, os estados \(1,5,4,6,7\) do exemplo anterior são recorrentes.
Fixe \(y\in C\). Para cada \(x\in C\), escolha um caminho de probabilidade positiva que visite \(y\) em tempo positivo; para \(x=y\), use um caminho de retorno. Se \(C=\{ y\} \), o próprio laço tem probabilidade um. Como \(C\) é finito, existem \(k\geq 1\) e \(\alpha \gt 0\) tais que \(\mathbb {P}_x(T_y^+\leq k)\geq \alpha \) para todo \(x\in C\). A cadeia não sai de \(C\), e o Lema 2.10 dá
Pela fórmula da cauda do Lema 2.9, agrupando os instantes em blocos de \(k\) passos,
Em particular, o retorno ocorre quase certamente. A terminologia de recorrência positiva será formalizada junto dos resultados de frequência.
Em uma cadeia finita, as classes fechadas dão todas as regiões recorrentes. O próximo resultado organiza a classificação.
Decomposição de uma cadeia finita Se \(S\) é finito e não vazio, ele se decompõe na união disjunta \(\mathcal T\cup R_1\cup \cdots \cup R_k\), onde \(\mathcal T\) contém os estados transientes e cada \(R_i\) é uma classe fechada de estados recorrentes.
Pense no grafo dirigido da cadeia: desenhamos uma seta \(i\to j\) sempre que \(p(i,j)\gt 0\). A relação \(x\rightarrow y\) significa exatamente que existe um caminho dirigido de \(x\) até \(y\) nesse grafo.
Seja \(\mathcal T\) o conjunto dos estados \(x\) que alcançam algum \(y\) sem poderem ser alcançados de volta por ele. Pelo Teorema 2.6, esses estados são transientes. Vamos classificar os estados restantes.
Primeiro, existe uma classe fechada. Para ver isso, reúna em um único vértice os estados de cada classe de comunicação e mantenha as setas entre classes distintas. Esse novo grafo não pode ter um circuito: as classes de um circuito se comunicariam e seriam, na verdade, uma só. Como o número de classes é finito e positivo, seguir setas entre classes precisa terminar numa classe sem saída. Ela é fechada, e seus estados não pertencem a \(\mathcal T\), pois todos os estados que alcançam estão nessa mesma classe. Logo, \(S\setminus \mathcal T\) é não vazio.
Escolha \(x\in S\setminus \mathcal T\) e seja \(C_x=\{ y:x\rightarrow y\} \). No grafo, \(C_x\) reúne todos os vértices alcançáveis a partir de \(x\). Como \(x\notin \mathcal T\), se \(x\rightarrow y\), então \(y\rightarrow x\): fora de \(\mathcal T\), todo caminho que sai de \(x\) pode ser completado por um caminho de volta. Assim, todos os vértices de \(C_x\) pertencem à mesma classe de comunicação. Para verificar que \(C_x\) é fechado, observe que, se \(y\in C_x\) e \(y\rightarrow z\), então o Lema 2.5 implica \(x\rightarrow z\) e, portanto, \(z\in C_x\). Para verificar a irredutibilidade, suponha \(y,z\in C_x\). Pela observação anterior, \(y\rightarrow x\) e, por definição, \(x\rightarrow z\); logo, o Lema 2.5 implica \(y\rightarrow z\). Assim, \(C_x\) é fechado e irredutível, e todos os seus estados são recorrentes. Seja \(R_1=C_x\). Se \(S\setminus (\mathcal T\cup R_1)=\varnothing \), terminamos. Caso contrário, escolha um estado \(w\in S\setminus (\mathcal T\cup R_1)\) e repita o procedimento. A nova classe \(C_w\) é disjunta de \(R_1\): se \(z\in C_w\cap R_1\), então \(w\to z\) e, como \(w\notin \mathcal T\), também \(z\to w\); como \(x\to z\), segue que \(x\to w\) e, portanto, \(w\in R_1\), uma contradição. O mesmo argumento mostra que cada nova classe é disjunta das anteriores. Como \(S\) é finito, o procedimento termina após um número finito de etapas.
O próximo lema também será útil em espaços enumeráveis. Sua prova virá depois do cálculo do número esperado de visitas, que permite reunir os argumentos.
Para prová-lo, retomamos os tempos de retorno sucessivos definidos em (2.3). A propriedade forte de Markov fornece
Seja \(N(y)\) o número de visitas a \(y\) nos instantes \(n\geq 1\). A identidade acima permite calcular \(E_xN(y)\).
Número esperado de visitas Vale
Aplicaremos a fórmula da cauda do Lema 2.9 à contagem \(N(y)\), que pode ser infinita. Para cada \(k\geq 1\),
Usando (2.5), obtemos
Se \(\rho _{xy}=0\), cada parcela é zero. Se \(\rho _{xy}\gt 0\) e \(\rho _{yy}\lt 1\), a série geométrica vale \(\rho _{xy}/(1-\rho _{yy})\). Se \(\rho _{xy}\gt 0\) e \(\rho _{yy}=1\), todas as parcelas valem \(\rho _{xy}\) e a soma é infinita.
Visitas e probabilidades de transição O número esperado de visitas também satisfaz
Conte primeiro as visitas até um instante fixo:
A linearidade da esperança de uma soma finita dá
Escreva
Como \(N_m(y)\leq N(y)\), as probabilidades das caudas de \(N_m(y)\) são menores ou iguais às de \(N(y)\). A fórmula da cauda implica \(E_xN_m(y)\leq E_xN(y)\) e, portanto, \(L\leq E_xN(y)\).
Para a desigualdade inversa, fixe um número \(K\) de visitas. Para todo \(m\),
Para cada \(k\) fixo, os eventos \(\{ N_m(y)\geq k\} \) crescem, quando \(m\) aumenta, para \(\{ N(y)\geq k\} \): se houve pelo menos \(k\) visitas, todas elas já ocorreram até algum instante finito. Pela continuidade das probabilidades recordada na Proposição 2.8, podemos passar ao limite nessa soma de apenas \(K\) termos e obter
Agora tomamos o supremo em \(K\). A fórmula da cauda dá \(E_xN(y)\leq L\) e conclui a prova. O argumento cobre também o caso de esperança infinita.
Critério de recorrência Um estado \(y\) é recorrente se, e somente se,
Se \(x=y\), nada há a provar. Caso contrário, o Lema 2.7 garante que \(y\) alcança \(x\). Escolha \(j,\ell \) com \(P^{j}(y,x)\gt 0\) e \(P^{\ell }(x,y)\gt 0\). Então
Se \(x\) é recorrente, o lado direito é infinito; logo \(y\) também é recorrente.
2.5 Passeios aleatórios em \(\mathbb Z^d\)
O critério de recorrência do Teorema 2.16 ganha uma interpretação concreta para passeios aleatórios: basta estimar a probabilidade de o passeio estar novamente na origem após \(n\) passos.
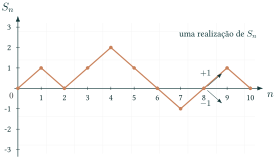
A cada passo, a soma das coordenadas muda de paridade. Para voltar à origem, essa soma precisa ser novamente par; portanto, o retorno só pode ocorrer em instantes pares. Essa alternância é o que torna o grafo \(\mathbb Z^d\) bipartido. As estimativas a seguir usam a fórmula de Stirling,
Recorrência em \(\mathbb Z\) O passeio simples e simétrico em \(\mathbb Z\) é recorrente. Mais geralmente, se um passo vale \(+1\) com probabilidade \(p\) e \(-1\) com probabilidade \(q=1-p\), o passeio é recorrente se e somente se \(p=q=1/2\).
Se \(p=0\) ou \(p=1\), o passeio se move sempre no mesmo sentido e nunca retorna à origem. Suponha, portanto, \(0\lt p\lt 1\). Para retornar à origem no instante \(2n\), são necessários exatamente \(n\) passos para a direita e \(n\) para a esquerda. Logo,
Por Stirling,
Se \(p=q=1/2\), a série das probabilidades de retorno se comporta como \(\sum _n n^{-1/2}\) e diverge. Se \(p\neq q\), então \(4pq\lt 1\) e a série converge por comparação com uma série geométrica. O critério do Teorema 2.16 conclui a prova.
Identidade de Vandermonde Para todo \(n\geq 0\),
No produto \((1+x)^n(1+x)^n=(1+x)^{2n}\), o coeficiente de \(x^n\) é, de um lado, \(\sum _{k=0}^n\binom nk\binom n{n-k}\) e, do outro, \(\binom {2n}{n}\).
Recorrência em \(\mathbb Z^2\) O passeio aleatório simples e simétrico em \(\mathbb Z^2\) é recorrente.
Em um caminho fechado com \(2n\) passos, suponha que haja \(k\) passos para a direita e \(k\) para a esquerda. Restam \(n-k\) passos para cima e \(n-k\) para baixo. Portanto, o número de caminhos fechados é
Como cada sequência de \(2n\) passos tem probabilidade \(4^{-2n}\),
A série harmônica diverge; pelo Teorema 2.16, a origem é recorrente. A invariância por translação dá a recorrência de todos os estados.
Transiência em \(\mathbb Z^3\) O passeio aleatório simples e simétrico em \(\mathbb Z^3\) é transiente.
Para um retorno em \(2n\) passos, sejam \(i,j,k\) os números de passos positivos em cada uma das três coordenadas. Deve haver o mesmo número de passos negativos em cada coordenada e \(i+j+k=n\). Assim,
Escreva
Os números \(a_{i,j,k}\) formam a distribuição multinomial de \(n\) ensaios com três categorias equiprováveis; em particular, \(\sum a_{i,j,k}=1\). Reagrupando a expressão anterior,
O máximo ocorre quando \(i,j,k\) diferem entre si por no máximo uma unidade. De fato, se \(i\geq j+2\), trocar \((i,j,k)\) por \((i-1,j+1,k)\) multiplica \(a_{i,j,k}\) por \(i/(j+1)\gt 1\). Repetindo esse ajuste, chegamos a índices tão próximos quanto possível. Nesses índices, a fórmula de Stirling dá \(a_{i,j,k}\) de ordem \(1/n\). Junto da estimativa do coeficiente binomial central, obtemos constantes \(C_1,C_2\gt 0\) tais que
Consequentemente,
A série \(\sum _n n^{-3/2}\) converge. Pelo Teorema 2.16, a origem é transiente.
Transiência em dimensões maiores O passeio aleatório simples e simétrico em \(\mathbb Z^d\) é transiente para todo \(d\geq 3\).
Para \(d\gt 3\), projete o passeio nas três primeiras coordenadas. A projeção fica parada quando o passo ocorre numa das demais coordenadas. Se a observarmos apenas nos instantes em que ela se move, obtemos o passeio simples em \(\mathbb Z^3\); esse processo é a cadeia de saltos da projeção.
O tempo de espera até cada movimento tem distribuição geométrica com parâmetro \(3/d\gt 0\) e é finito quase certamente. A cadeia de saltos visita a origem apenas um número finito de vezes e cada permanência dura um número finito de instantes; logo, a projeção está na origem em apenas um número finito de instantes. Toda visita do passeio original à origem exige que a projeção esteja na origem. Portanto, o passeio em \(\mathbb Z^d\) é transiente.
Classificar estados responde se certos retornos ocorrem. Em muitas aplicações, porém, a pergunta é mais local: antes de escapar de uma região, por qual parte da fronteira a cadeia sairá?
2.6 Distribuições de saída
Se \(A\subseteq S\), definimos o tempo de entrada em \(A\) por
Se \(A\) e \(B\) são disjuntos, podemos acompanhar a cadeia enquanto ela permanece em \(C=S\setminus (A\cup B)\) e perguntar: ao sair de \(C\), ela entra primeiro em \(A\) ou em \(B\)?
Problema de Dirichlet para cadeias de Markov Sejam \(A,B\subseteq S\) disjuntos e suponha que \(C=S\setminus (A\cup B)\) seja finito. Admita que \(H_A\wedge H_B\lt \infty \) quase certamente a partir de todo estado de \(C\). Então
é a única função que satisfaz
As condições na fronteira são imediatas. Para \(x\in C\), condicionando pelo primeiro passo e usando a propriedade de Markov,
Para a unicidade, se \(u\) é outra solução e \(T=H_A\wedge H_B\), iteração da equação harmônica fornece
Como \(u\) vale \(1\) em \(A\), \(0\) em \(B\) e \(C\) é finito, existe \(M\lt \infty \) tal que \(|u(z)|\leq M\) para todo estado \(z\). Nos resultados em que \(T\leq n\), temos \(u(X_{T\wedge n})=u(X_T)\); nos demais, a diferença em valor absoluto é no máximo \(2M\). Portanto,
A última passagem usa apenas \(T\lt \infty \) quase certamente e a continuidade das probabilidades de eventos decrescentes. Logo, \(u(x)=E_x[u(X_T)]=\mathbb {P}_x(H_A\lt H_B)\), como queríamos.
O adjetivo harmônica descreve a terceira equação: em cada estado interior, o valor de \(h\) é a média dos valores depois de um passo. Se \(R\) é a submatriz de \(P\) com linhas e colunas em \(C\) e
então as equações interiores podem ser escritas como
No jogo justo, a chance de atingir a meta é a proporção do capital inicial em relação a ela, e não necessariamente \(1/2\). Quando há deriva, as diferenças sucessivas dessa chance formam uma progressão geométrica.
De qualquer estado interior, uma sequência de \(N\) perdas leva a uma barreira com probabilidade pelo menos \(q^N\gt 0\). Em blocos de \(N\) passos,
Assim, a absorção ocorre quase certamente e tem esperança finita. Pelo problema de Dirichlet,
Pondo \(d_i=u_i-u_{i-1}\), obtemos \(pd_{i+1}=qd_i\). Se \(p=q\), as diferenças são constantes e as condições de fronteira dão \(u_i=i/N\). Se \(p\ne q\), então \(d_i=d_1(q/p)^{i-1}\); somar de \(1\) a \(i\) e impor \(u_N=1\) fornece a fórmula. Como a saída é quase certa e só há duas barreiras, as duas probabilidades somam um.
2.7 Tempos de saída
Probabilidades de saída resolvem um problema de fronteira harmônico. Tempos esperados de saída resolvem uma equação quase igual, mas com um termo \(1\): cada passo realizado acrescenta uma unidade de tempo.
Equação de Poisson para o tempo de saída Seja \(A\subseteq S\), suponha que \(C=S\setminus A\) seja finito e que \(H_A\lt \infty \) quase certamente a partir de todo \(x\in C\). Então
é a única solução de
Se \(C\) é vazio, a afirmação é imediata. Caso contrário, provemos primeiro que a esperança é finita. Para cada \(x\in C\), a hipótese de chegada quase certa permite escolher \(k_x\) com \(\mathbb {P}_x(H_A\leq k_x)\gt 1/2\). A finitude de \(C\) dá um único \(k\geq 1\) válido para todos os estados. Aplicando Markov em blocos, \(\mathbb {P}_x(H_A\gt jk)\leq 2^{-j}\). Pela fórmula da cauda,
Condicionando pelo primeiro passo, \(E_xH_A=1+\sum _yp(x,y)E_yH_A\) em \(C\), e a esperança é zero em \(A\). Se \(u\) é outra solução real das equações, a iteração do primeiro passo dá
Como \(u=0\) em \(A\) e \(C\) é finito, existe \(M\lt \infty \) tal que \(|u|\leq M\). O último termo só pode contribuir nos resultados em que a cadeia ainda não atingiu \(A\) até o instante \(n\). Assim,
Para o primeiro termo, a identidade de caudas truncadas fornece
Trata-se do limite das somas parciais de uma série numérica não negativa, cuja soma já sabemos ser finita. Logo \(u(x)=E_xH_A\), provando a unicidade.
Em forma matricial,
A estimativa geométrica usada na prova implica \(R^n\to 0\). Portanto, a matriz
é chamada de matriz fundamental. Sua entrada \((x,y)\) é o número esperado de visitas a \(y\) nos instantes \(0,1,\ldots ,H_A-1\), quando a cadeia começa em \(x\in C\). Essa contagem inclui a visita inicial, se \(x=y\), e exclui o instante de chegada à fronteira. Somar a linha correspondente a \(x\) fornece o tempo esperado \(E_xH_A\).
Dobrar o capital inicial e a meta no jogo justo conserva a chance de sucesso, mas multiplica a duração média por quatro. No caso com deriva, a duração depende também da direção favorecida pelas apostas.
Já verificamos que a duração é integrável. Pela análise de primeiro passo,
Se \(p=q=1/2\), a segunda diferença é \(v_{i+1}-2v_i+v_{i-1}=-2\). Logo a solução tem forma \(-i^2+Ai+B\), e as fronteiras dão \(v_i=i(N-i)\).
Se \(p\ne q\), as soluções da equação homogênea têm forma \(A+B(q/p)^i\). Uma solução particular é \(-i/(p-q)\). Impor as duas fronteiras produz
A unicidade da equação de Poisson identifica essa solução com a esperança procurada.
No capítulo de martingais, obteremos essas probabilidades por uma segunda demonstração. A nova ferramenta conservará esperanças até a saída e evitará resolver novamente as equações de diferenças.
2.8 Distribuições estacionárias
Já sabemos acompanhar a distribuição da cadeia por vários passos. Uma pergunta diferente é saber se existe uma distribuição que a dinâmica preserve: se a cadeia começa com ela, sua lei permanece a mesma em todos os tempos. Pela fórmula da probabilidade total,
Escrevendo \(\mu _0(i)=\mathbb {P}(X_0=i)\), a última equação toma a forma
Em notação matricial, a distribuição no instante \(n\) é \(\mu _n=\mu _0P^n\). Usamos vetores-linha: a coordenada \(j\) de \(\mu _0P^n\) é justamente a soma em (2.6).
Considere o canal de comunicação do Exemplo 2.4 com \(a=0{,}4\), \(b=0{,}2\) e distribuição inicial \(\mu _0(0)=0{,}3\), \(\mu _0(1)=0{,}7\). Então
A cadeia pode ter várias classes fechadas, por isso a afirmação é de existência. Em um espaço infinito, a massa das distribuições pode escapar para estados cada vez mais distantes, e o argumento de compacidade abaixo deixa de valer.
Parta de uma distribuição qualquer \(\mu _0\). As distribuições nos instantes sucessivos são
e considere a média das \(n\) primeiras:
Cada \(a_n\) ainda é uma distribuição de probabilidade, pois é uma média de distribuições. Como o espaço de estados é finito, todas essas distribuições pertencem ao simplex
que é compacto. Logo existe uma subsequência \((a_{n_r})\) que converge para alguma distribuição \(\pi \).
Resta mostrar que esse limite é preservado por \(P\). Multiplicar a média por \(P\) apenas desloca a sequência em um passo:
Consequentemente, todos os termos intermediários se cancelam na diferença e
Ao longo da subsequência escolhida, \(a_{n_r}\to \pi \); como a multiplicação por \(P\) é contínua, \(a_{n_r}P\to \pi P\). A diferença entre esses dois limites é zero, portanto
Assim, \(\pi \) é uma distribuição estacionária.
2.9 Cálculo de distribuições estacionárias
2.9.1 Cadeias com dois estados
Considere uma cadeia em \(S=\{ 1,2\} \). Escrever
torna visíveis as duas probabilidades de mudança: \(a\) para ir de \(1\) a \(2\) e \(b\) para voltar de \(2\) a \(1\). Se \(a+b\gt 0\), a distribuição estacionária é
Como primeira verificação, no canal de comunicação do Exemplo 2.4, cuja ordem dos estados é \((0,1)\), com \(a=0{,}4\) e \(b=0{,}2\), obtemos \((1/3,2/3)\). A fórmula também pode ser lida como uma igualdade de fluxos:
Assim, a massa enviada de 1 para 2 é igual à massa enviada de 2 para 1. Algebricamente,
A fórmula (2.7) vale sempre que \(a+b\gt 0\), inclusive quando um dos estados é absorvente. Se \(a=b=0\), ambos os estados são absorventes e toda distribuição em \(\{ 1,2\} \) é estacionária.
2.9.2 Cadeias duplamente estocásticas
Matriz duplamente estocástica Uma matriz de transição \(P\) é duplamente estocástica quando, além de cada linha somar \(1\), cada coluna também soma \(1\):
As somas das linhas já fazem parte da definição de matriz de transição; a condição nova é a das colunas.
Distribuição uniforme Em um espaço com \(N\) estados, a distribuição uniforme, \(\pi (x)=1/N\), é estacionária se e somente se \(P\) é duplamente estocástica.
Se \(P\) é duplamente estocástica, então, para cada estado \(y\),
Logo, \(\pi P=\pi \). Reciprocamente, se a distribuição uniforme é estacionária, então a mesma igualdade mostra que as colunas de \(P\) somam \(1\).
O espaço de estados é \(\{ 0,1,\ldots ,L\} \), com \(L\geq 1\). Nos estados interiores, a cadeia vai para cada vizinho com probabilidade \(1/2\). Adotamos a seguinte reflexão nos extremos: uma tentativa de sair do intervalo é substituída por uma permanência. Assim, \(p(0,0)=p(0,1)=1/2\) e \(p(L,L-1)=p(L,L)=1/2\). Para \(L=4\), a matriz é
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 0{,}5 | 0{,}5 | 0 | 0 | 0 |
| 1 | 0{,}5 | 0 | 0{,}5 | 0 | 0 |
| 2 | 0 | 0{,}5 | 0 | 0{,}5 | 0 |
| 3 | 0 | 0 | 0{,}5 | 0 | 0{,}5 |
| 4 | 0 | 0 | 0 | 0{,}5 | 0{,}5 |
Cada coluna soma \(1\), e o mesmo argumento vale para qualquer \(L\). Portanto, a distribuição estacionária é uniforme:
2.10 Reversibilidade e balanço detalhado
A estacionariedade equilibra o fluxo total que entra e sai de cada estado. O balanço detalhado impõe uma condição mais forte: o equilíbrio deve ocorrer separadamente em cada par de estados.
Balanço detalhado e reversibilidade Uma distribuição \(\pi \) satisfaz o balanço detalhado para \(P\) se
Quando existe tal distribuição, dizemos que a cadeia é reversível em relação a \(\pi \).
O produto \(\pi (x)p(x,y)\) é a probabilidade de observar a transição \(x\to y\) quando a cadeia começa com distribuição \(\pi \). A igualdade afirma que essa transição e a transição inversa têm a mesma probabilidade em equilíbrio.
Para verificar que o balanço detalhado implica estacionariedade, fixamos \(y\) e somamos em \(x\):
Na imagem da areia, o balanço detalhado diz que, para cada par \(x,y\), a massa enviada de \(x\) para \(y\) coincide com a massa enviada de \(y\) para \(x\). A estacionariedade permite compensações globais mais complexas; por isso, nem toda cadeia estacionária é reversível.
O exemplo seguinte mostra uma distribuição estacionária que não satisfaz o balanço detalhado.
Considere a matriz duplamente estocástica
A distribuição uniforme é estacionária, mas não satisfaz balanço detalhado: para ela, \(\pi (1)p(1,3)=0\), enquanto \(\pi (3)p(3,1)=1/15\gt 0\). Este exemplo mostra que uma distribuição estacionária não precisa satisfazer balanço detalhado.
Uma cadeia de nascimento e morte tem espaço de estados formado por inteiros consecutivos \(\ell ,\ell +1,\ldots ,r\), com \(r\) finito ou \(r=+\infty \), e só pode permanecer no lugar ou mover uma unidade:
Escrevemos
Adotamos \(q_\ell =0\) e, quando \(r\) é finito, \(p_r=0\). Supomos \(p_x,q_{x+1}\gt 0\) em cada aresta admissível e \(p_x+q_x\leq 1\). O balanço detalhado entre os vizinhos \(x\) e \(x+1\) exige
logo
Começando em \(\ell \) e aplicando a recursão repetidamente,
Depois, escolhemos \(\pi (\ell )\) para que a soma das probabilidades seja 1. Essa normalização só é possível, no caso infinito, quando a série dos pesos acima converge.
Neste modelo, o balanço detalhado também é necessário para a estacionariedade. De fato, suponha que \(\pi \) seja uma distribuição estacionária e fixe \(x\lt r\). O conjunto \(F=\{ \ell ,\ldots ,x\} \) é finito. Em um passo, a única saída de \(F\) ocorre pela transição \(x\to x+1\), e a única entrada ocorre pela transição inversa. Somando as equações de estacionariedade nos estados de \(F\), obtemos
Portanto, \(\pi (x)p_x=\pi (x+1)q_{x+1}\) para toda aresta admissível. Toda estacionária precisa, assim, ter os pesos calculados acima. Se a série desses pesos diverge, não existe distribuição estacionária; se converge, sua normalização fornece a única estacionária.
Considere primeiro o caso de três bolas. A matriz de transição é
Tomando \(\pi (0)=c\) e usando (2.8), obtemos
A soma é \(8c\), portanto \(c=1/8\) e
Os coeficientes \(1,3,3,1\) sugerem a resposta geral: para \(N\) bolas, a distribuição estacionária é binomial com parâmetros \(N\) e \(1/2\),
Para verificar o balanço detalhado,
Há também uma prova probabilística. Escolha inicialmente, de forma independente e equiprovável, a urna de cada bola. Todas as \(2^N\) configurações são igualmente prováveis. Trocar a urna de uma bola escolhida ao acaso apenas permuta essas configurações, de modo que a distribuição uniforme das configurações — e, portanto, a lei binomial de \(X_n\) — permanece inalterada.
Um vértice com mais vizinhos recebe mais massa no equilíbrio. A verificação não exige conectividade; esta será necessária para que uma única trajetória possa explorar todo o grafo.
Como \(A(u,v)=A(v,u)\), para qualquer constante \(c\gt 0\) os pesos \(cd(u)\) satisfazem
Cada aresta contribui duas unidades para a soma dos graus; logo \(\sum _ud(u)=2|E|\). Tomar \(c=1/(2|E|)\) normaliza os pesos e prova o balanço detalhado.
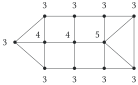
Os resultados das próximas seções mostrarão que, se o grafo for conexo, a cadeia é irredutível, a estacionária é única e suas massas são também as frequências temporais a partir de qualquer vértice. A convergência das distribuições exigirá ainda aperiodicidade.
2.10.1 Cadeia reversa
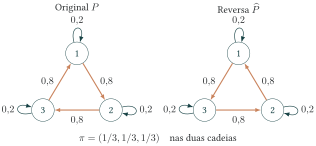
Suponha que a cadeia comece em equilíbrio, isto é, \(X_0\sim \pi \). Se gravarmos sua trajetória e exibirmos o filme ao contrário, obteremos novamente uma cadeia de Markov. A fórmula seguinte identifica suas probabilidades de transição.
Cadeia reversa Suponha que \(X_0\sim \pi \), onde \(\pi \) é estacionária, e fixe \(n\). O processo
é uma cadeia de Markov no suporte \(S_\pi =\{ i\in S:\pi (i)\gt 0\} \), cujas transições, para \(0\leq m\lt n\), são dadas pela matriz reversa
A cadeia em equilíbrio permanece em \(S_\pi \). Para verificar isso diretamente, se \(j\notin S_\pi \), a igualdade \(0=\pi (j)=\sum _i\pi (i)p(i,j)\) obriga \(p(i,j)=0\) para todo \(i\in S_\pi \), pois os termos da soma são não negativos. Assim, não há saída do suporte.
Fixe \(0\leq m\lt n\) e uma história de probabilidade positiva. Condicionar também pelos estados \(Y_{m-1},\ldots ,Y_0\) equivale, na trajetória original, a informar o futuro depois de \(X_{n-m}=i\). Pela propriedade de Markov, esse futuro depende do trecho anterior apenas por meio de \(i\) e se cancela na razão de probabilidades condicionais. Resta
Além disso,
pois \(\pi P=\pi \) e os termos com \(j\notin S_\pi \) teriam peso zero. Logo, \(\widehat P\) é de fato uma matriz de transição em \(S_\pi \). Se quisermos escrevê-la em todo \(S\), estendemos as linhas de \(S_\pi \) por zeros nas colunas fora do suporte e completamos as demais linhas com distribuições de probabilidade arbitrárias. A escolha dessas últimas linhas não afeta a cadeia em equilíbrio, que nunca visita os estados fora do suporte.
Se \(\pi \) satisfaz o balanço detalhado, então, para \(i,j\in S_\pi \),
Nesse caso, um filme da cadeia em equilíbrio tem a mesma lei quando exibido de trás para a frente. Essa é a razão para o nome reversível.
2.11 Comportamento limite
Encontrar uma distribuição estacionária é apenas metade da história. Queremos saber se a cadeia realmente se aproxima dela quando o tempo cresce — e que papel recorrência e periodicidade desempenham nessa aproximação.
Se \(y\) é transiente, os Lemas 2.14 e 2.15 dão \(\sum _{n=1}^{\infty } P^{n}(x, y)\lt \infty \) para qualquer estado inicial \(x\) e, consequentemente,
Assim, a probabilidade de cada estado transiente fixado tende a zero. Em um espaço infinito, isso não impede que toda a massa permaneça no conjunto dos estados transientes, deslocando-se para estados cada vez mais distantes. Para entender a convergência, concentramos a atenção em classes irredutíveis recorrentes. Ainda resta, porém, um obstáculo: a cadeia pode oscilar de maneira periódica.
Período e aperiodicidade Para um estado \(x\), considere o conjunto dos possíveis tempos de retorno
Quando \(I_x\) é não vazio, o período de \(x\) é o máximo divisor comum de seus elementos. Se \(I_x=\varnothing \), não há retorno possível e não atribuímos período ao estado. O estado é aperiódico quando seu período é \(1\).
O período não mede quanto tempo a cadeia costuma levar para voltar. Ele detecta um ritmo obrigatório: período \(d\gt 1\) significa que todo retorno só pode ocorrer em tempos múltiplos de \(d\).
Na cadeia de Ehrenfest, uma bola muda de urna a cada passo. Portanto, o número de bolas na urna esquerda troca de paridade em todos os instantes: de um estado par a cadeia vai para um estado ímpar, e vice-versa.
Consequentemente, um retorno ao estado inicial só pode ocorrer após um número par de passos. Por outro lado, de qualquer estado há probabilidade positiva de mover uma bola e devolvê-la no passo seguinte. Assim,
para todo estado \(x\). Como \(2\) é um tempo possível de retorno e todos os tempos de retorno são pares, o período é \(2\).
Considere a cadeia da Figura 2.13. A partir de 0, escolhemos com probabilidade \(1/2\) um circuito de comprimento 3 ou um circuito de comprimento 4; depois de escolhido o circuito, o percurso de volta a 0 é determinístico.
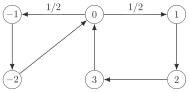
Temos \(P^{3}(0,0)\gt 0\) e \(P^{4}(0,0)\gt 0\). Como o máximo divisor comum de 3 e 4 é 1, o estado 0 é aperiódico, mesmo que \(p(0,0)=0\). O exemplo mostra que a existência de uma permanência é suficiente, mas não necessária, para aperiodicidade.
Períodos em uma classe Estados que se comunicam e admitem retorno em tempo positivo têm o mesmo período.
Escolha \(k,m\) tais que \(P^{k}(x,y)\gt 0\) e \(P^{m}(y,x)\gt 0\). Então
Logo, o período de \(x\) divide \(k+m\). Para qualquer \(\ell \in I_y\),
de modo que \(k+\ell +m\in I_x\). Subtraindo \(k+m\), concluímos que o período de \(x\) divide todo \(\ell \in I_y\); portanto, ele divide o período de \(y\). Trocando \(x\) e \(y\), obtemos a divisibilidade oposta. Os dois períodos são iguais.
Nesse caso, \(1\in I_x\), e o máximo divisor comum de um conjunto que contém \(1\) só pode ser \(1\).
No canal de comunicação do Exemplo 2.4, se \(0\lt a,b\lt 1\), ambos os estados possuem permanência positiva; portanto, a cadeia é aperiódica. Em uma cadeia irredutível, basta encontrar um único estado aperiódico, pois o Lema 2.27 transfere o período para toda a classe.
Chegamos agora aos principais resultados do capítulo. A distinção importante é entre a distribuição em um instante distante e a média calculada ao longo de uma única trajetória.
2.11.1 Frequências e tempo médio de retorno
Começaremos pelas médias ao longo de uma trajetória. Elas têm uma vantagem: não exigem aperiodicidade. Cada retorno ao mesmo estado encerra uma excursão e permite recomeçar com a mesma lei.
O inverso do intervalo médio entre visitas é a frequência de visitas. Se o intervalo tem média infinita, a cadeia ainda retorna infinitas vezes, mas os retornos ocupam uma fração assintótica nula do tempo. Não se trata de permanecer perto do estado.
Pela irredutibilidade e recorrência, \(H_y\lt \infty \) quase certamente, qualquer que seja o estado inicial. Ponha \(R_0=H_y\) e seja \(R_k\) o instante do \(k\)-ésimo retorno depois de \(R_0\). Pela propriedade forte de Markov, os intervalos \(L_k=R_k-R_{k-1}\), \(k\geq 1\), são independentes e identicamente distribuídos (i.i.d.), com a lei de \(T_y^+\) sob \(\mathbb {P}_y\).
Se \(a=E_yT_y^+\lt \infty \), a lei forte dos grandes números dá \(R_k/k\to a\). O número de retornos completos até \(n\) é o maior \(k\) para o qual \(R_k\leq n\). Das desigualdades \(R_k\leq n\lt R_{k+1}\), invertendo a razão, obtemos \(k/n\to 1/a\). A contagem \(N_n(y)\) difere dessa contagem em no máximo uma visita, o que não altera o limite.
Se \(E_yT_y^+=\infty \), aplicamos a lei forte às variáveis limitadas \(L_k\wedge b\). Para cada inteiro \(b\geq 1\),
Podemos tomar essas desigualdades simultaneamente para todos os inteiros \(b\geq 1\): a união enumerável dos eventos excepcionais ainda tem probabilidade zero. Pela fórmula da cauda do Lema 2.9,
As esperanças truncadas são, portanto, as somas parciais de uma série divergente de termos não negativos. Dado qualquer número \(M\), podemos escolher \(b\) com \(E_y(T_y^+\wedge b)\gt M\); a desigualdade anterior dá \(\liminf _kR_k/k\gt M\). Como \(M\) é arbitrário, \(R_k/k\to \infty \). A mesma inversão das contagens dá \(N_n(y)/n\to 0\).
Para relacionar frequências observadas em trajetórias com probabilidades, usaremos uma estimativa elementar. Ela permitirá passar às esperanças nos casos limitados que aparecem a seguir.
Fixe \(\varepsilon \gt 0\) e defina
Os eventos \(A_N\) decrescem com \(N\). Como \(Z_n\to c\) quase certamente, a probabilidade de sua interseção é zero: fora do evento excepcional, somente um número finito dos desvios pode superar \(\varepsilon \). Pela continuidade das probabilidades para eventos decrescentes, \(\mathbb P(A_N)\to 0\). Essa propriedade decorre da aditividade enumerável, como recordado na Proposição 2.8.
Para \(n\geq N\), temos \(|Z_n-c|\leq \varepsilon \) fora de \(A_N\) e \(|Z_n-c|\leq 1\) em \(A_N\). Logo,
Primeiro escolhemos \(N\) para tornar pequena a última probabilidade; depois usamos que \(\varepsilon \) pode ser arbitrariamente pequeno. Isso prova a afirmação.
O passeio simples e simétrico em \(\mathbb Z\) é recorrente nulo. Na demonstração do Teorema 2.17, provamos sua recorrência e obtivemos \(P^n(0,0)\to 0\). Portanto,
A média na última expressão tende a zero por um argumento de somas finitas: dado \(\varepsilon \gt 0\), existe \(m_0\) tal que \(P^m(0,0)\lt \varepsilon \) para \(m\geq m_0\). Os termos anteriores a \(m_0\), divididos por \(n\), tendem a zero; os restantes contribuem no máximo \(\varepsilon \) à média.
Por outro lado, o teorema de frequência dá \(N_n(0)/n\to 1/E_0T_0^+\) quase certamente. Como essas variáveis ficam entre zero e um, o Lema 2.30 mostra que suas esperanças convergem para a mesma constante. Concluímos que \(1/E_0T_0^+=0\), isto é, \(E_0T_0^+=\infty \).
Na cadeia de Ehrenfest, a situação é diferente. O espaço é finito e a cadeia é irredutível; o Lema 2.10 limita a esperança do retorno por uma série geométrica. Seus estados são, portanto, recorrentes positivos.
Um estado com maior massa estacionária reaparece mais cedo, em média. A finitude do espaço garante a existência de alguma estacionária; em um espaço enumerável, essa existência é uma hipótese real, que exclui tanto transiência quanto recorrência nula numa cadeia irredutível.
Primeiro, \(\pi (y)\gt 0\) para todo \(y\). De fato, escolha \(z\) com \(\pi (z)\gt 0\) e um caminho de \(z\) a \(y\) em \(r\) passos. Então \(\pi (y)=(\pi P^r)(y)\geq \pi (z)P^r(z,y)\gt 0\).
Pelo Lema 2.13, recorrência ou transiência é propriedade da classe. Se a classe fosse transiente, teríamos \(P^n(x,y)\to 0\) para todo \(x\). Fixe \(\varepsilon \gt 0\) e escolha um conjunto finito \(F\subseteq S\) com \(\sum _{x\notin F}\pi (x)\lt \varepsilon \). Pela estacionariedade e por \(P^n(x,y)\leq 1\),
A soma à direita é finita e tende a zero. Portanto \(\pi (y)\leq \varepsilon \); como \(\varepsilon \) é arbitrário, teríamos \(\pi (y)=0\), uma contradição. Logo a cadeia é recorrente.
Comece agora com \(X_0\sim \pi \). A estacionariedade dá \(E_\pi [N_n(y)/n]=\pi (y)\). O teorema de frequência vale para todo estado inicial e, portanto, também para essa mistura de leis: se \(\mathcal A\) é o evento de convergência, a probabilidade total dá \(\mathbb P_\pi (\mathcal A)=\sum _x\pi (x)\mathbb P_x(\mathcal A)=1\). Como \(0\leq N_n(y)/n\leq 1\), o Lema 2.30 fornece
O lado esquerdo é positivo, logo a esperança é finita. A fórmula determina cada coordenada de qualquer distribuição estacionária, provando a unicidade.
A recíproca também vale: um tempo médio de retorno finito permite construir uma distribuição estacionária. Para isso, contamos quantas vezes cada estado aparece em uma excursão completa. Essa construção será útil novamente quando estudarmos recompensas.
Como \(E_aL\lt \infty \), o retorno ocorre em tempo finito quase certamente. Cada excursão é uma sequência finita
com comprimento \(r=r(\gamma )\geq 1\). O conjunto \(\Gamma \) dessas sequências é enumerável, pois \(S\) é finito ou enumerável. A probabilidade da excursão \(\gamma \) é
Se \(n_y(\gamma )=\sum _{m=0}^{r-1}\mathbf1_{\{ \gamma _m=y\} }\), a definição de esperança para essa distribuição enumerável dá
Em cada excursão, \(\sum _y n_y(\gamma )=r\). Reagrupando séries de termos não negativos, pela propriedade explicada na Proposição 2.8,
Também podemos reagrupar as visitas segundo o instante em que ocorrem, obtendo \(\nu (x)=\sum _{m\geq 0}\mathbb P_a(L\gt m,X_m=x)\). O evento \(\{ L\gt m\} \) é determinado pela trajetória até \(m\). Assim, a propriedade de Markov, aplicada em cada instante fixo, fornece
Todas as parcelas são não negativas; os reagrupamentos são os mesmos de séries numéricas usados acima. Em cada excursão finita, trocar a visita inicial pela final não muda a contagem, pois \(\gamma _0=\gamma _r=a\). A última expressão é, portanto, \(\nu (y)\). Concluímos que \(\nu P=\nu \). Como \(1\leq \ell \lt \infty \), dividir por \(\ell \) normaliza os pesos e produz uma distribuição estacionária.
Se existe uma distribuição estacionária, o Teorema 2.31 dá recorrência positiva de todos os estados e unicidade. Reciprocamente, se \(a\) é recorrente positivo, a Proposição 2.32 constrói uma estacionária a partir de suas excursões. Aplicando novamente o teorema do tempo médio de retorno, obtemos as demais afirmações.
2.11.2 Convergência das distribuições
Para esquecer o estado inicial em um instante distante, precisamos também eliminar oscilações impostas pelo calendário. O próximo lema explica exatamente onde a aperiodicidade entra na prova.
Podemos inserir voltas num caminho de \(x\) a \(y\). Quando os comprimentos das voltas não compartilham um divisor maior que um, essas inserções acabam preenchendo todos os tempos grandes.
Fixe um estado \(a\). Podemos escolher tempos possíveis de retorno \(r_1,\ldots ,r_j\) cujo máximo divisor comum seja \(1\). Concatenar caminhos de retorno mostra que toda soma positiva desses números com coeficientes inteiros não negativos também é um tempo possível de retorno.
Como o máximo divisor comum é \(1\), a identidade de Bézout permite escrever cada resíduo módulo \(r_1\) como uma combinação inteira de \(r_1,\ldots ,r_j\). Podemos tornar não negativos os coeficientes de \(r_2,\ldots ,r_j\) somando a eles múltiplos suficientemente grandes de \(r_1\); isso não muda o resíduo da combinação. O termo que multiplica \(r_1\) pode ser omitido. Assim, para cada resíduo \(b\), existe uma soma não negativa \(s_b\) dos tempos de retorno que tem esse resíduo.
Seja \(M\) o maior desses representantes. Todo inteiro \(n\gt M\) tem a forma \(s_b+qr_1\), com \(q\geq 0\), e portanto é um tempo possível de retorno a \(a\). Finalmente, concatene um caminho de \(x\) a \(a\), uma dessas voltas e um caminho de \(a\) a \(y\). Isso fornece a afirmação.
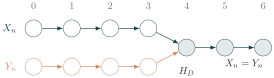
A irredutibilidade permite que duas trajetórias se encontrem; a aperiodicidade permite que o encontro ocorra no mesmo relógio. A existência de uma probabilidade estacionária impede que a massa escape para regiões cada vez mais distantes. A demonstração usa um acoplamento: uma construção conjunta de duas cadeias no mesmo espaço de probabilidade que preserva a lei de cada uma separadamente. Construiremos uma cópia iniciada em \(x\) e outra em equilíbrio; depois que elas se encontrarem, passarão a evoluir juntas.
Comece com duas cadeias independentes de matriz \(P\). A cadeia dos pares tem transição
É exatamente aqui que a aperiodicidade sincroniza os dois relógios. Pelo lema anterior, dados \((u,v)\) e \((u',v')\), existem \(n_1\) e \(n_2\) tais que
Escolhendo o mesmo \(n\geq \max \{ n_1,n_2\} \) para as duas coordenadas,
Portanto, a cadeia dos pares é irredutível. Além disso, se as duas coordenadas começam independentemente com lei \(\pi \) e usam transições independentes, ambas permanecem independentes e com lei \(\pi \). Assim, a distribuição produto, definida por \((\pi \otimes \pi )(u,v)=\pi (u)\pi (v)\), é estacionária para \(Q\). Pelo teorema do tempo médio de retorno, uma cadeia irredutível que possui essa probabilidade estacionária é recorrente positiva. Em particular, partindo de qualquer par, ela atinge qualquer par fixado, por exemplo \((a,a)\), quase certamente.
Agora tome \(X_0=x\) e \(Y_0\sim \pi \). Seja \(D=\{ (z,z):z\in S\} \) a diagonal. Até o primeiro encontro \(H_D=\inf \{ n\geq 0:X_n=Y_n\} \), evolua as duas coordenadas independentemente. Depois de \(H_D\), use a mesma transição sorteada para ambas. A construção conserva a lei de cada coordenada: \(X\) tem lei inicial \(\delta _x\) e \(Y\) permanece em equilíbrio. Antes do encontro, a lei é a da cadeia dos pares; como esta chega a \((a,a)\) em tempo finito, \(H_D\lt \infty \) quase certamente.
Se \(X_n\ne Y_n\), o encontro ainda não ocorreu. Para qualquer conjunto \(A\subseteq S\),
O último limite usa apenas a continuidade das probabilidades: os eventos \(\{ H_D\gt n\} \) decrescem para \(\{ H_D=\infty \} \), cuja probabilidade é zero. Como a cota vale para todo conjunto \(A\),
Essa é precisamente a cota de variação total que será formalizada adiante. Escolhendo \(A=\{ y\} \), obtemos o enunciado.
2.11.3 Recompensas ao longo de uma trajetória
Contar visitas corresponde a atribuir recompensa um em um estado e zero nos demais. Custos e observações gerais exigem mais cuidado: num espaço infinito, não basta somar limites de frequências sem controlar a contribuição dos estados raros.
Aperiodicidade não é necessária: médias temporais incorporam ciclos completos. A condição de integrabilidade garante que a recompensa média de uma excursão seja finita. No caso finito, toda função real satisfaz essa condição; no enumerável, ela controla precisamente a cauda que uma troca informal entre limite e soma ignoraria.
Fixe um estado \(a\) e ponha \(L=T_a^+\) para uma cadeia iniciada em \(a\). Pelo teorema do retorno, \(\ell =E_aL\lt \infty \).
1. Contagens de ocupação de uma excursão. Retome os pesos
Sua soma é \(\ell \), como mostra a Proposição 2.32. Nela, cada esperança foi escrita como uma série sobre o conjunto enumerável das excursões finitas. A mesma contagem e a propriedade de Markov em cada instante fixo dão
A última igualdade vale porque \(X_0=X_L=a\): trocar a visita inicial pela final não muda a contagem. As somas são justificadas pelos reagrupamentos de séries não negativas detalhados naquela proposição. Portanto \(\nu /\ell \) é uma distribuição estacionária; pela unicidade, \(\nu (y)=\ell \pi (y)\).
A identidade \(\nu (y)=\ell \pi (y)\) traduz a ocupação de um ciclo em equilíbrio e prepara a média temporal.
2. Recompensa por ciclo e lei forte. Seja \(B=\sum _{m=0}^{L-1}f(X_m)\) a recompensa da excursão e \(C=\sum _{m=0}^{L-1}|f(X_m)|\) sua recompensa absoluta. Ambas são finitas em cada excursão, pois \(L\lt \infty \) e \(f\) assume valores reais. Para calcular suas esperanças, use o conjunto enumerável \(\Gamma \) de excursões, suas probabilidades \(q_\gamma \) e as contagens \(n_y(\gamma )\) da Proposição 2.32. Reagrupando uma série numérica de termos não negativos,
Como \(|B|\leq C\), a recompensa \(B\) tem esperança absoluta finita. O mesmo cálculo com \(f(y)\) no lugar de \(|f(y)|\) agora é permitido pela convergência absoluta da série e dá
Nos ciclos sucessivos, os pares comprimento–recompensa são i.i.d., pela propriedade forte de Markov. Se \(L_k\) e \(B_k\) correspondem ao \(k\)-ésimo ciclo, a lei forte fornece
Assim, a recompensa acumulada nos ciclos completos, dividida pelo tempo desses ciclos, converge para a média estacionária.
3. O ciclo incompleto. Resta controlar o pedaço da trajetória que pertence ao último ciclo, ainda não encerrado. Se \(C_k\) é a recompensa absoluta do \(k\)-ésimo ciclo, a integrabilidade implica, para cada \(\varepsilon \gt 0\),
De fato, os \(C_k\) têm a mesma distribuição. Como cada \(C_k\) é função de uma excursão finita, seus valores formam um conjunto enumerável. Usando novamente séries não negativas,
A desigualdade usa apenas que a quantidade de inteiros positivos \(k\) com \(\varepsilon k\lt c\) é no máximo \(c/\varepsilon \). Pelo primeiro lema de Borel–Cantelli, quando a soma das probabilidades é finita, apenas um número finito desses eventos ocorre, quase certamente. Aplicando isso a \(\varepsilon =1,1/2,1/3,\ldots \) e reunindo os eventos excepcionais, obtemos \(C_k/k\to 0\) quase certamente.
Seja \(K(n)\) o número de ciclos completos até \(n\). Pela inversão das contagens usada no Teorema 2.29, \(K(n)/n\to 1/\ell \). A recompensa ainda não contabilizada está contida no ciclo seguinte e seu módulo é limitado por \(C_{K(n)+1}\). Além disso,
O tempo dos ciclos completos, dividido por \(n\), também tende a um, pois
Combinando essa razão com o limite das recompensas dos ciclos completos e a estimativa do resto, provamos o limite para a média até um instante arbitrário.
Partindo de \(x\ne a\), a primeira chegada a \(a\) ocorre em tempo finito quase certamente. A soma anterior a essa chegada é uma soma finita de valores reais e, dividida por \(n\), desaparece; não precisamos que o tempo dessa primeira chegada tenha esperança finita. Mudar a soma de \(m=0,\ldots ,n-1\) para \(m=1,\ldots ,n\) tampouco altera o limite: \(f(X_0)/n\to 0\), e o termo \(|f(X_n)|/n\) é limitado pela recompensa absoluta, dividida por \(n\), do ciclo que contém o instante \(n\). A estimativa anterior mostra que ele também tende a zero.
Essa média equivale a observar a cadeia em um instante escolhido uniformemente entre \(1\) e \(n\), independentemente da trajetória. Ela suaviza a oscilação de calendário, mas não afirma que a lei em cada instante convirja.
Pelo teorema ergódico aplicado a \(f=\mathbf1_{\{ y\} }\), temos \(N_n(y)/n\to \pi (y)\) quase certamente sob \(\mathbb {P}_x\). Como essa razão está entre zero e um, o Lema 2.30 garante que suas esperanças convergem para \(\pi (y)\). A esperança é exatamente \(n^{-1}\sum _{m=1}^nP^m(x,y)\).
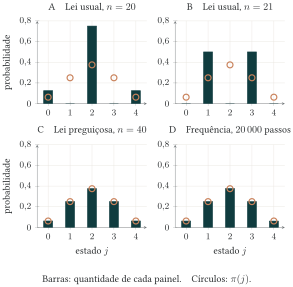
Para \(N\geq 1\), Ehrenfest tem distribuição estacionária \(\pi (j)=2^{-N}\binom Nj\) e período dois. Partindo de zero, \(X_n\) tem a mesma paridade de \(n\); logo a lei alterna entre estados pares e ímpares e não converge para \(\pi \).
Na versão preguiçosa, \(\widetilde P=(I+P)/2\): com probabilidade \(1/2\), nada muda; caso contrário, uma bola troca de urna. A mesma \(\pi \) é estacionária, e a permanência positiva torna a cadeia aperiódica. Assim, \(\widetilde P^n(x,j)\to \pi (j)\).
Nas duas versões, as frequências temporais e as médias de Cesàro convergem para \(\pi (j)\). O tempo médio de primeiro retorno também tem a mesma fórmula nas duas cadeias:
Na versão preguiçosa, permanecer em \(j\) no primeiro passo já conta como retorno; por isso não devemos simplesmente duplicar essa esperança. Com \(N=4\), os tempos médios de retorno a \(0\) e \(2\) são respectivamente \(16\) e \(8/3\) passos. A média temporal de \(X_n\) converge para \(N/2\) em ambas as versões, embora a lei de Ehrenfest usual continue oscilando.
2.12 Velocidade de convergência e espectro
Saber que uma cadeia converge não diz quanto devemos esperar. Duas dinâmicas podem ter a mesma distribuição estacionária e conservar a influência do estado inicial por tempos muito diferentes. Precisamos de uma distância entre distribuições e, depois, de uma forma de acompanhar sua redução.
O fator \(1/2\) evita contar duas vezes a massa que precisa ser redistribuída. Se \(A_+=\{ x:\mu (x)\geq \nu (x)\} \), a soma das diferenças positivas coincide com o módulo da soma das negativas. Portanto,
Assim, a distância é o maior erro na probabilidade de um mesmo evento. Aplicar uma transição comum não aumenta esse erro: a desigualdade triangular e \(\sum _y p(x,y)=1\) dão
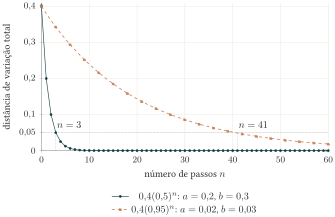
Em cadeias reversíveis, a álgebra linear torna esse mecanismo geral. Aqui restringimos a discussão a um espaço finito com pelo menos dois estados e \(\pi (x)\gt 0\) para todo \(x\). Essa positividade é essencial para que
seja um produto interno. A norma correspondente é
A matriz também atua sobre funções por \((Pf)(x)=\sum _y p(x,y)f(y)\); isso não muda a convenção de distribuições como vetores-linha.
Cada autovetor descreve uma forma de desequilíbrio, multiplicada pelo seu autovalor a cada passo. O modo constante permanece; os demais desaparecem geometricamente. Um autovalor próximo de \(-1\) também decai devagar, com alternância de sinal: importa o segundo maior módulo, não apenas o segundo maior valor.
Seja \(D\) a matriz diagonal com entradas \(\pi (x)\). O balanço detalhado mostra que a matriz \(D^{1/2}PD^{-1/2}\) é simétrica. Pelo teorema espectral para matrizes simétricas reais, ela possui uma base ortonormal de autovetores reais. Voltando às coordenadas originais, obtemos uma base de autovetores de \(P\) ortonormal para o produto interno \(\langle \cdot ,\cdot \rangle _\pi \). O teorema da convergência mostra que o único modo que não desaparece é o constante, de autovalor um; para os demais, \(|\lambda _k|\lt 1\).
A densidade da massa inicial em \(x\), relativa a \(\pi \), é \(h_0(y)=\mathbf1_{\{ y=x\} }/\pi (x)\). A reversibilidade dá \(h_n=P^nh_0\), onde \(h_n(y)=P^n(x,y)/\pi (y)\). Como \(h_0-1\) é ortogonal às constantes,
Por Cauchy–Schwarz, \(\sum _y\pi (y)|h_n(y)-1|\leq \lVert h_n-1\rVert _{2,\pi }\). Dividir por dois conclui a prova.
A existência de \(\pi \), a convergência para \(\pi \) e a velocidade dessa convergência respondem a três perguntas diferentes. A lacuna espectral absoluta, também chamada de gap espectral absoluto (absolute spectral gap), \(1-\lambda _*\), controla o decaimento do modo não constante mais lento no caso reversível. Uma distribuição inicial pode não ter componente nesse modo e convergir mais depressa. A versão preguiçosa \((I+P)/2\) transforma cada autovalor \(\lambda \) em \((1+\lambda )/2\) e elimina autovalores negativos, mas pode desacelerar modos positivos. No capítulo de MCMC, essa discussão reaparecerá como tempo de mistura e diagnóstico de simulações.
2.13 PageRank e centralidade*
Como medir a importância de uma página a partir dos links que a apontam? A pergunta começa com um grafo dirigido: escrevemos \(A_{ij}=1\) quando há um link da página \(i\) para a página \(j\), e \(A_{ij}=0\) caso contrário.
A centralidade por grau de entrada atribui a \(j\) o valor \(d_j^{\mathrm{in}}=\sum _i A_{ij}\). É uma contagem simples de referências recebidas. Sua limitação também é simples: dez links de páginas pouco citadas valem tanto quanto dez links de páginas muito citadas.
A centralidade de autovetor procura pesos não negativos \(c_j\) tais que a importância de \(j\) seja proporcional à soma das importâncias de quem a cita:
Mesmo quando existe um vetor estritamente positivo, multiplicá-lo por uma constante positiva preserva a equação. A unicidade deve, portanto, ser entendida a menos desse fator ou depois de uma normalização, como \(\sum _jc_j=1\). Sua existência e unicidade dependem de condições sobre o grafo. Há ainda outra decisão: uma página deve transmitir sua importância inteira por cada link ou repartir um total entre todos os links que oferece?
O passeio aleatório adota a segunda opção. Se \(d_i^{\mathrm{out}}=\sum _j A_{ij}\gt 0\), faça
Um visitante escolhe uniformemente um dos links da página atual. Páginas sem saída deixam uma linha por definir; classes fechadas podem aprisionar o passeio e tornar o resultado dependente do ponto de partida.
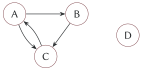
Os dados observados são as páginas e seus links em uma coleta datada; a matriz é construída dessa coleta, enquanto \(\alpha \) e \(v\) são escolhas do modelo. Se o objetivo fosse descrever navegação real, poderíamos comparar frequências de visitas em sessões reservadas com as previstas, ou estimar as transições pelos cliques observados. Links e cliques são fontes de dados distintas. A formulação original é de Page et al. (1999).
O ranking depende de \(\alpha \), da personalização em \(v\) e do tratamento das páginas sem saída. Fazendas de links tentam manipular a estrutura do grafo; teletransporte não elimina essa possibilidade. Convém comparar rankings sob escolhas próximas de parâmetros e sob novas coletas. Centralidade mede uma posição numa rede segundo um modelo: não é sinônimo absoluto de qualidade ou relevância para toda pergunta.
2.14 Otimização por colônias de formigas*
Até aqui, as probabilidades de transição foram dadas de antemão. Nos algoritmos de colônias de formigas, as próprias trajetórias modificam as escolhas futuras por meio do reforço de feromônio. Esse mecanismo aproxima cadeias de Markov, urnas reforçadas e otimização. Em uma primeira leitura, acompanhe a escolha do estado, o exemplo com dois caminhos, a cota produzida pela evaporação e a discussão sobre exploração. Os resultados de convergência mostram aonde esses modelos podem levar; suas provas antecipam martingais e processos de nascimento em tempo contínuo. Elas podem ser retomadas após os capítulos correspondentes, sem interromper agora a compreensão do algoritmo e de suas limitações.
Uma colônia de formigas pode encontrar um caminho curto entre o formigueiro e uma fonte de alimento sem que nenhuma formiga conheça o mapa completo. Cada indivíduo toma decisões locais, mas deixa no ambiente uma informação que altera as decisões dos indivíduos seguintes: o feromônio. Caminhos percorridos com frequência recebem novos depósitos; caminhos pouco usados perdem feromônio por evaporação. A combinação dessas duas regras produz uma forma simples de memória coletiva.
Os algoritmos de otimização por colônias de formigas abstraem esse mecanismo para procurar boas soluções de problemas combinatórios Dorigo et al. 1996; Dorigo e Stützle 2004. A metáfora biológica é atraente, mas o que nos interessa aqui é a estrutura probabilística: uma distribuição é usada para construir uma solução aleatória, a qualidade da solução modifica essa distribuição e o procedimento se repete. Assim, o algoritmo fornece um exemplo concreto de processo estocástico com realimentação.
2.14.1 Escolhas aleatórias guiadas pelo feromônio
Considere um grafo finito. A cada aresta \(e\) associamos duas quantidades positivas. O valor \(\tau _e(n)\) representa o feromônio presente na aresta no início da iteração \(n\), enquanto \(\eta _e\) mede sua atratividade definida pelo problema. Em uma aplicação de caminhos mínimos, é comum tomar \(\eta _e=1/\ell _e\), em que \(\ell _e\) é o comprimento da aresta.
Se uma formiga está em um vértice \(v\) e pode escolher uma aresta no conjunto \(A(v)\), a regra usual atribui a \(e\in A(v)\) a probabilidade
Aqui, \(\alpha \geq 0\) controla a influência do histórico acumulado no feromônio, e \(\beta \geq 0\) controla a influência da informação heurística. Valores grandes de \(\alpha \) tornam o algoritmo mais sensível às escolhas anteriores; valores grandes de \(\beta \) favorecem fortemente as arestas que já parecem vantajosas.
Depois que a formiga completa um caminho \(R_{n+1}\) de custo \(L(R_{n+1})\), uma regra simples de atualização é
em que \(Q\gt 0\). O fator \(1-\delta \) representa a evaporação, e o segundo termo reforça as arestas que participaram da solução construída. Como o depósito é inversamente proporcional ao custo total, soluções melhores deixam marcas mais fortes. Nas implementações com várias formigas por iteração, basta somar os depósitos produzidos por elas.
Reúna em \(U_{n+1}\) os números aleatórios usados na próxima iteração. Conhecidos \(X_n\) e \(U_{n+1}\), o procedimento determina os caminhos e a atualização dos feromônios. Podemos, portanto, escrever
com a mesma regra \(F\) em todas as iterações. Como os números em \(U_{n+1}\) são independentes do passado e têm sempre a mesma distribuição, conhecer os feromônios anteriores não acrescenta informação sobre \(X_{n+1}\) quando \(X_n\) já é conhecido. Essa é a propriedade de Markov.
Durante a construção de um caminho, a posição da formiga pode não ser um estado suficiente. No problema do caixeiro-viajante, por exemplo, também precisamos registrar as cidades já visitadas. Esse detalhe ilustra um princípio geral: a propriedade de Markov não depende apenas do fenômeno estudado, mas também da informação escolhida para formar o estado.
2.14.2 Um modelo com dois caminhos
Para enxergar o mecanismo sem a geometria de um grafo grande, suponha que existam apenas dois caminhos entre o formigueiro e o alimento, com comprimentos \(L_1\) e \(L_2\). Em cada iteração, uma formiga escolhe um dos caminhos por inteiro. Denotando essa escolha por \(J_{n+1}\in \{ 1,2\} \), escrevemos \(\mathcal H_n\) para o histórico da colônia até a iteração \(n\), incluindo os feromônios e as escolhas já realizadas. Estudaremos a regra
e a atualização
Esse é o caso \(\alpha =1\) e \(\beta =0\). A simplificação retira a preferência explícita pelo comprimento da regra de escolha. Mesmo assim, o comprimento entra no algoritmo por meio do reforço \(q_i\): uma passagem pelo caminho menor produz um depósito maior.
O próximo resultado mostra que a evaporação impede o crescimento ilimitado do feromônio.
Da regra de atualização e do fato de que o indicador é no máximo um,
Iterando essa desigualdade e somando a progressão geométrica, obtemos (2.13).
A fórmula também esclarece o papel de \(\delta \). Um depósito feito \(k\) iterações antes é multiplicado por \((1-\delta )^k\), aproximadamente \(e^{-\delta k}\) quando \(\delta \) é pequeno. Assim, \(1/\delta \) fornece uma escala aproximada para o alcance da memória do algoritmo.
2.14.3 Sem evaporação: reaparece a urna de Pólya
Primeiro suponha que os dois caminhos recebam o mesmo reforço \(q\gt 0\) e que não haja evaporação. Temos então
Dividindo todas as quantidades por \(q\), recuperamos uma urna de Pólya: quando as quantidades iniciais divididas por \(q\) são inteiras, escolher o caminho \(i\) corresponde a retirar uma bola da cor \(i\), devolvê-la e acrescentar outra da mesma cor. Para valores iniciais positivos não inteiros, a mesma regra usa massas de cada cor em lugar de números de bolas; a escolha é proporcional à massa e o reforço acrescenta uma unidade.
Feromônio como uma urna de Pólya Defina
No modelo sem evaporação e com reforços iguais, \((Z_n)_{n\geq 0}\) é um martingal limitado. Portanto, existe uma variável aleatória \(Z_\infty \) tal que \(Z_n\to Z_\infty \) quase certamente.
Mais precisamente, se \(\tau _1(0)=aq\) e \(\tau _2(0)=bq\), com \(a,b\gt 0\), então
Em particular,
Escreva \(S_n=\tau _1(n)+\tau _2(n)\) e \(Z_n=\tau _1(n)/S_n\). Se o caminho 1 é escolhido, o novo valor da proporção é \((\tau _1(n)+q)/(S_n+q)\); caso contrário, é \(\tau _1(n)/(S_n+q)\). Como a probabilidade da primeira alternativa é \(Z_n\),
Logo, \((Z_n)\) é um martingal. Como \(0\leq Z_n\leq 1\), o Teorema ?? garante a convergência quase certa.
A identificação da distribuição limite é o resultado clássico da urna de Pólya. Para verificá-la, considere uma sequência particular com \(r\) escolhas do caminho 1 e \(s\) escolhas do caminho 2. Sua probabilidade é
em que \((c)_k=c(c+1)\cdots (c+k-1)\). A expressão depende apenas de \(r\) e \(s\), e coincide com a probabilidade obtida sorteando primeiro \(p\sim \operatorname {Beta}(a,b)\) e realizando, condicionado a \(p\), escolhas de Bernoulli independentes. Para ligar essa representação ao limite, escreva
Condicionado a cada valor de \(p\), a lei forte dos grandes números dá \(N_1(n)/n\to p\) quase certamente e, portanto, \(Z_n\to p\). Como todas as sequências finitas de escolhas têm as mesmas probabilidades nos dois modelos, essa representação identifica a distribuição de \(Z_\infty \) como \(\operatorname {Beta}(a,b)\).
Esse resultado contém uma surpresa importante. Se \(a=b=1\), então \(Z_\infty \) é uniforme em \([0,1]\). Embora os caminhos sejam perfeitamente simétricos, a proporção de feromônio não converge necessariamente a \(1/2\). Flutuações ocorridas no início podem ser preservadas indefinidamente pelo reforço. Por exemplo,
Simetria das regras implica simetria da distribuição dos resultados, mas não obriga cada execução a terminar em uma configuração simétrica.
2.14.4 Quando um caminho é menor
Voltemos aos reforços \(q_i=Q/L_i\), ainda sem evaporação. Suponha que \(L_1\lt L_2\); equivalentemente, \(q_1\gt q_2\). Agora o caminho 1 recebe mais feromônio toda vez que é percorrido.
Condicionado ao passado, a escolha do caminho 1 produz o incremento
enquanto a escolha do caminho 2 produz
Multiplicando esses incrementos pelas probabilidades \(Z_n\) e \(1-Z_n\), obtemos (2.14). Como a função \(q\mapsto q/(S_n+q)\) é crescente, a deriva é positiva quando \(q_1\gt q_2\) e \(0\lt Z_n\lt 1\).
A positividade da deriva diz mais do que uma preferência média em uma única etapa. A teoria das urnas reforçadas permite identificar o comportamento assintótico completo; uma visão geral dessa teoria pode ser encontrada em Pemantle 2007.
O processo pode ser inserido em tempo contínuo. Para \(i=1,2\), considere um processo de nascimento puro \(Y_i(t)\) que, quando está no estado \(y\), salta para \(y+q_i\) a uma taxa igual a \(y\). Tome os dois processos independentes. Dado o estado atual \((y_1,y_2)\), a probabilidade de o próximo salto pertencer ao primeiro processo é \(y_1/(y_1+y_2)\). Consequentemente, a sequência conjunta observada nos instantes de salto tem a mesma lei que \((\tau _1(n),\tau _2(n))\).
Podemos comparar os dois crescimentos sem um teorema de convergência de martingais. Se \(Y_i(0)=y_i\gt 0\), o instante do \(k\)-ésimo salto do processo \(i\) pode ser escrito como
onde os \(E_{i,m}\) são independentes e exponenciais de taxa 1. Somas harmônicas e séries de quadrados dão
Para \(k=2^j\), Chebyshev mostra que a probabilidade de \(|T_{i,2^j}-E T_{i,2^j}|\gt \varepsilon j\) é no máximo \(C_i/(\varepsilon ^2j^2)\). Borel–Cantelli, aplicado a uma sequência de \(\varepsilon \) racionais positivos, dá \(T_{i,2^j}/\log (2^j)\to 1/q_i\) quase certamente. Como \(T_{i,k}\) é crescente, o mesmo limite vale para todos os \(k\). Em particular, não há explosão e, invertendo a relação entre tempo e número de saltos,
Se \(q_1\gt q_2\), então \(t^{-1}\log (Y_2(t)/Y_1(t))\to q_2-q_1\lt 0\); logo \(Y_2(t)/Y_1(t)\to 0\). A sequência conjunta dos saltos tem tempos que tendem a infinito, e sua proporção de feromônio no caminho 1 é \(Z_n=Y_1/(Y_1+Y_2)\) nesses instantes. Portanto \(Z_n\to 1\).
A mesma estimativa fornece a ordem da velocidade em escala logarítmica:
De fato, até o tempo \(t\) houve \((Y_i(t)-y_i)/q_i\) saltos do processo \(i\); como \(Y_2(t)/Y_1(t)\to 0\), o número total \(n(t)\) de saltos satisfaz \(\log n(t)/t\to q_1\). Por outro lado, \(t^{-1}\log (1-Z_{n(t)})\to q_2-q_1\). Como \(q_i=Q/L_i\), o expoente é \(1-L_1/L_2\). Quando os comprimentos são muito próximos, a distinção entre os caminhos pode ser lenta. Esse fenômeno aparece com frequência em otimização: soluções quase equivalentes exigem muitas amostras para serem separadas de modo consistente.
O caminho mais longo continua sendo usado infinitas vezes quase certamente. Na representação em tempo contínuo, o segundo processo também realiza infinitos saltos; sua quantidade de feromônio apenas cresce em uma ordem menor. Assim, a fração das escolhas correspondentes ao caminho 2 converge a zero, embora o número total dessas escolhas cresça sem limite.
2.14.5 Exploração e concentração prematura
O teorema anterior favorece o caminho correto no modelo idealizado, mas também expõe um risco dos algoritmos reforçados. Se uma solução recebe muito feromônio por acaso nas primeiras iterações, sua probabilidade pode crescer antes que outras regiões tenham sido suficientemente exploradas. Além disso, a evaporação, sozinha, não garante exploração: o feromônio de um caminho nunca escolhido pode decair para valores próximos de zero.
Uma proteção comum consiste em restringir o feromônio a um intervalo \([\tau _{\min },\tau _{\max }]\), com \(0\lt \tau _{\min }\lt \tau _{\max }\lt \infty \). Depois de aplicar (2.10), valores abaixo ou acima desses limites são truncados.
Como o numerador é pelo menos \(\tau _{\min }\) e o denominador é no máximo \(2\tau _{\max }\), obtemos a cota uniforme. Condicionado a qualquer história, a probabilidade de evitar o caminho \(i\) durante as próximas \(r\) escolhas é no máximo \((1-\varepsilon )^r\). Fazendo \(r\to \infty \), concluímos que a probabilidade de nunca mais escolher esse caminho é zero. Como isso vale após qualquer instante, o caminho é escolhido infinitas vezes quase certamente.
Os limites fixos preservam a exploração, mas alteram o comportamento assintótico. Com eles,
de modo que o teorema de seleção do caminho menor, provado sem truncamento, não se aplica a essa nova regra. O caso sem evaporação torna a diferença particularmente clara: cada visita acrescenta \(q_i\gt 0\) até atingir \(\tau _{\max }\). Como cada caminho é visitado infinitas vezes, ambos os feromônios atingem esse teto em tempo finito quase certamente. A partir daí, as escolhas têm probabilidade \(1/2\), mesmo que os comprimentos sejam diferentes.
Com evaporação, o feromônio pode diminuir entre depósitos e deixar de ficar preso ao teto. Ainda assim, a proposição garante exploração, não seleção do ótimo. O reforço favorece as decisões recompensadas, enquanto os limites impedem que as demais sejam abandonadas. Essa tensão é uma versão do compromisso entre exploração e aproveitamento que aparece em aprendizado de máquina e em algoritmos sequenciais de decisão.
2.14.6 Uma aplicação em ciência de dados: seleção de variáveis
Suponha que um conjunto de dados possua variáveis preditoras \(x_1,\ldots ,x_d\), mas que desejemos ajustar o modelo usando apenas um subconjunto delas. Essa escolha pode ser representada por um caminho em um grafo com \(d\) etapas. Na etapa \(j\), a formiga toma uma decisão binária: incluir ou excluir \(x_j\). Ao final do percurso, obtemos um vetor
e o subconjunto \(S(z)=\{ j:z_j=1\} \).
Associamos um feromônio \(\tau _{j,1}\) à decisão de incluir \(x_j\) e um feromônio \(\tau _{j,0}\) à decisão de excluí-la. A regra (2.9) torna-se
A informação heurística \(\eta _{j,1}\) pode incorporar, por exemplo, uma medida simples de associação entre \(x_j\) e a variável resposta, calculada apenas com os dados de treinamento e transformada para permanecer estritamente positiva. Também podemos tomar todas as heurísticas iguais a um, deixando que a avaliação dos subconjuntos oriente sozinha o processo.
Para avaliar o caminho, ajustamos o modelo escolhido usando apenas as variáveis de \(S\) e calculamos um custo de validação. Uma possibilidade é
em que \(\widehat R_{\mathrm{val}}(S)\) é o erro de validação e \(\lambda \geq 0\) penaliza conjuntos grandes. As decisões pertencentes ao caminho recebem então um depósito proporcional a
com \(\varepsilon \gt 0\) apenas para evitar divisão por zero. Subconjuntos que combinam bom desempenho preditivo e baixa complexidade deixam mais feromônio nas decisões que os compõem, favorecendo sua repetição quando \(\alpha \gt 0\).
Convém separar os dados usados para treinar os modelos, os usados para orientar a seleção e os reservados para a avaliação final. Como a busca consulta repetidamente o erro de validação, o subconjunto escolhido pode se adaptar também a particularidades desses dados. Por isso, o erro usado na seleção não deve ser apresentado como uma avaliação independente do modelo final. Um conjunto de teste separado, consultado apenas ao final, permite essa avaliação; outra opção é a validação cruzada aninhada, que repete toda a seleção nas divisões internas e avalia o resultado nas divisões externas.
Nesse exemplo, o algoritmo de formigas não ajusta diretamente os coeficientes do classificador ou da rede. Ele organiza uma busca aleatória no espaço de subconjuntos, enquanto o procedimento usual de treinamento avalia cada solução proposta. A mesma construção pode procurar hiperparâmetros ou arquiteturas de redes neurais: cada camada do grafo representa uma escolha, como profundidade, largura ou função de ativação, e cada caminho completo representa uma configuração. Como cada avaliação pode exigir um treinamento caro, o equilíbrio entre explorar novas configurações e concentrar recursos nas escolhas promissoras se torna especialmente relevante.
Os resultados anteriores continuam informativos nesse novo espaço. O vetor com os \(2d\) níveis de feromônio é o estado da cadeia observada entre iterações, desde que o procedimento de avaliação seja fixo e sua eventual aleatoriedade seja renovada independentemente a cada execução. A evaporação controla o alcance da memória. Com limites inferior positivo e superior finito para todos os feromônios, heurísticas fixas estritamente positivas e parâmetros \(\alpha ,\beta \) fixos e não negativos, cada decisão de incluir ou excluir tem probabilidade uniformemente positiva. Como há apenas \(d\) decisões por candidato, o mesmo vale para cada subconjunto completo: nenhum deles é abandonado para sempre se as iterações prosseguirem indefinidamente. Isso garante exploração, mas não estende ao problema geral o teorema de seleção do menor entre dois caminhos. O algoritmo pode, assim, ser interpretado como um amostrador adaptativo: a distribuição usada para gerar o próximo candidato é atualizada pela qualidade dos candidatos já observados.
O modelo real de colônia de formigas possui muitas variações: várias formigas podem trabalhar na mesma iteração, apenas a melhor solução pode depositar feromônio, uma busca local pode melhorar os caminhos encontrados e os parâmetros podem variar com o tempo. Mesmo na versão de dois caminhos, porém, já aparecem quatro ideias centrais: a escolha do estado de uma cadeia de Markov, a memória produzida pelo reforço, a convergência de martingais e a transformação de flutuações aleatórias em decisões coletivas.
2.15 Exercícios
Os primeiros problemas trabalham a escolha do estado e as contas de transição. Os seguintes combinam classificação, equilíbrio, saída e reinício em um tempo de parada; os dois últimos pedem interpretar uma soma ao longo da trajetória.
2.16 Exercícios complementares*
Os exercícios desta seção retomam apenas os temas marcados com asterisco.